





Imaginez un petit assistant intégré à votre boutique en ligne. Un client lui demande : « Quel est le stock de REF-000 ? » Au lieu de parcourir le catalogue, il attend une réponse immédiate, dans une phrase qu'il comprend.
Côté développement web, le besoin vous est probablement familier : récupérer une référence, interroger une base et afficher un résultat. Nous allons conserver cette mécanique, mais confier à un modèle de langage la transformation de la question en demande structurée.
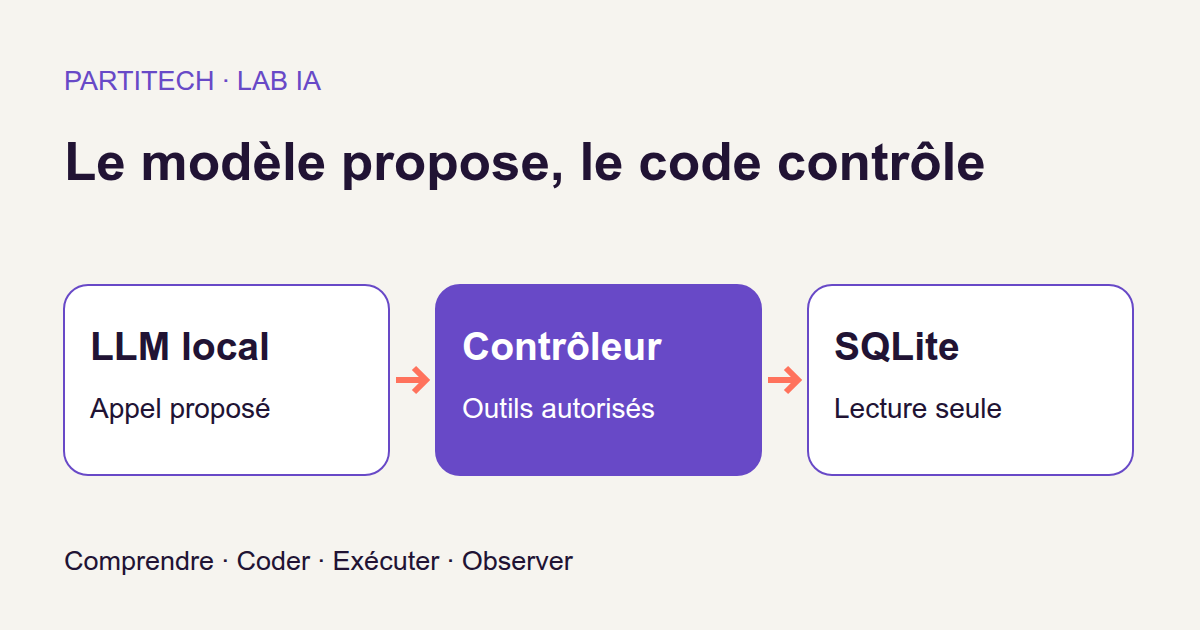
Le point important tient en une phrase : le modèle propose une action, mais votre code décide s'il a le droit de l'exécuter. Il ne reçoit ni un terminal, ni la possibilité d'écrire du SQL libre. Et même lorsqu'il dispose de la bonne donnée, nous allons vérifier ce qu'il en fait dans sa réponse.
Dans ce tutoriel, nous construisons un agent local capable de consulter des produits et leur stock. Nous suivrons le trajet d'une question, lirons les fonctions qui contrôlent les accès, puis exécuterons le projet et ses tests. Pas besoin de connaître les mathématiques des modèles de langage : savoir lire du Python, manipuler du JSON et utiliser un terminal suffit pour suivre le parcours.
Télécharger le projet complet du tutoriel.
L'archive contient le projet à reproduire. Les fichiers du modèle, aussi appelés ses poids, ne sont pas inclus : ils seront téléchargés à une révision précise et vérifiés pendant l'installation. Nous utiliserons le parcours R3, qui désigne ici la version du projet présentée et testée.
Ce que nous construisons
Du formulaire web à la question en langage naturel
Dans une interface classique, l'utilisateur saisit une référence dans un champ. Votre application vérifie cette valeur, consulte la base et affiche le stock.
Ici, l'utilisateur écrit une phrase. Le LLM, pour Large Language Model ou « grand modèle de langage », génère une proposition qui permet à notre programme de retrouver une demande structurée. Nous ne lui demandons pas de mémoriser le catalogue ou de deviner la quantité disponible : la base reste la source de vérité.
Dans ce projet, un outil est une opération que notre code accepte d'effectuer pour le modèle. Il ne s'agit pas d'un programme que le modèle invente à la volée. Nous avons prévu deux noms d'outils : rechercher_produit et consulter_stock.
Pour la question « Quel est le stock de REF-000 ? », voici un exemple de proposition conforme au contrat. Il illustre le format attendu ; ce n'est pas une transcription d'une sortie mesurée :
{
  "outil": "consulter_stock",
  "arguments": {
    "ref": "REF-000"
  }
}
Ce JSON se lit simplement : « Je souhaite utiliser l'outil consulter_stock avec la référence REF-000. » Pour un développeur web, cela ressemble au corps d'une requête envoyé à une API. Et comme pour une API, recevoir une demande ne signifie pas devoir l'accepter.
Le trajet complet d'une question
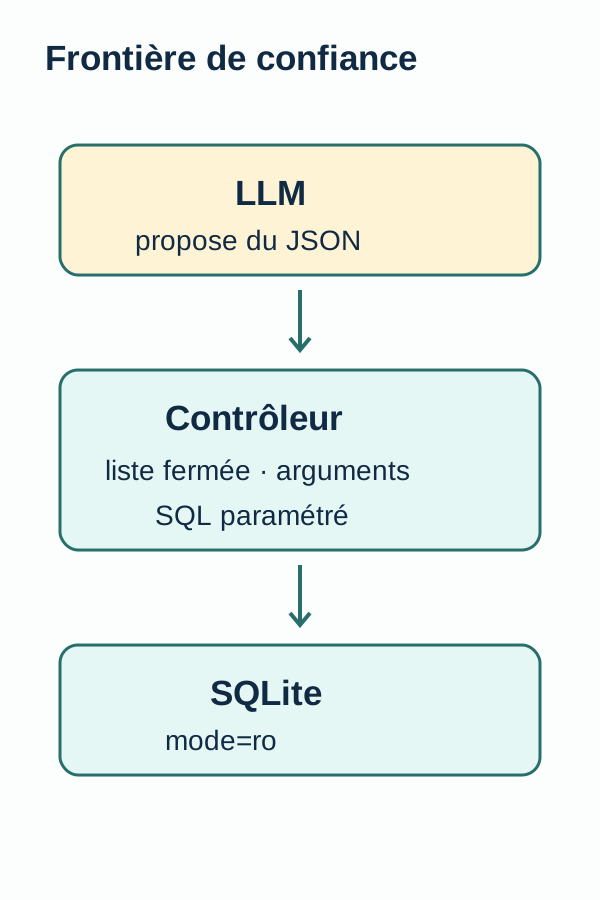
Le modèle propose cet appel. La fonction toolcall() vérifie ensuite le nom de l'outil et ses arguments. Si la demande est autorisée, une requête SQL écrite par le développeur consulte la base. Son résultat devient une observation : c'est la donnée effectivement lue, sous une forme structurée.
Cette observation est enfin transmise au modèle pour qu'il formule une réponse courte. Nous avons donc trois choses différentes à examiner : la demande proposée, la donnée récupérée et la phrase finale. Cette séparation nous permettra de comprendre où se situe une éventuelle erreur.
Nous parlons ici d'agent parce que le modèle propose l'utilisation d'un outil. Mais le parcours reste volontairement limité : une proposition, un appel d'outil au maximum, puis une reformulation. Il ne comporte pas de boucle dans laquelle le modèle enchaînerait des actions jusqu'à décider de s'arrêter.
Le modèle propose ; le contrôleur autorise
Traiter le JSON comme une entrée externe
Un modèle de langage produit du texte. Un prompt est l'instruction qu'on lui fournit pour orienter cette production. Lui demander « utilise seulement ces deux outils » est utile, mais cette phrase ne remplace pas un contrôle dans le programme.
Pensez à un formulaire dont le navigateur désactive le bouton « Supprimer ». Vous ne supprimeriez pas pour autant la vérification côté serveur. Nous appliquons la même logique aux propositions du modèle : elles doivent passer par le code qui fait autorité.
Dans agent.py, la fonction run() demande un objet contenant outil et arguments. Elle décode le JSON, le transmet à toolcall(), puis utilise l'observation obtenue pour demander la réponse finale.
La décision d'autoriser ou de refuser se trouve dans tools.py. Son contrat est précis :
- Le nom de l'outil doit être
rechercher_produitouconsulter_stock, les seuls noms de la liste autorisée, aussi appelée allowlist. - L'objet principal doit contenir exactement
outiletarguments. Dansarguments, seule la clérefest acceptée. - La référence doit être une chaîne correspondant à
REF-[0-9]{3}: le préfixeREF-, suivi de trois chiffres, sans autre caractère.
Ainsi, REF-000 respecte le format. REF-12, ref-000 ou une référence suivie d'une instruction supplémentaire ne le respectent pas. Une clé ajoutée « au cas où » n'est pas ignorée : elle fait refuser la demande.
Dans cette version, les deux noms d'outils autorisés conduisent à la même lecture des colonnes ref, name et stock. rechercher_produit ne désigne donc pas une recherche libre dans le catalogue : il reçoit lui aussi une référence exacte.
Pourquoi ne pas laisser le modèle écrire la requête SQL ?
Parce que notre besoin ne l'exige pas. Nous savons déjà quelle table et quelles colonnes consulter. Le modèle n'a qu'une valeur à proposer : la référence.
La requête est fixée dans le code : SELECT ref,name,stock FROM products WHERE ref=?. Le ? est un emplacement réservé ; la référence est transmise séparément comme paramètre. Elle est traitée comme une donnée, pas comme un morceau de SQL à exécuter. C'est le principe des requêtes paramétrées documentées par Python.
Le modèle ne choisit donc ni la table, ni les colonnes, ni une commande à lancer. Aucun chemin de ce parcours ne lui permet d'exécuter une commande shell libre ou du SQL qu'il aurait produit.
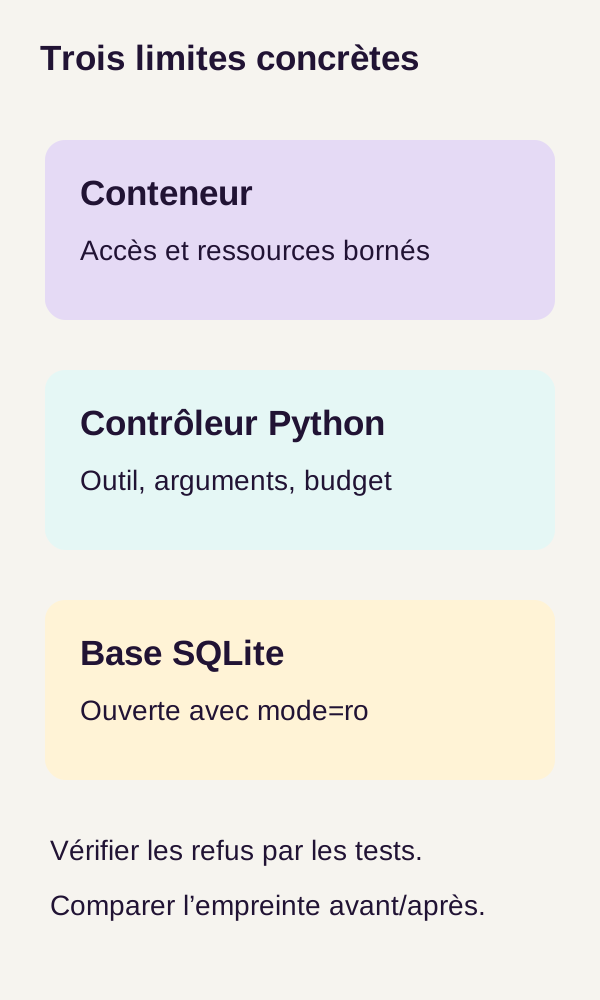
Une seconde limite intervient au niveau de la base : la connexion SQLite est ouverte en lecture seule avec mode=ro. Les tentatives d'écriture par cette connexion doivent échouer, même si elles sont faites en dehors de notre requête de consultation.
Attention au compteur d'appels
toolcall() reçoit aussi un paramètre count. Il accepte les valeurs entières 0, 1 et 2, puis refuse 3. Les compteurs négatifs ou d'un autre type sont également refusés.
Ce paramètre ne constitue pas un quota qui se souvient tout seul des appels précédents. Dans notre parcours, run() appelle l'outil une seule fois, avec la valeur initiale. Si vous ajoutez ensuite une boucle, le code qui appelle toolcall() devra incrémenter le compteur. Appeler la fonction plusieurs fois en laissant systématiquement count=0 ne consomme aucun budget mémorisé.
Les données, les limites et les concepts
Un stock à zéro n'est pas un produit introuvable
Le fichier data/products.json contient 60 produits et 30 requêtes. La première question, d'identifiant 0, est exactement : « Quel est le stock de REF-000 ? »
Dans les données, REF-000 correspond à « Produit 0 », dont le stock vaut 0. À partir de cette fiche et du code de lecture, l'observation attendue est :
{
  "ref": "REF-000",
  "name": "Produit 0",
  "stock": 0
}
Le produit existe. Il est simplement épuisé.
Trois requêtes du jeu de données portent au contraire sur REF-999, qui n'existe pas dans la base. Dans ce cas, l'outil retourne { "found": false }.
La différence est importante : zéro est une valeur connue ; « introuvable » est une absence de résultat. Pour une boutique, ces situations ne conduisent pas au même message. « Nous n'en avons plus en stock » ne signifie pas « nous ne connaissons pas cette référence ».
Remarquez aussi que REF-999 respecte le format autorisé. Le contrôleur peut donc accepter sa consultation sans que la base contienne un produit correspondant. Valider la forme d'une référence et vérifier son existence sont deux étapes différentes.
Vérifier que la base n'a pas changé
Le programme calcule une empreinte SHA-256 du fichier de base avant et après les 30 demandes, puis exige que les deux valeurs soient identiques. Une empreinte est une valeur calculée à partir du contenu d'un fichier ; Python fournit notamment SHA-256 dans son module hashlib.
Pour notre expérience, c'est un contrôle avant/après : nous voulons consulter les produits, pas modifier les données. Une différence d'empreinte signalerait que le fichier n'est plus identique.
Ce contrôle ne remplace pas la lecture seule. Il compare deux états ; il ne décrit pas toutes les actions réalisées entre les deux et ne dit pas qui a consulté les données. Nous l'utilisons en complément des restrictions et des tests de refus.
Pourquoi ajouter des protections Docker ?
Le projet combine trois niveaux de contrôle : l'environnement d'exécution, la validation Python et la connexion SQLite.
Le conteneur d'application possède un système de fichiers en lecture seule. Ses capacités Linux, c'est-à-dire des privilèges système particuliers, sont retirées. L'option no-new-privileges interdit au processus de gagner de nouveaux privilèges lors de l'exécution d'autres programmes. Un tmpfs, espace temporaire en mémoire, est limité. L'application utilise un réseau Docker interne ; les montages du modèle et des données sont en lecture seule selon leur rôle.
Ces mécanismes réduisent ce que l'application peut faire dans son environnement. Ils ne remplacent pas le contrôle des outils. Pour approfondir les options concernées, consultez la référence des services Docker Compose.
« Lecture seule » ne signifie pas non plus que l'expérience ne produit aucun résultat : le projet prévoit le répertoire outputs/ pour ses sorties. Ce que nous protégeons ici, notamment, c'est la base consultée par l'agent.
Le modèle réellement utilisé
Nous utilisons Qwen2.5-7B-Instruct-GGUF, variante q4, servie par llama.cpp sur le réseau Docker interne.
Pour décoder ce nom : 7B désigne un modèle d'environ sept milliards de paramètres ; Instruct indique une variante préparée pour suivre des instructions ; GGUF est le format des fichiers chargés par le moteur. La variante Q4_K_M est une version quantifiée : elle représente les poids avec une précision réduite pour diminuer leur encombrement. Ces éléments sont documentés dans le dépôt officiel du modèle.
Le modèle et le moteur n'ont pas le même rôle : Qwen fournit les poids ; llama.cpp les charge et exécute les générations. Notre application Python lui envoie ses demandes. Cette utilisation d'un modèle déjà entraîné s'appelle l'inférence. Nous n'entraînons pas le modèle dans ce tutoriel.
Le parcours R3 fixe la révision du dépôt à bb5d59e06d9551d752d08b292a50eb208b07ab1f. Les deux fichiers GGUF sont également verrouillés par leur SHA-256 dans configs/models.lock.json. L'objectif est de retrouver les mêmes fichiers, pas de télécharger automatiquement une version plus récente.
La fonction generate() utilise temperature=0, seed=42 et max_tokens=100. La température règle la part d'aléatoire dans la génération ; la graine fixe un paramètre du générateur aléatoire ; max_tokens borne la longueur de sortie en unités de texte appelées tokens, qui ne correspondent pas nécessairement à des mots entiers. Un schéma JSON strict contraint aussi la première génération. Le serveur llama.cpp documente les réglages de génération et les sorties contraintes par schéma.
Ces réglages décrivent précisément l'expérience. Ils ne prouvent ni que le modèle choisira toujours la bonne référence, ni que sa phrase finale sera toujours exacte. C'est justement pour cela que nous conservons les observations et mesurons les résultats.
Les fonctions centrales à lire avant l'exécution
Commençons par le cœur du programme. Les extraits suivants reprennent la logique du code R3, avec une mise en forme plus aérée. Ce ne sont pas des fichiers autonomes : les imports, constantes et autres fonctions se trouvent dans le projet téléchargeable.
Trois fonctions préparent le terrain. create() crée une base neuve et refuse d'écraser un fichier existant. readonly() ouvre la connexion en lecture seule. digest() lit les octets du fichier et calcule son empreinte SHA-256. C'est pourquoi une nouvelle expérience commence dans une extraction neuve de l'archive.
toolcall() : le passage obligé avant la base
def toolcall(db, call, count=0):
    if type(count) is not int or not 0 <= count < 3:
        raise ValueError("Budget d’appels épuisé ou invalide")

    if (
        not isinstance(call, dict)
        or set(call) != {"outil", "arguments"}
        or call["outil"] not in TOOLS
    ):
        raise ValueError("Outil interdit ou appel mal formé")

    args = call["arguments"]
    if (
        not isinstance(args, dict)
        or set(args) != {"ref"}
        or not isinstance(args["ref"], str)
        or not re.fullmatch("REF-[0-9]{3}", args["ref"])
    ):
        raise ValueError("Référence ou arguments invalides")

    row = db.execute(
        "SELECT ref,name,stock FROM products WHERE ref=?",
        (args["ref"],),
    ).fetchone()

    return (
        {"found": False}
        if row is None
        else dict(zip(("ref", "name", "stock"), row))
    )
Lisez cette fonction de haut en bas : tant que les contrôles ne sont pas passés, la requête SQL n'est pas atteinte.
D'abord, le compteur. Le test type(count) is not int exige un entier Python exact. Pourquoi ne pas accepter simplement tout ce qui ressemble à un entier ? Parce qu'en Python, les booléens sont un sous-type des entiers : True peut se comporter comme 1. La documentation de Python sur les booléens explique cette particularité. Ici, un booléen ne constitue pas un compteur valide.
Ensuite, l'enveloppe de la demande. call doit être un dictionnaire. set(call) récupère l'ensemble de ses clés : la comparaison exige exactement outil et arguments, sans clé manquante ni supplémentaire. TOOLS contient les noms autorisés.
Puis, les arguments. La même logique s'applique à args, qui doit contenir uniquement ref. re.fullmatch() vérifie la référence entière, et pas seulement le début de la chaîne.
Enfin, la lecture. fetchone() récupère une ligne ou renvoie None lorsqu'aucun produit ne correspond. La dernière instruction retourne alors soit { "found": false }, soit un dictionnaire associant les colonnes ref, name et stock à leurs valeurs. zip() réalise cette association avant que dict() ne construise le dictionnaire.
Aucune de ces étapes ne demande au modèle de décider lui-même de ses permissions. Les règles vivent dans le programme.
readonly() : faire appliquer la lecture seule par SQLite
def readonly(path):
    return sqlite3.connect(
        Path(path).resolve().as_uri() + "?mode=ro",
        uri=True,
    )
Path(path).resolve().as_uri() transforme le chemin du fichier en URI. Le suffixe ?mode=ro demande une ouverture en lecture seule, et uri=True indique à Python d'interpréter cette notation. Le comportement de mode=ro est décrit dans la documentation officielle de SQLite.
Ce n'est donc pas seulement une convention du type « nous promettons de ne faire que des SELECT ». La connexion impose elle-même la restriction. Les tests négatifs tenteront une écriture après cette ouverture et vérifieront qu'elle échoue.
run() : relier la question, l'outil et la réponse
def run(db, query):
    start = time.perf_counter()
    proposal = generate(
        query["query"],
        SCHEMA,
        system="Choisis un outil en JSON. Outils autorisés: rechercher_produit(ref), consulter_stock(ref).",
    )
    trace = []
    answer = None
    error = None

    try:
        if proposal["finish_reason"] != "stop":
            raise ValueError("Proposition tronquée")

        call = json.loads(proposal["raw"])
        observation = toolcall(db, call)
        trace.append({"call": call, "observation": observation})

        answer = generate(
            query["query"] + "\nObservation outil: " + json.dumps(observation),
            system="Réponds uniquement avec le stock observé, ou introuvable. Ne devine pas.",
        )
    except (ValueError, TypeError, KeyError) as exc:
        error = str(exc)

    return {
        **query,
        "proposal": proposal,
        "trace": trace,
        "answer": answer,
        "error": error,
        "seconds": time.perf_counter() - start,
    }
La fonction appelle generate() deux fois, mais pour deux tâches différentes. Le premier appel demande un outil au format JSON. Le second demande une phrase fondée sur l'observation renvoyée par cet outil.
Entre les deux, finish_reason doit valoir stop. Dans ce parcours, toute autre valeur fait refuser la proposition avant le contrôleur. Ce contrôle ne suffit pas à valider le contenu : json.loads() doit encore décoder le texte, puis toolcall() doit accepter la demande. Si cette dernière est refusée, la seconde génération n'est pas lancée.
trace garde l'appel effectivement exécuté et la donnée lue. proposal conserve la proposition initiale, tandis que error reçoit le message des exceptions capturées. Au retour, **query reprend les champs de la question d'origine ; seconds mesure la durée de la séquence depuis le début de la fonction.
Un détail à relever dans cet extrait : le premier generate() se trouve avant le bloc try. Ce bloc ne capture ensuite que ValueError, TypeError et KeyError. Il ne faut donc pas interpréter error comme une garantie de journalisation de toutes les pannes possibles, notamment au premier appel. C'est une limite visible à la lecture du code, pas un incident supplémentaire observé pendant les essais.
Enfin, evaluate() vérifiera deux choses distinctes : l'exactitude de l'observation et la présence d'un marqueur attendu dans la réponse. Nous verrons pourquoi ces deux contrôles n'ont pas la même force.
Prérequis et exécution
Nous pouvons maintenant lancer le projet en sachant ce que nous cherchons à observer.
La reproduction vérifiée utilise Linux x86_64, Docker/Compose, un pilote NVIDIA et NVIDIA Container Toolkit, sur une RTX 3090. Le README prévoit 12 Gio de RAM, 15 Gio libres sur le disque du projet et le stockage Docker, ainsi que 10 Gio de VRAM libre. La VRAM est la mémoire de la carte graphique, distincte de la RAM de la machine. Ces ressources sont des provisions conservatrices, pas des minima mesurés. Aucun mode CPU n'est validé dans ce parcours.
NVIDIA Container Toolkit permet au conteneur d'accéder à la carte sélectionnée et aux bibliothèques du pilote. Un GPU visible sur l'hôte n'est pas nécessairement utilisable depuis Docker : c'est ce que le contrôle préalable, ou préflight, va vérifier. Le script ne modifie pas votre système. Pour les prérequis d'installation, la référence est la documentation NVIDIA Container Toolkit.
Extrayez le ZIP dans un répertoire neuf, puis placez-vous dans le dossier qui contient compose.yaml. Toutes les commandes suivantes se lancent depuis cette racine.
Pour vous repérer : app exécute le code Python ; server charge le modèle avec llama.cpp ; models/ conserve les poids téléchargés ; outputs/ reçoit les résultats. Nous allons préparer l'environnement, acquérir le modèle, puis exécuter et évaluer les demandes.
1. Valider l'environnement et construire l'image
Avant toute génération, vérifions l'accès au GPU depuis Docker. Le script de configuration et la construction des images préparent ensuite l'environnement du projet.
./scripts/preflight.sh
sh scripts/setup.sh
docker compose build
Ce que vous devez observer : aucune erreur de préflight ni de build. Si nvidia-smi fonctionne sur l'hôte mais que le préflight échoue dans Docker, l'environnement n'est pas encore prêt pour ce tutoriel.
2. Acquérir le modèle et exécuter les tests publics
Le téléchargement place les fichiers dans models/ après vérification de leur taille et de leur SHA-256. Internet est nécessaire au build et à cette acquisition ; les générations utilisent ensuite les fichiers locaux.
docker compose --profile acquisition run --rm --no-deps fetch
docker compose run --rm --no-deps app -m unittest discover -s tests -v
Ce que vous devez observer : 14 tests réussis. Ces tests vérifient le contrat des outils et les entrées interdites avant toute requête au serveur de modèle. Nous contrôlons ainsi les règles du programme sans dépendre d'une réponse du LLM.
Un fichier dont l'empreinte ne correspond pas ne doit pas être remplacé silencieusement par une autre variante. Pour comprendre le mécanisme de téléchargement, ouvrez scripts/fetch_model.py et docs/MODEL_ACQUISITION.md dans le projet.
3. Préparer les données puis appeler l'agent
La commande prepare construit la base SQLite et son empreinte. Nous démarrons ensuite le serveur du modèle, puis lançons l'agent sur les 30 requêtes.
docker compose run --rm --no-deps app -m src.cli prepare
docker compose up -d server
docker compose run --rm --no-deps app -m src.cli agent
Ce que vous devez observer : outputs/agent.json contient les résultats des 30 demandes, et les empreintes de la base avant/après sont identiques.
Prenez le temps d'examiner une demande dans ce fichier. Quelle référence le modèle a-t-il proposée ? Quelle observation l'outil a-t-il renvoyée ? Que contient ensuite la réponse ? Le journal vous permet de suivre ces étapes au lieu de juger uniquement la dernière phrase.
4. Vérifier les refus et lire les résultats
Un test négatif vérifie qu'une opération interdite échoue bien. Ce n'est pas un test qui « se passe mal » : son succès consiste précisément à obtenir le refus attendu.
docker compose run --rm --no-deps app -m src.cli negatives
docker compose run --rm --no-deps app -m src.cli evaluate
Ce que vous devez observer : cinq appels mal formés rejetés, un dépassement du budget refusé, une écriture SQLite refusée, une base inchangée et les résultats JSON d'évaluation.
Les appels qui fonctionnent montrent que l'agent sait consulter les données du scénario. Les appels refusés montrent que les formes interdites testées ne passent pas les contrôles. Nous avons besoin des deux pour comprendre le comportement du programme.
Comprendre les métriques avant de les lire
Une réponse qui paraît convaincante n'est pas forcément une réponse fondée. Pour éviter de mélanger les étapes, l'évaluation utilise plusieurs indicateurs.
| Indicateur | Ce qu'il vérifie ou mesure | Comment le lire |
|---|---|---|
observation_correct |
L'égalité entre l'observation retournée par l'outil et la donnée de référence. | C'est le contrôle le plus direct de la donnée récupérée pour la demande. |
answer_marker_present |
La présence du nombre de stock attendu, ou du mot « introuvable », dans la réponse finale. | C'est un contrôle de marqueur, pas une validation complète du sens de la phrase. |
errors |
Les erreurs de contrôle ou de génération comptabilisées par l'évaluation. | Un zéro décrit cette exécution ; il ne prouve pas l'absence de toutes les pannes possibles. |
mean_ms |
La durée moyenne d'une demande complète, en millisecondes. | Elle concerne la séquence mesurée, pas seulement la requête SQL. |
La différence entre les deux premiers indicateurs mérite un exemple. Imaginons cette réponse fictive : « Stock : 0, mais un réapprovisionnement arrive demain. » Le nombre attendu est bien présent. Pourtant, notre outil n'a fourni aucune date de réapprovisionnement. Un test de présence du marqueur ne suffit donc pas à déclarer toute la phrase correcte.
À l'inverse, l'absence du marqueur ne suffit pas à expliquer la nature de l'échec. Il faut examiner la sortie concernée pour comprendre ce que le modèle a écrit.
Lisez donc les résultats dans cet ordre : la donnée récupérée, les refus attendus, l'empreinte de la base, puis la formulation finale. La qualité du texte ne doit pas masquer une erreur plus tôt dans le parcours.
Résultats observés
Les valeurs ci-dessous sont celles des deux reproductions séparées du parcours de référence R3, sur les 30 requêtes. Elles décrivent cette expérience, avec les données, le modèle et l'environnement présentés plus haut.
| Mesure | Reproduction 1 | Reproduction 2 |
|---|---|---|
| Requêtes traitées | 30 | 30 |
observation_correct |
1,00 | 1,00 |
errors |
0 | 0 |
answer_marker_present |
0,9667 | 0,9667 |
| Durée moyenne | 247,34 ms | 247,41 ms |
Que faut-il en retenir ? Les observations sont correctes sur les 30 demandes de chaque reproduction. Mais le marqueur attendu n'est pas présent dans toutes les réponses finales : 0,9667 correspond, à l'arrondi près, à 29 réponses sur 30.
Cela ne signifie pas que « 96,67 % des phrases sont entièrement correctes ». Ce n'est pas ce que cette métrique mesure. Nous savons seulement que le marqueur recherché est présent à cette fréquence. Les résultats publiés ne permettent pas, à eux seuls, de décrire la formulation de la réponse sans marqueur.
Les durées moyennes sont également celles de ce scénario. Elles ne constituent ni une promesse de performance sur une autre machine, ni un test de charge avec de nombreux utilisateurs simultanés.
Ce que nous avons appris
Nous avons donné au modèle une petite marge de décision : proposer un outil et une référence. Nous ne lui avons pas confié les droits permettant de faire n'importe quelle opération sur la base.
Le JSON sert à échanger une demande avec le programme. L'autorisation, elle, repose sur la liste fermée des outils, les arguments exacts et les contrôles du code. SQLite ajoute sa propre restriction avec la connexion en lecture seule.
L'expérience nous apprend aussi à séparer l'exactitude de l'outil de l'exactitude de la formulation. Une observation correcte n'empêche pas, à elle seule, une phrase inadéquate. Il faut donc conserver la donnée structurée pour pouvoir expliquer et vérifier la réponse.
Enfin, les empreintes identiques et les tests négatifs décrivent ce qui a été contrôlé dans ce parcours. Ils ne démontrent pas la sécurité de tout programme qui réutiliserait cette idée. Changer les outils, la base, le réseau ou les arguments modifie les comportements à évaluer.
Exercice actif : prédire, modifier, exécuter, observer, expliquer
À vous de jouer. Avant de lancer les commandes, notez vos réponses à ces trois questions :
REF-000doit-elle être déclarée introuvable parce que son stock vaut0?REF-999doit-elle être présentée comme un produit épuisé ?- Si une demande contient un outil nommé
delete, où doit se trouver la règle qui interdit son exécution ?
Exécutez ensuite :
docker compose run --rm --no-deps app -m src.cli exercise
docker compose run --rm --no-deps app -m src.cli negatives
Comparer vos prédictions aux observations
Pour REF-000, le résultat attendu est une observation contenant le produit et un stock égal à 0. Pour REF-999, c'est { "found": false }. Si vous aviez confondu les deux, revenez au test row is None dans toolcall() : c'est l'absence de ligne qui déclenche « introuvable », pas la valeur du stock.
Pour delete, la règle doit être appliquée par le contrôleur, avant la base. Le fait qu'une demande soit du JSON syntaxiquement valide ne lui donne aucun droit d'exécution.
Il faut toutefois distinguer JSON valide et JSON conforme à un schéma. Un schéma peut restreindre les valeurs possibles d'un champ, notamment avec une énumération enum. Il peut donc aider à exclure certains noms d'outils. Cela ne dispense pas toolcall() d'appliquer les autorisations au moment de l'appel. Les tests négatifs montrent ici le refus côté contrôleur ; ils ne démontrent pas un contournement du schéma de génération.
Changer un mot, puis expliquer le refus
Travaillez maintenant dans une copie du projet. Dans src/cli.py, repérez la liste cases et remplacez le nom delete d'un appel par modifier_stock. Ne modifiez pas la liste des outils autorisés.
Avant de relancer la commande negatives ci-dessus, prédisez le résultat. Quelle condition doit refuser cette demande ? Observez ensuite le comportement et retrouvez la vérification correspondante dans toolcall().
Le point à comprendre : le contrôleur n'a pas besoin de connaître tous les verbes dangereux. Il n'accepte que les noms explicitement autorisés. Renommer une action interdite ne la fait pas entrer dans cette liste.
Cette modification est une expérience proposée au lecteur, distincte du parcours de référence. Nous n'en publions pas de mesure.
Dépannage et nettoyage
Le serveur du modèle n'est pas prêt. Consultez les journaux du service server dans Docker, puis vérifiez le préflight et la VRAM disponible. Le serveur doit avoir chargé le modèle pour traiter les demandes.
Une base existe déjà. Repartez d'une extraction neuve de l'archive. create() refuse volontairement d'écraser le fichier existant : il ne faut pas supprimer ce contrôle pour faire disparaître le message.
Une demande est refusée. Examinez sa forme exacte. Une clé supplémentaire, une référence hors format ou un compteur non entier suffisent à provoquer un rejet. Demandez-vous d'abord si le refus correspond au contrat, plutôt que de considérer automatiquement qu'il s'agit d'un bug.
Après l'exercice, arrêtez les services :
docker compose down
Les conteneurs et le réseau du projet sont supprimés. Les modèles et les sorties restent sur disque. Pour repartir de zéro, supprimez uniquement le répertoire d'extraction que vous avez créé et dont vous n'avez plus besoin. Ne supprimez pas de volumes ou d'images partagés sans en connaître le propriétaire.
Du tutoriel à une application réelle
Notre contrôleur couvre une base SQLite, deux noms d'outils et un contrat d'arguments précis. C'est un périmètre pédagogique, pas une application prête à être ouverte à tous vos clients.
Il manque notamment l'authentification, les autorisations par utilisateur, le chiffrement, un véritable journal d'audit et une limitation globale du débit. Le parcours ne prétend pas non plus empêcher toutes les fuites de données.
Prenons un prolongement concret : deux clients d'une application ne doivent pas forcément consulter les mêmes produits. Une référence peut être parfaitement formée et un outil autorisé, tout en visant une ressource à laquelle l'utilisateur n'a pas droit. Autoriser un outil et autoriser l'accès à une ressource sont deux décisions différentes.
Avant un déploiement, liez donc l'identité de l'appelant aux droits sur chaque ressource. Enregistrez les décisions d'autorisation, isolez les secrets, testez les erreurs du modèle et faites revoir les actions à impact. La lecture seule protège contre certaines modifications ; elle n'autorise pas pour autant à exposer toutes les données.
Pour aller plus loin
Un premier prolongement consiste à ajouter un troisième outil de lecture. Commencez par définir ses arguments, son autorisation côté serveur et ses tests négatifs, avant de le rendre disponible au modèle. Cette extension n'appartient pas aux résultats R3 présentés ici.
Introduisez ensuite une identité d'appelant et vérifiez qu'elle limite les références consultables. Conservez l'observation structurée pour distinguer la donnée source, la décision d'autorisation et la réponse du modèle.
Vous aurez alors prolongé le mécanisme essentiel de ce tutoriel : faire travailler un modèle avec votre application, sans confondre ce qu'il demande avec ce qu'il est autorisé à faire.
Sources primaires consultées
Les données, commandes, extraits de code et résultats présentés correspondent au projet R3. Les références ci-dessous expliquent les mécanismes employés ; elles ne remplacent pas les versions et fichiers verrouillés du projet.
Modèle et environnement du parcours de référence
- Qwen2.5-7B-Instruct-GGUF, révision verrouillée : dépôt, format GGUF et variante Q4_K_M.
- SQLite — URI filenames : ouverture d'une connexion en lecture seule avec
mode=ro. - NVIDIA Container Toolkit — prérequis d'installation : pilote NVIDIA et accès GPU depuis les conteneurs.
Compléments pour comprendre le code et les contrôles
Python — requêtes SQLite paramétrées explique la séparation entre la requête et ses valeurs. Python — booléens précise le lien entre bool et int, et Python — hashlib documente le calcul d'empreintes.
Docker Compose — services décrit les options d'exécution et de montage. llama.cpp — serveur présente l'inférence et les sorties contraintes. JSON Schema — enum détaille la restriction d'un champ à une liste de valeurs.