





Immaginate un piccolo assistente integrato nel vostro negozio online. Un cliente gli chiede: «Qual è la disponibilità di REF-000?». Invece di scorrere il catalogo, si aspetta una risposta immediata, formulata in modo comprensibile.
Dal punto di vista dello sviluppo web, l’esigenza vi è probabilmente familiare: recuperare un riferimento, interrogare un database e visualizzare un risultato. Manterremo questo meccanismo, ma affideremo a un modello linguistico la trasformazione della domanda in una richiesta strutturata.
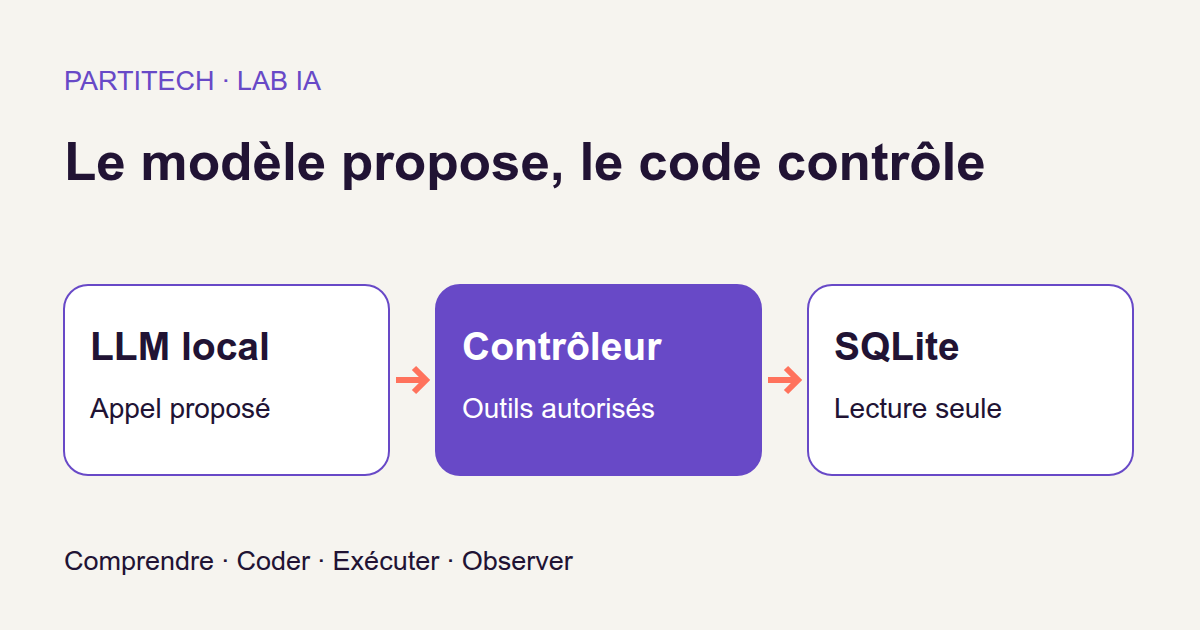
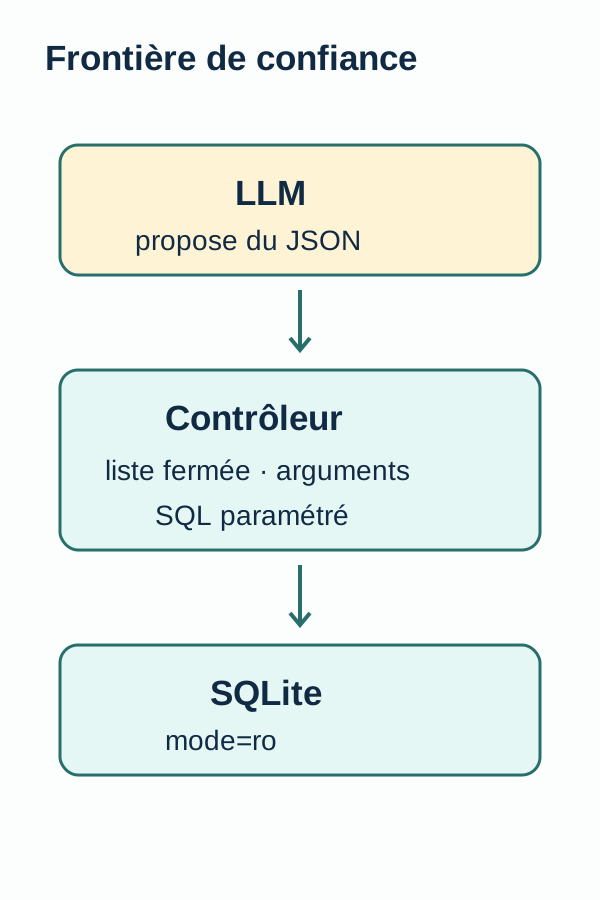
Il punto importante sta in una frase: il modello propone un’azione, ma il vostro codice decide se può eseguirla. Non riceve né un terminale né la possibilità di scrivere SQL libero. E anche quando dispone del dato corretto, verificheremo che cosa ne faccia nella risposta.
In questo tutorial costruiamo un agente locale capace di consultare prodotti e relative disponibilità. Seguiremo il percorso di una domanda, leggeremo le funzioni che controllano gli accessi, quindi eseguiremo il progetto e i suoi test. Non occorre conoscere la matematica dei modelli linguistici: saper leggere Python, usare JSON e un terminale è sufficiente per seguire il percorso.
Scaricare il progetto completo del tutorial.
L’archivio contiene il progetto da riprodurre. I file del modello, chiamati anche i suoi pesi, non sono inclusi: saranno scaricati a una revisione precisa e verificati durante l’installazione. Useremo il percorso R3, che qui indica la versione del progetto presentata e testata.
Cosa costruiamo
Dal modulo web alla domanda in linguaggio naturale
In un’interfaccia classica, l’utente inserisce un riferimento in un campo. La vostra applicazione verifica questo valore, consulta il database e visualizza la disponibilità.
Qui l’utente scrive una frase. L’LLM, abbreviazione di Large Language Model, genera una proposta che permette al nostro programma di ricavare una richiesta strutturata. Non gli chiediamo di memorizzare il catalogo o di indovinare la quantità disponibile: il database resta la fonte di verità.
In questo progetto, uno strumento è un’operazione che il nostro codice accetta di effettuare per il modello. Non è un programma inventato dal modello al momento. Abbiamo previsto due nomi di strumenti: rechercher_produit e consulter_stock.
Per la domanda «Qual è la disponibilità di REF-000?», ecco un esempio di proposta conforme al contratto. Illustra il formato previsto; non è la trascrizione di un output misurato:
{
  "outil": "consulter_stock",
  "arguments": {
    "ref": "REF-000"
  }
}
Questo JSON si legge semplicemente così: «Desidero usare lo strumento consulter_stock con il riferimento REF-000.» Per uno sviluppatore web, assomiglia al corpo di una richiesta inviata a un’API. E come per un’API, ricevere una richiesta non significa doverla accettare.
Il percorso completo di una domanda
Il modello propone questa chiamata. La funzione toolcall() verifica quindi il nome dello strumento e i suoi argomenti. Se la richiesta è autorizzata, una query SQL scritta dallo sviluppatore consulta il database. Il suo risultato diventa un’osservazione: è il dato effettivamente letto, in forma strutturata.
Questa osservazione viene infine trasmessa al modello affinché formuli una risposta breve. Abbiamo quindi tre elementi distinti da esaminare: la richiesta proposta, il dato recuperato e la frase finale. Questa separazione ci permetterà di capire dove si trovi un eventuale errore.
Parliamo qui di agente perché il modello propone l’uso di uno strumento. Ma il percorso resta volutamente limitato: una proposta, al massimo una chiamata allo strumento, poi una riformulazione. Non comprende un ciclo in cui il modello concatenerebbe azioni fino a decidere di fermarsi.
Il modello propone; il controller autorizza
Trattare JSON come input esterno
Un modello linguistico produce testo. Un prompt è l’istruzione fornita per orientare questa produzione. Chiedergli «usa solo questi due strumenti» è utile, ma questa frase non sostituisce un controllo nel programma.
Pensate a un modulo il cui browser disabilita il pulsante «Elimina». Non eliminereste per questo la verifica lato server. Applichiamo la stessa logica alle proposte del modello: devono passare dal codice che fa autorità.
In agent.py, la funzione run() richiede un oggetto contenente outil e arguments. Decodifica il JSON, lo trasmette a toolcall(), poi usa l’osservazione ottenuta per richiedere la risposta finale.
La decisione di autorizzare o rifiutare si trova in tools.py. Il suo contratto è preciso:
- Il nome dello strumento deve essere
rechercher_produitoconsulter_stock, gli unici nomi dell’elenco autorizzato, chiamato anche allowlist. - L’oggetto principale deve contenere esattamente
outilearguments. Inarguments, è accettata solo la chiaveref. - Il riferimento deve essere una stringa corrispondente a
REF-[0-9]{3}: il prefissoREF-, seguito da tre cifre, senza altri caratteri.
Quindi REF-000 rispetta il formato. REF-12, ref-000 o un riferimento seguito da un’istruzione aggiuntiva non lo rispettano. Una chiave aggiunta «per ogni evenienza» non viene ignorata: fa rifiutare la richiesta.
In questa versione, i due nomi di strumenti autorizzati portano alla stessa lettura delle colonne ref, name e stock. rechercher_produit non designa quindi una ricerca libera nel catalogo: riceve anch’esso un riferimento esatto.
Perché non lasciare che il modello scriva la query SQL?
Perché la nostra esigenza non lo richiede. Sappiamo già quale tabella e quali colonne consultare. Il modello ha un solo valore da proporre: il riferimento.
La query è fissata nel codice: SELECT ref,name,stock FROM products WHERE ref=?. Il ? è un segnaposto; il riferimento viene trasmesso separatamente come parametro. È trattato come un dato, non come una parte di SQL da eseguire. È il principio delle query parametrizzate documentate da Python.
Il modello non sceglie quindi né la tabella, né le colonne, né un comando da eseguire. Nessun percorso di questo flusso gli permette di eseguire un comando shell libero o SQL che avrebbe prodotto.
Un secondo limite interviene a livello del database: la connessione SQLite viene aperta in sola lettura con mode=ro. I tentativi di scrittura tramite questa connessione devono fallire, anche se effettuati fuori dalla nostra query di consultazione.
Attenzione al contatore delle chiamate
toolcall() riceve anche un parametro count. Accetta i valori interi 0, 1 e 2, poi rifiuta 3. Vengono rifiutati anche contatori negativi o di un altro tipo.
Questo parametro non costituisce una quota che ricorda da sola le chiamate precedenti. Nel nostro percorso, run() chiama lo strumento una sola volta, con il valore iniziale. Se poi aggiungete un ciclo, il codice che chiama toolcall() dovrà incrementare il contatore. Chiamare la funzione più volte lasciando sistematicamente count=0 non consuma alcun budget memorizzato.
Dati, limiti e concetti
Una disponibilità zero non è un prodotto introvabile
Il file data/products.json contiene 60 prodotti e 30 richieste. La prima domanda, con identificativo 0, è esattamente: «Qual è la disponibilità di REF-000?»
Nei dati, REF-000 corrisponde a «Prodotto 0», la cui disponibilità è 0. A partire da questa scheda e dal codice di lettura, l’osservazione prevista è:
{
  "ref": "REF-000",
  "name": "Produit 0",
  "stock": 0
}
Il prodotto esiste. È semplicemente esaurito.
Al contrario, tre richieste del set di dati riguardano REF-999, che non esiste nel database. In questo caso lo strumento restituisce { "found": false }.
La differenza è importante: zero è un valore noto; «introvabile» è un’assenza di risultato. Per un negozio, queste situazioni non portano allo stesso messaggio. «Non ne abbiamo più in magazzino» non significa «non conosciamo questo riferimento».
Notate anche che REF-999 rispetta il formato autorizzato. Il controller può quindi accettarne la consultazione senza che il database contenga un prodotto corrispondente. Convalidare la forma di un riferimento e verificarne l’esistenza sono due fasi diverse.
Verificare che il database non sia cambiato
Il programma calcola un’impronta SHA-256 del file del database prima e dopo le 30 richieste, poi richiede che i due valori siano identici. Un’impronta è un valore calcolato a partire dal contenuto di un file; Python mette a disposizione, fra gli altri, SHA-256 nel modulo hashlib.
Per il nostro esperimento, si tratta di un controllo prima/dopo: vogliamo consultare i prodotti, non modificare i dati. Una differenza nell'impronta indicherebbe che il file non è più identico.
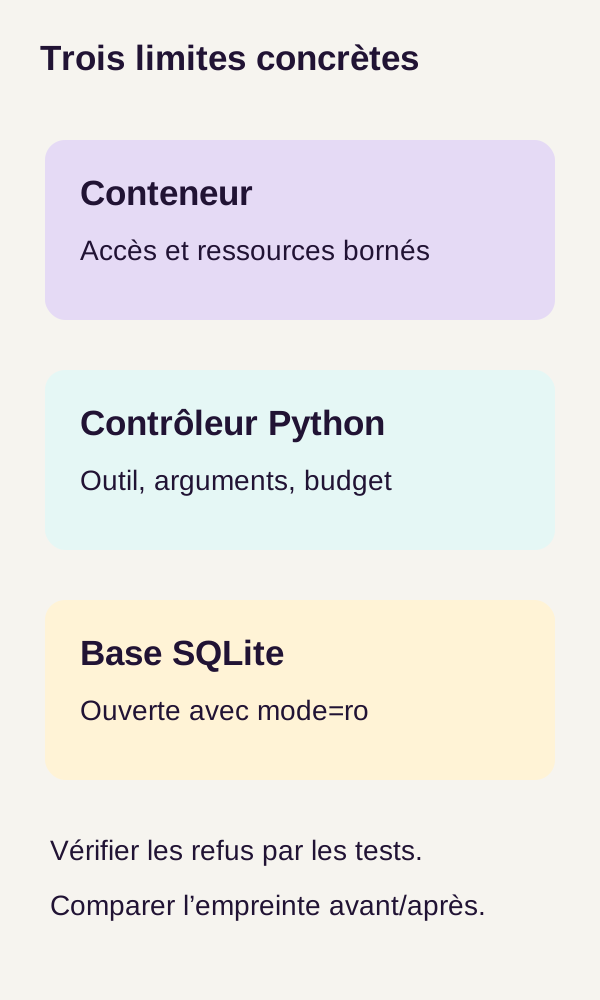
Questo controllo non sostituisce la sola lettura. Confronta due stati; non descrive tutte le azioni eseguite tra i due e non dice chi ha consultato i dati. Lo usiamo in aggiunta alle restrizioni e ai test di rifiuto.
Perché aggiungere protezioni Docker?
Il progetto combina tre livelli di controllo: l'ambiente di esecuzione, la validazione Python e la connessione SQLite.
Il contenitore dell'applicazione ha un file system in sola lettura. Le sue capability Linux, ossia particolari privilegi di sistema, sono rimosse. L'opzione no-new-privileges impedisce al processo di acquisire nuovi privilegi quando esegue altri programmi. Un tmpfs, spazio temporaneo in memoria, è limitato. L'applicazione usa una rete Docker interna; i mount del modello e dei dati sono in sola lettura secondo il loro ruolo.
Questi meccanismi riducono ciò che l'applicazione può fare nel proprio ambiente. Non sostituiscono il controllo degli strumenti. Per approfondire le opzioni coinvolte, consultate il riferimento dei servizi Docker Compose.
«Sola lettura» non significa nemmeno che l'esperimento non produca alcun risultato: il progetto prevede la directory outputs/ per i propri output. Ciò che proteggiamo qui, in particolare, è il database consultato dall'agente.
Il modello effettivamente utilizzato
Utilizziamo Qwen2.5-7B-Instruct-GGUF, variante q4, servito da llama.cpp sulla rete Docker interna.
Per decodificare questo nome: 7B indica un modello di circa sette miliardi di parametri; Instruct indica una variante preparata per seguire istruzioni; GGUF è il formato dei file caricati dal motore. La variante Q4_K_M è una versione quantizzata: rappresenta i pesi con precisione ridotta per diminuirne l'ingombro. Questi elementi sono documentati nel repository ufficiale del modello.
Il modello e il motore non hanno lo stesso ruolo: Qwen fornisce i pesi; llama.cpp li carica ed esegue le generazioni. La nostra applicazione Python gli invia le richieste. Questo utilizzo di un modello già addestrato si chiama inferenza. In questo tutorial non addestriamo il modello.
Il percorso R3 fissa la revisione del repository a bb5d59e06d9551d752d08b292a50eb208b07ab1f. Anche i due file GGUF sono bloccati tramite il loro SHA-256 in configs/models.lock.json. L'obiettivo è ritrovare gli stessi file, non scaricare automaticamente una versione più recente.
La funzione generate() usa temperature=0, seed=42 e max_tokens=100. La temperatura regola la quota di casualità nella generazione; il seme fissa un parametro del generatore casuale; max_tokens limita la lunghezza dell'output in unità di testo chiamate token, che non corrispondono necessariamente a parole intere. Anche uno schema JSON rigoroso vincola la prima generazione. Il server llama.cpp documenta le impostazioni di generazione e gli output vincolati da schema.
Queste impostazioni descrivono con precisione l'esperimento. Non dimostrano né che il modello sceglierà sempre il riferimento corretto, né che la sua frase finale sarà sempre esatta. Proprio per questo conserviamo le osservazioni e misuriamo i risultati.
Le funzioni centrali da leggere prima dell'esecuzione
Cominciamo dal cuore del programma. Gli estratti seguenti riprendono la logica del codice R3, con un'impaginazione più ariosa. Non sono file autonomi: import, costanti e altre funzioni si trovano nel progetto scaricabile.
Tre funzioni preparano il terreno. create() crea un nuovo database e rifiuta di sovrascrivere un file esistente. readonly() apre la connessione in sola lettura. digest() legge i byte del file e calcola la sua impronta SHA-256. Per questo un nuovo esperimento inizia in una nuova estrazione dell'archivio.
toolcall(): il passaggio obbligato prima del database
def toolcall(db, call, count=0):
    if type(count) is not int or not 0 <= count < 3:
        raise ValueError("Budget d’appels épuisé ou invalide")

    if (
        not isinstance(call, dict)
        or set(call) != {"outil", "arguments"}
        or call["outil"] not in TOOLS
    ):
        raise ValueError("Outil interdit ou appel mal formé")

    args = call["arguments"]
    if (
        not isinstance(args, dict)
        or set(args) != {"ref"}
        or not isinstance(args["ref"], str)
        or not re.fullmatch("REF-[0-9]{3}", args["ref"])
    ):
        raise ValueError("Référence ou arguments invalides")

    row = db.execute(
        "SELECT ref,name,stock FROM products WHERE ref=?",
        (args["ref"],),
    ).fetchone()

    return (
        {"found": False}
        if row is None
        else dict(zip(("ref", "name", "stock"), row))
    )
Leggete questa funzione dall'alto in basso: finché i controlli non sono superati, la query SQL non viene raggiunta.
Prima, il contatore. Il test type(count) is not int richiede un intero Python esatto. Perché non accettare semplicemente tutto ciò che somiglia a un intero? Perché in Python i booleani sono un sottotipo degli interi: True può comportarsi come 1. La documentazione Python sui booleani spiega questa particolarità. Qui un booleano non costituisce un contatore valido.
Poi, l'involucro della richiesta. call deve essere un dizionario. set(call) recupera l'insieme delle sue chiavi: il confronto richiede esattamente outil e arguments, senza chiavi mancanti né aggiuntive. TOOLS contiene i nomi autorizzati.
Poi, gli argomenti. La stessa logica si applica a args, che deve contenere solo ref. re.fullmatch() verifica l'intero riferimento, non soltanto l'inizio della stringa.
Infine, la lettura. fetchone() recupera una riga o restituisce None quando nessun prodotto corrisponde. L'ultima istruzione restituisce quindi { "found": false } oppure un dizionario che associa le colonne ref, name e stock ai loro valori. zip() esegue questa associazione prima che dict() costruisca il dizionario.
Nessuno di questi passaggi chiede al modello di decidere da sé i propri permessi. Le regole risiedono nel programma.
readonly(): far applicare la sola lettura da SQLite
def readonly(path):
    return sqlite3.connect(
        Path(path).resolve().as_uri() + "?mode=ro",
        uri=True,
    )
Path(path).resolve().as_uri() trasforma il percorso del file in URI. Il suffisso ?mode=ro richiede un'apertura in sola lettura e uri=True indica a Python di interpretare questa notazione. Il comportamento di mode=ro è descritto nella documentazione ufficiale di SQLite.
Non è quindi soltanto una convenzione del tipo «promettiamo di eseguire solo SELECT». La connessione stessa impone la restrizione. I test negativi tenteranno una scrittura dopo questa apertura e verificheranno che fallisca.
run(): collegare la domanda, lo strumento e la risposta
def run(db, query):
    start = time.perf_counter()
    proposal = generate(
        query["query"],
        SCHEMA,
        system="Choisis un outil en JSON. Outils autorisés: rechercher_produit(ref), consulter_stock(ref).",
    )
    trace = []
    answer = None
    error = None

    try:
        if proposal["finish_reason"] != "stop":
            raise ValueError("Proposition tronquée")

        call = json.loads(proposal["raw"])
        observation = toolcall(db, call)
        trace.append({"call": call, "observation": observation})

        answer = generate(
            query["query"] + "\nObservation outil: " + json.dumps(observation),
            system="Réponds uniquement avec le stock observé, ou introuvable. Ne devine pas.",
        )
    except (ValueError, TypeError, KeyError) as exc:
        error = str(exc)

    return {
        **query,
        "proposal": proposal,
        "trace": trace,
        "answer": answer,
        "error": error,
        "seconds": time.perf_counter() - start,
    }
La funzione chiama generate() due volte, ma per due compiti diversi. La prima chiamata richiede uno strumento in formato JSON. La seconda richiede una frase basata sull'osservazione restituita da quello strumento.
Tra le due, finish_reason deve valere stop. In questo percorso, qualsiasi altro valore fa rifiutare la proposta prima del controllore. Questo controllo non basta a validare il contenuto: json.loads() deve ancora decodificare il testo, poi toolcall() deve accettare la richiesta. Se quest'ultima viene rifiutata, la seconda generazione non viene avviata.
trace conserva la chiamata effettivamente eseguita e il dato letto. proposal conserva la proposta iniziale, mentre error riceve il messaggio delle eccezioni catturate. Al ritorno, **query riprende i campi della domanda originale; seconds misura la durata della sequenza dall'inizio della funzione.
Un dettaglio da notare in questo estratto: il primo generate() si trova prima del blocco try. Questo blocco cattura poi solo ValueError, TypeError e KeyError. Non bisogna quindi interpretare error come una garanzia di registrazione di tutti i guasti possibili, soprattutto alla prima chiamata. È un limite visibile leggendo il codice, non un ulteriore incidente osservato durante le prove.
Infine, evaluate() verificherà due aspetti distinti: l'esattezza dell'osservazione e la presenza nella risposta di un marcatore atteso. Vedremo perché questi due controlli non hanno la stessa forza.
Prerequisiti ed esecuzione
Ora possiamo avviare il progetto sapendo che cosa vogliamo osservare.
La riproduzione verificata usa Linux x86_64, Docker/Compose, un driver NVIDIA e NVIDIA Container Toolkit, su una RTX 3090. Il README prevede 12 GiB di RAM, 15 GiB liberi sul disco del progetto e nello storage Docker, oltre a 10 GiB di VRAM libera. La VRAM è la memoria della scheda grafica, distinta dalla RAM della macchina. Queste risorse sono stime conservative, non minimi misurati. In questo percorso non è validata alcuna modalità CPU.
NVIDIA Container Toolkit permette al contenitore di accedere alla scheda selezionata e alle librerie del driver. Una GPU visibile sull'host non è necessariamente utilizzabile da Docker: è proprio ciò che verificherà il controllo preliminare, o preflight. Lo script non modifica il sistema. Per i prerequisiti di installazione, fare riferimento alla documentazione NVIDIA Container Toolkit.
Estraete lo ZIP in una nuova directory, quindi posizionatevi nella cartella che contiene compose.yaml. Tutti i comandi seguenti vengono eseguiti da questa radice.
Per orientarsi: app esegue il codice Python; server carica il modello con llama.cpp; models/ conserva i pesi scaricati; outputs/ riceve i risultati. Prepareremo l'ambiente, acquisiremo il modello, poi eseguiremo e valuteremo le richieste.
1. Validare l'ambiente e creare l'immagine
Prima di qualsiasi generazione, verifichiamo l'accesso alla GPU da Docker. Lo script di configurazione e la creazione delle immagini preparano poi l'ambiente del progetto.
./scripts/preflight.sh
sh scripts/setup.sh
docker compose build
Che cosa dovete osservare: nessun errore di preflight o di build. Se nvidia-smi funziona sull'host ma il preflight fallisce in Docker, l'ambiente non è ancora pronto per questo tutorial.
2. Acquisire il modello ed eseguire i test pubblici
Il download colloca i file in models/ dopo averne verificato la dimensione e lo SHA-256. Internet è necessario per il build e per questa acquisizione; in seguito le generazioni usano i file locali.
docker compose --profile acquisition run --rm --no-deps fetch
docker compose run --rm --no-deps app -m unittest discover -s tests -v
Che cosa dovete osservare: 14 test riusciti. Questi test verificano il contratto degli strumenti e gli input vietati prima di qualsiasi richiesta al server del modello. Controlliamo così le regole del programma senza dipendere da una risposta del LLM.
Un file la cui impronta non corrisponde non deve essere sostituito silenziosamente con un’altra variante. Per capire il meccanismo di download, aprite scripts/fetch_model.py e docs/MODEL_ACQUISITION.md nel progetto.
3. Preparare i dati e chiamare l’agente
Il comando prepare crea il database SQLite e la sua impronta. Avviamo poi il server del modello ed eseguiamo l’agente sulle 30 richieste.
docker compose run --rm --no-deps app -m src.cli prepare
docker compose up -d server
docker compose run --rm --no-deps app -m src.cli agent
Che cosa osservare: outputs/agent.json contiene i risultati delle 30 richieste e le impronte del database prima e dopo sono identiche.
Prendetevi il tempo di esaminare una richiesta in questo file. Quale riferimento ha proposto il modello? Quale osservazione ha restituito lo strumento? Che cosa contiene poi la risposta? Il registro permette di seguire queste fasi, invece di giudicare soltanto l’ultima frase.
4. Verificare i rifiuti e leggere i risultati
Un test negativo verifica che un’operazione vietata fallisca effettivamente. Non è un test che «va male»: il suo successo consiste proprio nell’ottenere il rifiuto previsto.
docker compose run --rm --no-deps app -m src.cli negatives
docker compose run --rm --no-deps app -m src.cli evaluate
Che cosa osservare: cinque chiamate malformate rifiutate, un superamento del limite di chiamate rifiutato, una scrittura SQLite rifiutata, un database invariato e i risultati della valutazione in JSON.
Le chiamate riuscite mostrano che l’agente sa consultare i dati dello scenario. Quelle rifiutate mostrano che le forme vietate sottoposte a test non superano i controlli. Servono entrambe per comprendere il comportamento del programma.
Comprendere le metriche prima di leggerle
Una risposta che sembra convincente non è necessariamente fondata. Per evitare di confondere le fasi, la valutazione usa diversi indicatori.
| Indicatore | Che cosa verifica o misura | Come leggerlo |
|---|---|---|
observation_correct |
L’uguaglianza fra l’osservazione restituita dallo strumento e il dato di riferimento. | È il controllo più diretto del dato recuperato per la richiesta. |
answer_marker_present |
La presenza della quantità di scorte prevista, o della parola francese «introuvable» («non trovato»), nella risposta finale. | È un controllo di un marcatore, non una verifica completa del significato della frase. |
errors |
Gli errori di controllo o generazione conteggiati dalla valutazione. | Uno zero descrive questa esecuzione; non dimostra l’assenza di ogni possibile guasto. |
mean_ms |
La durata media di una richiesta completa, in millisecondi. | Riguarda la sequenza misurata, non soltanto la query SQL. |
La differenza fra i primi due indicatori merita un esempio. Immaginiamo questa risposta fittizia: «Scorte: 0, ma domani arriva un rifornimento». Il numero atteso è presente. Tuttavia il nostro strumento non ha fornito alcuna data di rifornimento. Un test sulla presenza del marcatore non basta quindi a dichiarare corretta l’intera frase.
Viceversa, l’assenza del marcatore non basta a spiegare la natura dell’errore. Occorre esaminare l’output interessato per capire che cosa ha scritto il modello.
Leggete quindi i risultati in questo ordine: il dato recuperato, i rifiuti previsti, l’impronta del database e infine la formulazione finale. La qualità del testo non deve nascondere un errore avvenuto prima nel percorso.
Risultati osservati
I valori seguenti corrispondono a due riproduzioni separate del percorso di riferimento R3, sulle 30 richieste. Descrivono questo esperimento, con i dati, il modello e l’ambiente presentati sopra.
| Misura | Riproduzione 1 | Riproduzione 2 |
|---|---|---|
| Richieste elaborate | 30 | 30 |
observation_correct |
1,00 | 1,00 |
errors |
0 | 0 |
answer_marker_present |
0,9667 | 0,9667 |
| Durata media | 247,34 ms | 247,41 ms |
Che cosa ne ricaviamo? Le osservazioni sono corrette per tutte le 30 richieste di ogni riproduzione. Il marcatore atteso, però, non è presente in tutte le risposte finali: 0,9667 corrisponde, a meno dell’arrotondamento, a 29 risposte su 30.
Questo non significa che «il 96,67% delle frasi sia interamente corretto». Non è ciò che misura questa metrica. Sappiamo soltanto che il marcatore cercato è presente con questa frequenza. I risultati pubblicati non permettono, da soli, di descrivere la formulazione della risposta priva del marcatore.
Anche le durate medie riguardano questo scenario. Non rappresentano né una promessa di prestazioni su un’altra macchina né un test di carico con molti utenti simultanei.
Che cosa abbiamo imparato
Abbiamo dato al modello un piccolo margine decisionale: proporre uno strumento e un riferimento. Non gli abbiamo assegnato i permessi per compiere qualsiasi operazione sul database.
Il JSON serve a scambiare una richiesta con il programma. L'autorizzazione si basa invece sulla lista chiusa degli strumenti, sugli argomenti esatti e sui controlli del codice. SQLite aggiunge la propria restrizione con la connessione in sola lettura.
L'esperimento ci insegna anche a separare la correttezza dello strumento dalla correttezza della formulazione. Un'osservazione corretta non impedisce, da sola, una frase inadeguata. Occorre quindi conservare il dato strutturato per poter spiegare e verificare la risposta.
Infine, le impronte identiche e i test negativi descrivono ciò che è stato controllato in questo percorso. Non dimostrano la sicurezza di ogni programma che riutilizzasse questa idea. Cambiare gli strumenti, il database, la rete o gli argomenti modifica i comportamenti da valutare.
Esercizio attivo: prevedere, modificare, eseguire, osservare, spiegare
Ora tocca a voi. Prima di eseguire i comandi, annotate le risposte a queste tre domande:
REF-000deve risultare non trovato perché le sue scorte valgono0?REF-999deve essere presentato come un prodotto esaurito?- Se una richiesta contiene uno strumento chiamato
delete, dove deve essere applicata la regola che ne vieta l’esecuzione?
Eseguite poi:
docker compose run --rm --no-deps app -m src.cli exercise
docker compose run --rm --no-deps app -m src.cli negatives
Confrontare le vostre previsioni con le osservazioni
Per REF-000, il risultato atteso è un'osservazione contenente il prodotto e uno stock pari a 0. Per REF-999, è { "found": false }. Se avete confuso i due casi, tornate al test row is None in toolcall(): è l'assenza di riga che attiva «non trovato», non il valore dello stock.
Per delete, la regola deve essere applicata dal controllore, prima del database. Il fatto che una richiesta sia JSON sintatticamente valido non le conferisce alcun diritto di esecuzione.
Bisogna tuttavia distinguere tra JSON valido e JSON conforme a uno schema. Uno schema può limitare i valori possibili di un campo, in particolare con un'enumerazione enum. Può quindi aiutare a escludere alcuni nomi di strumenti. Ciò non esonera toolcall() dall'applicare le autorizzazioni al momento della chiamata. Qui i test negativi mostrano il rifiuto lato controllore; non dimostrano un aggiramento dello schema di generazione.
Cambiare una parola, poi spiegare il rifiuto
Lavorate ora in una copia del progetto. In src/cli.py, individuate la lista cases e sostituite il nome delete di una chiamata con modifier_stock. Non modificate la lista degli strumenti autorizzati.
Prima di rilanciare il comando negatives qui sopra, prevedete il risultato. Quale condizione deve rifiutare questa richiesta? Osservate poi il comportamento e ritrovate la verifica corrispondente in toolcall().
Il punto da comprendere: il controllore non deve conoscere tutti i verbi pericolosi. Accetta soltanto i nomi esplicitamente autorizzati. Rinominare un'azione vietata non la fa entrare in questa lista.
Questa modifica è un esperimento proposto al lettore, distinto dal percorso di riferimento. Non ne pubblichiamo alcuna misurazione.
Risoluzione dei problemi e pulizia
Il server del modello non è pronto. Consultate i log del servizio server in Docker, poi verificate il preflight e la VRAM disponibile. Il server deve aver caricato il modello per elaborare le richieste.
Esiste già un database. Ripartite da una nuova estrazione dell'archivio. create() rifiuta volutamente di sovrascrivere il file esistente: non bisogna rimuovere questo controllo per far sparire il messaggio.
Una richiesta viene rifiutata. Esaminatene la forma esatta. Una chiave aggiuntiva, un riferimento fuori formato o un contatore non intero sono sufficienti a provocare un rifiuto. Chiedetevi anzitutto se il rifiuto corrisponde al contratto, invece di considerarlo automaticamente un bug.
Dopo l'esercizio, arrestate i servizi:
docker compose down
I contenitori e la rete del progetto vengono rimossi. I modelli e gli output restano sul disco. Per ripartire da zero, eliminate soltanto la directory di estrazione che avete creato e che non vi serve più. Non eliminate volumi o immagini condivisi senza conoscerne il proprietario.
Dal tutorial a un'applicazione reale
Il nostro controllore copre un database SQLite, due nomi di strumenti e un contratto di argomenti preciso. È un perimetro didattico, non un'applicazione pronta per essere aperta a tutti i vostri clienti.
Mancano in particolare l'autenticazione, le autorizzazioni per utente, la crittografia, un vero registro di audit e una limitazione globale della velocità. Il percorso non pretende nemmeno di impedire tutte le fughe di dati.
Prendiamo un'estensione concreta: due clienti di un'applicazione non devono necessariamente consultare gli stessi prodotti. Un riferimento può essere perfettamente formato e uno strumento autorizzato, pur puntando a una risorsa a cui l'utente non ha diritto. Autorizzare uno strumento e autorizzare l'accesso a una risorsa sono due decisioni diverse.
Prima di un deployment, collegate quindi l'identità del chiamante ai diritti su ogni risorsa. Registrate le decisioni di autorizzazione, isolate i segreti, testate gli errori del modello e fate riesaminare le azioni a impatto. La sola lettura protegge da alcune modifiche; non autorizza tuttavia a esporre tutti i dati.
Per andare oltre
Una prima estensione consiste nell'aggiungere un terzo strumento di lettura. Iniziate definendo i suoi argomenti, la sua autorizzazione lato server e i suoi test negativi, prima di renderlo disponibile al modello. Questa estensione non appartiene ai risultati R3 presentati qui.
Introducete poi un'identità del chiamante e verificate che limiti i riferimenti consultabili. Conservate l'osservazione strutturata per distinguere il dato sorgente, la decisione di autorizzazione e la risposta del modello.
Avrete allora esteso il meccanismo essenziale di questo tutorial: far lavorare un modello con la vostra applicazione, senza confondere ciò che chiede con ciò che è autorizzato a fare.
Fonti primarie consultate
I dati, i comandi, gli estratti di codice e i risultati presentati corrispondono al progetto R3. I riferimenti seguenti spiegano i meccanismi utilizzati; non sostituiscono le versioni e i file bloccati del progetto.
Modello e ambiente del percorso di riferimento
- Qwen2.5-7B-Instruct-GGUF, revisione bloccata: repository, formato GGUF e variante Q4_K_M.
- SQLite — URI filenames: apertura di una connessione in sola lettura con
mode=ro. - NVIDIA Container Toolkit — prerequisiti di installazione: driver NVIDIA e accesso GPU dai contenitori.
Approfondimenti per comprendere il codice e i controlli
Python — query SQLite parametrizzate spiega la separazione tra la query e i suoi valori. Python — booleani precisa il legame tra bool e int, e Python — hashlib documenta il calcolo delle impronte.
Docker Compose — services descrive le opzioni di esecuzione e mount. llama.cpp — server presenta l'inferenza e gli output vincolati. JSON Schema — enum dettaglia la restrizione di un campo a una lista di valori.