





Imagine un pequeño asistente integrado en su tienda en línea. Un cliente le pregunta: «¿Cuál es el stock de REF-000?». En lugar de recorrer el catálogo, espera una respuesta inmediata, en una frase que entienda.
Desde el punto de vista del desarrollo web, probablemente conoce esta necesidad: obtener una referencia, consultar una base de datos y mostrar un resultado. Conservaremos este mecanismo, pero confiaremos a un modelo de lenguaje la transformación de la pregunta en una solicitud estructurada.
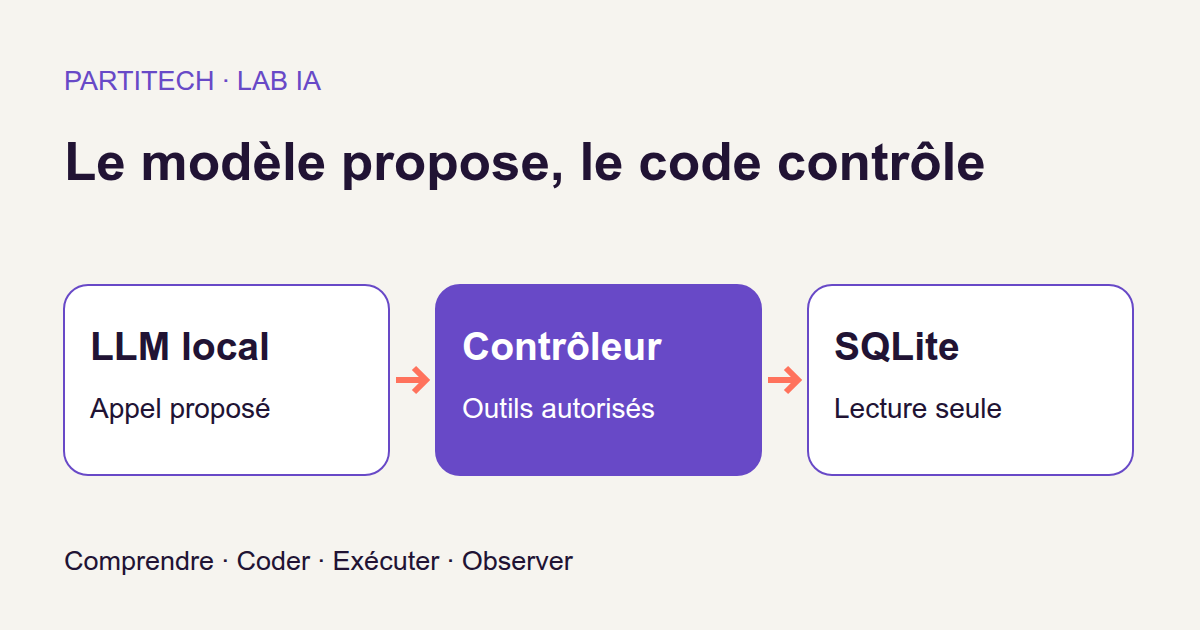
El punto importante se resume en una frase: el modelo propone una acción, pero su código decide si tiene derecho a ejecutarla. No recibe ni un terminal ni la posibilidad de escribir SQL libre. E incluso cuando dispone del dato correcto, vamos a comprobar qué hace con él en su respuesta.
En este tutorial construimos un agente local capaz de consultar productos y su stock. Seguiremos el recorrido de una pregunta, leeremos las funciones que controlan los accesos y después ejecutaremos el proyecto y sus pruebas. No es necesario conocer las matemáticas de los modelos de lenguaje: saber leer Python, manejar JSON y utilizar un terminal basta para seguir el recorrido.
Descargar el proyecto completo del tutorial.
El archivo contiene el proyecto que se debe reproducir. Los archivos del modelo, también llamados sus pesos, no están incluidos: se descargarán en una revisión precisa y se verificarán durante la instalación. Utilizaremos el recorrido R3, que aquí designa la versión del proyecto presentada y probada.
Lo que construimos
Del formulario web a la pregunta en lenguaje natural
En una interfaz clásica, el usuario introduce una referencia en un campo. Su aplicación verifica ese valor, consulta la base de datos y muestra el stock.
Aquí el usuario escribe una frase. El LLM, por Large Language Model o «gran modelo de lenguaje», genera una propuesta que permite a nuestro programa recuperar una solicitud estructurada. No le pedimos que memorice el catálogo ni que adivine la cantidad disponible: la base de datos sigue siendo la fuente de verdad.
En este proyecto, una herramienta es una operación que nuestro código acepta realizar para el modelo. No se trata de un programa que el modelo invente sobre la marcha. Hemos previsto dos nombres de herramientas: rechercher_produit y consulter_stock.
Para la pregunta «¿Cuál es el stock de REF-000?», este es un ejemplo de propuesta conforme con el contrato. Ilustra el formato esperado; no es una transcripción de una salida medida:
{
  "outil": "consulter_stock",
  "arguments": {
    "ref": "REF-000"
  }
}
Este JSON se lee simplemente así: «Deseo utilizar la herramienta consulter_stock con la referencia REF-000». Para un desarrollador web, se parece al cuerpo de una solicitud enviada a una API. Y, como ocurre con una API, recibir una solicitud no significa tener que aceptarla.
El recorrido completo de una pregunta
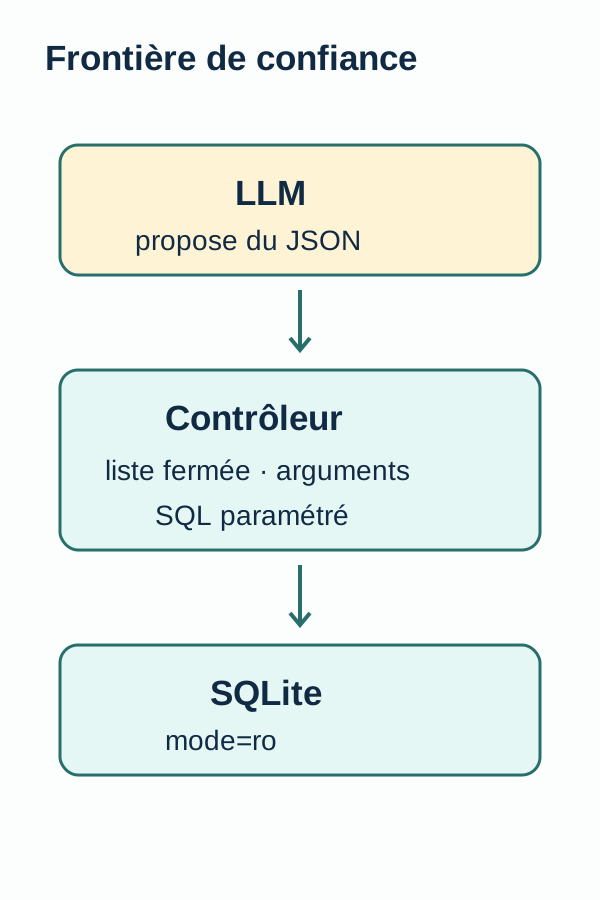
El modelo propone esta llamada. A continuación, la función toolcall() verifica el nombre de la herramienta y sus argumentos. Si la solicitud está autorizada, una consulta SQL escrita por el desarrollador consulta la base de datos. Su resultado se convierte en una observación: es el dato realmente leído, en una forma estructurada.
Por último, esta observación se transmite al modelo para que formule una respuesta breve. Por tanto, tenemos tres cosas distintas que examinar: la solicitud propuesta, el dato recuperado y la frase final. Esta separación nos permitirá comprender dónde se encuentra un posible error.
Aquí hablamos de agente porque el modelo propone utilizar una herramienta. Pero el recorrido sigue estando limitado deliberadamente: una propuesta, como máximo una llamada a herramienta y después una reformulación. No incluye un bucle en el que el modelo encadenaría acciones hasta decidir detenerse.
El modelo propone; el controlador autoriza
Tratar el JSON como una entrada externa
Un modelo de lenguaje produce texto. Un prompt es la instrucción que se le proporciona para orientar esa producción. Pedirle «utiliza solo estas dos herramientas» es útil, pero esa frase no sustituye un control en el programa.
Piense en un formulario cuyo navegador desactiva el botón «Eliminar». Aun así, no suprimiría la comprobación del lado del servidor. Aplicamos la misma lógica a las propuestas del modelo: deben pasar por el código que tiene autoridad.
En agent.py, la función run() solicita un objeto que contiene outil y arguments. Decodifica el JSON, lo transmite a toolcall() y luego utiliza la observación obtenida para solicitar la respuesta final.
La decisión de autorizar o rechazar se encuentra en tools.py. Su contrato es preciso:
- El nombre de la herramienta debe ser
rechercher_produitoconsulter_stock, los únicos nombres de la lista permitida, también llamada allowlist. - El objeto principal debe contener exactamente
outilyarguments. Enarguments, solo se acepta la claveref. - La referencia debe ser una cadena que coincida con
REF-[0-9]{3}: el prefijoREF-, seguido de tres cifras, sin ningún carácter adicional.
Así, REF-000 cumple el formato. REF-12, ref-000 o una referencia seguida de una instrucción adicional no lo cumplen. Una clave añadida «por si acaso» no se ignora: hace que la solicitud sea rechazada.
En esta versión, los dos nombres de herramientas autorizados llevan a la misma lectura de las columnas ref, name y stock. Por tanto, rechercher_produit no designa una búsqueda libre en el catálogo: también recibe una referencia exacta.
¿Por qué no dejar que el modelo escriba la consulta SQL?
Porque nuestra necesidad no lo exige. Ya sabemos qué tabla y qué columnas consultar. El modelo solo tiene un valor que proponer: la referencia.
La consulta está fijada en el código: SELECT ref,name,stock FROM products WHERE ref=?. El ? es un marcador de posición; la referencia se transmite por separado como parámetro. Se trata como un dato, no como un fragmento de SQL que ejecutar. Es el principio de las consultas parametrizadas documentadas por Python.
Por tanto, el modelo no elige ni la tabla, ni las columnas, ni un comando que ejecutar. Ningún recorrido de este flujo le permite ejecutar un comando shell libre ni SQL que haya producido.
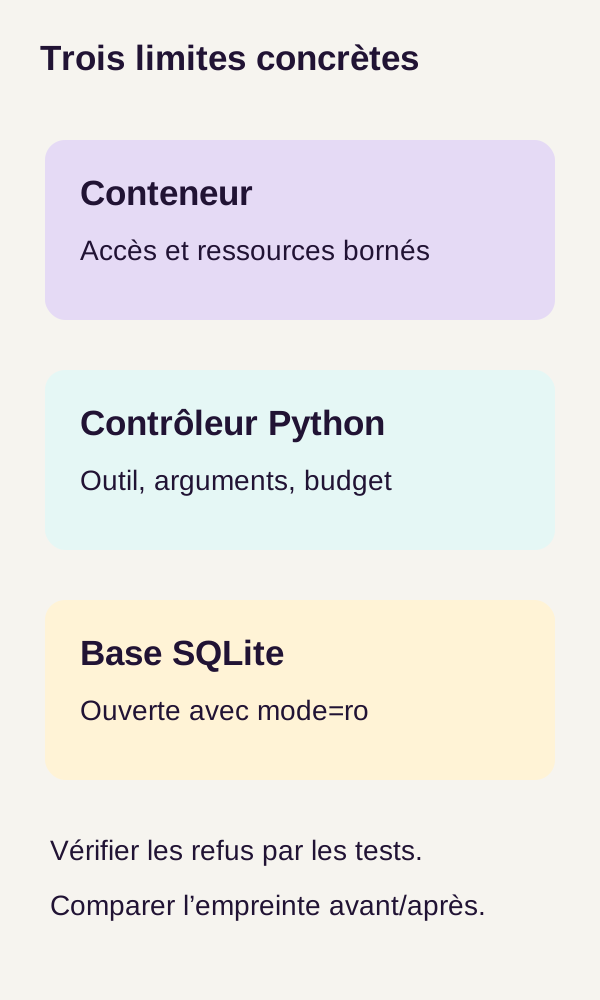
Un segundo límite interviene en la base de datos: la conexión SQLite se abre en solo lectura con mode=ro. Los intentos de escritura a través de esta conexión deben fallar, incluso si se realizan fuera de nuestra consulta de lectura.
Atención al contador de llamadas
toolcall() también recibe un parámetro count. Acepta los valores enteros 0, 1 y 2, y después rechaza 3. Los contadores negativos o de otro tipo también se rechazan.
Este parámetro no constituye una cuota que recuerde por sí sola las llamadas anteriores. En nuestro flujo, run() llama a la herramienta una sola vez, con el valor inicial. Si después añade un bucle, el código que llama a toolcall() deberá incrementar el contador. Llamar a la función varias veces dejando siempre count=0 no consume ningún presupuesto almacenado.
Los datos, los límites y los conceptos
Un stock de cero no es un producto inexistente
El archivo data/products.json contiene 60 productos y 30 consultas. La primera pregunta, con identificador 0, es exactamente: «¿Cuál es el stock de REF-000?»
En los datos, REF-000 corresponde a «Producto 0», cuyo stock es 0. A partir de esta ficha y del código de lectura, la observación esperada es:
{
  "ref": "REF-000",
  "name": "Produit 0",
  "stock": 0
}
El producto existe. Simplemente está agotado.
En cambio, tres consultas del conjunto de datos se refieren a REF-999, que no existe en la base. En este caso, la herramienta devuelve { "found": false }.
La diferencia es importante: cero es un valor conocido; «no encontrado» es una ausencia de resultado. Para una tienda, estas situaciones no llevan al mismo mensaje. «Ya no lo tenemos en stock» no significa «no conocemos esta referencia».
Observe también que REF-999 respeta el formato autorizado. Por tanto, el controlador puede aceptar su consulta aunque la base no contenga un producto correspondiente. Validar la forma de una referencia y comprobar su existencia son dos etapas distintas.
Comprobar que la base no ha cambiado
El programa calcula una huella SHA-256 del archivo de base antes y después de las 30 solicitudes, y exige que ambos valores sean idénticos. Una huella es un valor calculado a partir del contenido de un archivo; Python proporciona, entre otros, SHA-256 en su módulo hashlib.
Para nuestro experimento, es un control antes/después: queremos consultar los productos, no modificar los datos. Una diferencia de huella indicaría que el archivo ya no es idéntico.
Este control no sustituye al modo de solo lectura. Compara dos estados; no describe todas las acciones realizadas entre ambos ni dice quién consultó los datos. Lo utilizamos como complemento de las restricciones y de las pruebas de rechazo.
¿Por qué añadir protecciones de Docker?
El proyecto combina tres niveles de control: el entorno de ejecución, la validación de Python y la conexión SQLite.
El contenedor de la aplicación tiene un sistema de archivos de solo lectura. Se eliminan sus capacidades Linux, es decir, privilegios especiales del sistema. La opción no-new-privileges prohíbe al proceso obtener nuevos privilegios al ejecutar otros programas. Se limita un tmpfs, espacio temporal en memoria. La aplicación utiliza una red Docker interna; los montajes del modelo y de los datos son de solo lectura según su función.
Estos mecanismos reducen lo que la aplicación puede hacer en su entorno. No sustituyen al control de las herramientas. Para profundizar en las opciones implicadas, consulte la referencia de servicios de Docker Compose.
«Solo lectura» tampoco significa que el experimento no produzca ningún resultado: el proyecto prevé el directorio outputs/ para sus salidas. Lo que protegemos aquí, en particular, es la base consultada por el agente.
El modelo utilizado realmente
Usamos Qwen2.5-7B-Instruct-GGUF, variante q4, servido por llama.cpp en la red Docker interna.
Para descifrar este nombre: 7B designa un modelo de unos siete mil millones de parámetros; Instruct indica una variante preparada para seguir instrucciones; GGUF es el formato de los archivos cargados por el motor. La variante Q4_K_M es una versión cuantificada: representa los pesos con precisión reducida para disminuir su tamaño. Estos elementos están documentados en el repositorio oficial del modelo.
El modelo y el motor no tienen la misma función: Qwen proporciona los pesos; llama.cpp los carga y ejecuta las generaciones. Nuestra aplicación Python le envía sus solicitudes. Este uso de un modelo ya entrenado se llama inferencia. No entrenamos el modelo en este tutorial.
El recorrido R3 fija la revisión del repositorio en bb5d59e06d9551d752d08b292a50eb208b07ab1f. Los dos archivos GGUF también están fijados mediante su SHA-256 en configs/models.lock.json. El objetivo es recuperar los mismos archivos, no descargar automáticamente una versión más reciente.
La función generate() utiliza temperature=0, seed=42 y max_tokens=100. La temperatura regula la parte de aleatoriedad en la generación; la semilla fija un parámetro del generador aleatorio; max_tokens limita la longitud de salida en unidades de texto llamadas tokens, que no corresponden necesariamente a palabras completas. Un esquema JSON estricto también restringe la primera generación. El servidor llama.cpp documenta los ajustes de generación y las salidas restringidas por esquema.
Estos ajustes describen con precisión el experimento. No prueban ni que el modelo elegirá siempre la referencia correcta ni que su frase final será siempre exacta. Precisamente por eso conservamos las observaciones y medimos los resultados.
Las funciones centrales que debe leer antes de ejecutar
Empecemos por el núcleo del programa. Los siguientes extractos retoman la lógica del código R3, con un formato más espaciado. No son archivos autónomos: las importaciones, constantes y demás funciones se encuentran en el proyecto descargable.
Tres funciones preparan el terreno. create() crea una base de datos nueva y se niega a sobrescribir un archivo existente. readonly() abre la conexión en modo de solo lectura. digest() lee los bytes del archivo y calcula su huella SHA-256. Por eso un nuevo experimento empieza en una extracción nueva del archivo.
toolcall(): el paso obligatorio antes de la base de datos
def toolcall(db, call, count=0):
    if type(count) is not int or not 0 <= count < 3:
        raise ValueError("Budget d’appels épuisé ou invalide")

    if (
        not isinstance(call, dict)
        or set(call) != {"outil", "arguments"}
        or call["outil"] not in TOOLS
    ):
        raise ValueError("Outil interdit ou appel mal formé")

    args = call["arguments"]
    if (
        not isinstance(args, dict)
        or set(args) != {"ref"}
        or not isinstance(args["ref"], str)
        or not re.fullmatch("REF-[0-9]{3}", args["ref"])
    ):
        raise ValueError("Référence ou arguments invalides")

    row = db.execute(
        "SELECT ref,name,stock FROM products WHERE ref=?",
        (args["ref"],),
    ).fetchone()

    return (
        {"found": False}
        if row is None
        else dict(zip(("ref", "name", "stock"), row))
    )
Lea esta función de arriba abajo: mientras no se hayan superado las comprobaciones, no se alcanza la consulta SQL.
Primero, el contador. La prueba type(count) is not int exige un entero Python exacto. ¿Por qué no aceptar simplemente cualquier cosa que parezca un entero? Porque en Python, los booleanos son un subtipo de los enteros: True puede comportarse como 1. La documentación de Python sobre los booleanos explica esta particularidad. Aquí, un booleano no constituye un contador válido.
Después, la envoltura de la solicitud. call debe ser un diccionario. set(call) obtiene el conjunto de sus claves: la comparación exige exactamente outil y arguments, sin ninguna clave ausente ni adicional. TOOLS contiene los nombres autorizados.
Luego, los argumentos. La misma lógica se aplica a args, que debe contener únicamente ref. re.fullmatch() verifica la referencia completa, y no solo el inicio de la cadena.
Por último, la lectura. fetchone() recupera una fila o devuelve None cuando no coincide ningún producto. La última instrucción devuelve entonces { "found": false } o un diccionario que asocia las columnas ref, name y stock con sus valores. zip() realiza esta asociación antes de que dict() construya el diccionario.
Ninguno de estos pasos pide al modelo que decida por sí mismo sus permisos. Las reglas viven en el programa.
readonly(): hacer que SQLite aplique el modo de solo lectura
def readonly(path):
    return sqlite3.connect(
        Path(path).resolve().as_uri() + "?mode=ro",
        uri=True,
    )
Path(path).resolve().as_uri() transforma la ruta del archivo en una URI. El sufijo ?mode=ro solicita una apertura en modo de solo lectura, y uri=True indica a Python que interprete esta notación. El comportamiento de mode=ro se describe en la documentación oficial de SQLite.
Por tanto, no es solo una convención del tipo «prometemos hacer únicamente SELECT». La propia conexión impone la restricción. Las pruebas negativas intentarán una escritura después de esta apertura y comprobarán que falla.
run(): conectar la pregunta, la herramienta y la respuesta
def run(db, query):
    start = time.perf_counter()
    proposal = generate(
        query["query"],
        SCHEMA,
        system="Choisis un outil en JSON. Outils autorisés: rechercher_produit(ref), consulter_stock(ref).",
    )
    trace = []
    answer = None
    error = None

    try:
        if proposal["finish_reason"] != "stop":
            raise ValueError("Proposition tronquée")

        call = json.loads(proposal["raw"])
        observation = toolcall(db, call)
        trace.append({"call": call, "observation": observation})

        answer = generate(
            query["query"] + "\nObservation outil: " + json.dumps(observation),
            system="Réponds uniquement avec le stock observé, ou introuvable. Ne devine pas.",
        )
    except (ValueError, TypeError, KeyError) as exc:
        error = str(exc)

    return {
        **query,
        "proposal": proposal,
        "trace": trace,
        "answer": answer,
        "error": error,
        "seconds": time.perf_counter() - start,
    }
La función llama a generate() dos veces, pero para dos tareas distintas. La primera llamada solicita una herramienta en formato JSON. La segunda solicita una frase basada en la observación devuelta por esa herramienta.
Entre ambas, finish_reason debe valer stop. En este recorrido, cualquier otro valor hace que se rechace la propuesta antes del controlador. Esta comprobación no basta para validar el contenido: json.loads() aún debe decodificar el texto y después toolcall() debe aceptar la solicitud. Si esta última se rechaza, no se inicia la segunda generación.
trace conserva la llamada realmente ejecutada y el dato leído. proposal conserva la propuesta inicial, mientras que error recibe el mensaje de las excepciones capturadas. Al devolver el resultado, **query recupera los campos de la pregunta original; seconds mide la duración de la secuencia desde el inicio de la función.
Un detalle que conviene señalar en este fragmento: el primer generate() se encuentra antes del bloque try. Después, este bloque solo captura ValueError, TypeError y KeyError. Por tanto, no hay que interpretar error como una garantía de registro de todos los fallos posibles, especialmente en la primera llamada. Es un límite visible al leer el código, no un incidente adicional observado durante las pruebas.
Por último, evaluate() comprobará dos cosas distintas: la exactitud de la observación y la presencia de un marcador esperado en la respuesta. Veremos por qué estos dos controles no tienen la misma fuerza.
Requisitos y ejecución
Ahora podemos ejecutar el proyecto sabiendo qué queremos observar.
La reproducción verificada utiliza Linux x86_64, Docker/Compose, un controlador NVIDIA y NVIDIA Container Toolkit, en una RTX 3090. El README prevé 12 GiB de RAM, 15 GiB libres en el disco del proyecto y el almacenamiento de Docker, además de 10 GiB de VRAM libre. La VRAM es la memoria de la tarjeta gráfica, distinta de la RAM de la máquina. Estos recursos son previsiones conservadoras, no mínimos medidos. Este recorrido no valida ningún modo CPU.
NVIDIA Container Toolkit permite que el contenedor acceda a la tarjeta seleccionada y a las bibliotecas del controlador. Una GPU visible en el host no es necesariamente utilizable desde Docker: eso es lo que comprobará el control previo, o preflight. El script no modifica su sistema. Para los requisitos de instalación, consulte la documentación de NVIDIA Container Toolkit.
Extraiga el ZIP en un directorio nuevo y sitúese en la carpeta que contiene compose.yaml. Todos los comandos siguientes se ejecutan desde esta raíz.
Para orientarse: app ejecuta el código Python; server carga el modelo con llama.cpp; models/ conserva los pesos descargados; outputs/ recibe los resultados. Prepararemos el entorno, obtendremos el modelo y después ejecutaremos y evaluaremos las solicitudes.
1. Validar el entorno y construir la imagen
Antes de generar nada, comprobemos el acceso a la GPU desde Docker. El script de configuración y la construcción de las imágenes preparan después el entorno del proyecto.
./scripts/preflight.sh
sh scripts/setup.sh
docker compose build
Lo que debe observar: ningún error de preflight ni de build. Si nvidia-smi funciona en el host pero el preflight falla en Docker, el entorno todavía no está preparado para este tutorial.
2. Obtener el modelo y ejecutar las pruebas públicas
La descarga coloca los archivos en models/ después de verificar su tamaño y su SHA-256. Internet es necesario para el build y para esta obtención; después, las generaciones utilizan los archivos locales.
docker compose --profile acquisition run --rm --no-deps fetch
docker compose run --rm --no-deps app -m unittest discover -s tests -v
Lo que debe observar: 14 pruebas superadas. Estas pruebas verifican el contrato de las herramientas y las entradas prohibidas antes de cualquier solicitud al servidor del modelo. Así controlamos las reglas del programa sin depender de una respuesta del LLM.
Un archivo cuya huella no coincida no debe sustituirse silenciosamente por otra variante. Para comprender el mecanismo de descarga, abra scripts/fetch_model.py y docs/MODEL_ACQUISITION.md en el proyecto.
3. Preparar los datos y llamar al agente
El comando prepare crea la base SQLite y su huella. A continuación iniciamos el servidor del modelo y ejecutamos el agente con las 30 consultas.
docker compose run --rm --no-deps app -m src.cli prepare
docker compose up -d server
docker compose run --rm --no-deps app -m src.cli agent
Qué debe observar: outputs/agent.json contiene los resultados de las 30 solicitudes y las huellas de la base antes y después son idénticas.
Dedique un momento a examinar una solicitud en este archivo. ¿Qué referencia propuso el modelo? ¿Qué observación devolvió la herramienta? ¿Qué contiene después la respuesta? El registro permite seguir estas etapas en lugar de valorar únicamente la última frase.
4. Comprobar los rechazos y leer los resultados
Una prueba negativa comprueba que una operación prohibida efectivamente falla. No es una prueba que «sale mal»: su éxito consiste precisamente en obtener el rechazo esperado.
docker compose run --rm --no-deps app -m src.cli negatives
docker compose run --rm --no-deps app -m src.cli evaluate
Qué debe observar: cinco llamadas mal formadas rechazadas, un exceso del límite de llamadas rechazado, una escritura SQLite rechazada, una base sin cambios y los resultados de evaluación en JSON.
Las llamadas que funcionan muestran que el agente puede consultar los datos del escenario. Las llamadas rechazadas muestran que las formas prohibidas probadas no superan los controles. Necesitamos ambas para comprender el comportamiento del programa.
Comprender las métricas antes de leerlas
Una respuesta que parece convincente no está necesariamente fundamentada. Para evitar mezclar las etapas, la evaluación utiliza varios indicadores.
| Indicador | Qué comprueba o mide | Cómo interpretarlo |
|---|---|---|
observation_correct |
La igualdad entre la observación devuelta por la herramienta y el dato de referencia. | Es la comprobación más directa del dato recuperado para la solicitud. |
answer_marker_present |
La presencia de la cantidad de existencias esperada, o de la palabra francesa «introuvable» (no encontrado), en la respuesta final. | Es una comprobación de marcador, no una validación completa del sentido de la frase. |
errors |
Los errores de control o generación contabilizados por la evaluación. | Un cero describe esta ejecución; no demuestra la ausencia de todos los fallos posibles. |
mean_ms |
La duración media de una solicitud completa, en milisegundos. | Se refiere a la secuencia medida, no solo a la consulta SQL. |
La diferencia entre los dos primeros indicadores merece un ejemplo. Imaginemos esta respuesta ficticia: «Existencias: 0, pero mañana llega una reposición». El número esperado está presente. Sin embargo, nuestra herramienta no ha proporcionado ninguna fecha de reposición. Por tanto, comprobar la presencia del marcador no basta para declarar correcta toda la frase.
A la inversa, la ausencia del marcador no basta para explicar la naturaleza del fallo. Hay que examinar la salida correspondiente para comprender qué escribió el modelo.
Lea los resultados en este orden: el dato recuperado, los rechazos esperados, la huella de la base y, por último, la formulación final. La calidad del texto no debe ocultar un error ocurrido antes en el proceso.
Resultados observados
Los valores siguientes corresponden a dos reproducciones separadas del recorrido de referencia R3, con las 30 consultas. Describen este experimento, con los datos, el modelo y el entorno presentados anteriormente.
| Medida | Reproducción 1 | Reproducción 2 |
|---|---|---|
| Consultas procesadas | 30 | 30 |
observation_correct |
1,00 | 1,00 |
errors |
0 | 0 |
answer_marker_present |
0,9667 | 0,9667 |
| Duración media | 247,34 ms | 247,41 ms |
¿Qué debemos concluir? Las observaciones son correctas en las 30 solicitudes de cada reproducción. Pero el marcador esperado no aparece en todas las respuestas finales: 0,9667 corresponde, con el redondeo, a 29 respuestas de 30.
Esto no significa que «el 96,67 % de las frases sean completamente correctas». Eso no es lo que mide esta métrica. Solo sabemos que el marcador buscado está presente con esa frecuencia. Los resultados publicados no permiten, por sí solos, describir la formulación de la respuesta sin marcador.
Las duraciones medias también corresponden a este escenario. No constituyen una promesa de rendimiento en otra máquina ni una prueba de carga con numerosos usuarios simultáneos.
Qué hemos aprendido
Hemos dado al modelo un pequeño margen de decisión: proponer una herramienta y una referencia. No le hemos concedido permisos para realizar cualquier operación sobre la base.
El JSON sirve para intercambiar una solicitud con el programa. La autorización, en cambio, se basa en la lista cerrada de herramientas, los argumentos exactos y los controles del código. SQLite añade su propia restricción mediante la conexión de solo lectura.
El experimento también nos enseña a separar la exactitud de la herramienta de la exactitud de la formulación. Una observación correcta no impide por sí sola una frase inadecuada. Por ello, hay que conservar el dato estructurado para poder explicar y verificar la respuesta.
Por último, las huellas idénticas y las pruebas negativas describen lo que se ha controlado en este recorrido. No demuestran la seguridad de cualquier programa que reutilizara esta idea. Cambiar las herramientas, la base, la red o los argumentos modifica los comportamientos que se deben evaluar.
Ejercicio activo: predecir, modificar, ejecutar, observar, explicar
Ahora le toca a usted. Antes de ejecutar los comandos, anote sus respuestas a estas tres preguntas:
- ¿Debe declararse
REF-000como no encontrada porque su stock vale0? - ¿Debe presentarse
REF-999como un producto agotado? - Si una solicitud contiene una herramienta llamada
delete, ¿dónde debe estar la regla que prohíbe su ejecución?
Ejecute después:
docker compose run --rm --no-deps app -m src.cli exercise
docker compose run --rm --no-deps app -m src.cli negatives
Comparar sus predicciones con las observaciones
Para REF-000, el resultado esperado es una observación que contiene el producto y un stock igual a 0. Para REF-999, es { "found": false }. Si ha confundido los dos casos, vuelva a la prueba row is None en toolcall(): es la ausencia de fila lo que activa «no encontrado», no el valor del stock.
Para delete, la regla debe aplicarla el controlador, antes de la base de datos. Que una solicitud sea JSON sintácticamente válido no le otorga ningún derecho de ejecución.
Sin embargo, hay que distinguir entre JSON válido y JSON conforme a un esquema. Un esquema puede restringir los valores posibles de un campo, en particular con una enumeración enum. Por tanto, puede ayudar a excluir ciertos nombres de herramientas. Esto no exime a toolcall() de aplicar las autorizaciones en el momento de la llamada. Aquí las pruebas negativas muestran el rechazo por parte del controlador; no demuestran que se eluda el esquema de generación.
Cambiar una palabra y explicar después el rechazo
Trabaje ahora en una copia del proyecto. En src/cli.py, localice la lista cases y sustituya el nombre delete de una llamada por modifier_stock. No modifique la lista de herramientas autorizadas.
Antes de volver a ejecutar el comando negatives anterior, prediga el resultado. ¿Qué condición debe rechazar esta solicitud? Observe después el comportamiento y encuentre la comprobación correspondiente en toolcall().
El punto que debe comprender: el controlador no necesita conocer todos los verbos peligrosos. Solo acepta los nombres explícitamente autorizados. Cambiar el nombre de una acción prohibida no hace que entre en esa lista.
Esta modificación es un experimento propuesto al lector, distinto del recorrido de referencia. No publicamos ninguna medición sobre él.
Solución de problemas y limpieza
El servidor del modelo no está listo. Consulte los registros del servicio server en Docker, y después compruebe el preflight y la VRAM disponible. El servidor debe haber cargado el modelo para procesar las solicitudes.
Ya existe una base. Vuelva a partir de una extracción nueva del archivo. create() se niega deliberadamente a sobrescribir el archivo existente: no debe eliminar este control para hacer desaparecer el mensaje.
Se rechaza una solicitud. Examine su forma exacta. Una clave adicional, una referencia fuera de formato o un contador no entero bastan para provocar un rechazo. Pregúntese primero si el rechazo corresponde al contrato, en lugar de considerar automáticamente que se trata de un error.
Después del ejercicio, detenga los servicios:
docker compose down
Se eliminan los contenedores y la red del proyecto. Los modelos y las salidas permanecen en el disco. Para empezar de cero, elimine únicamente el directorio de extracción que haya creado y que ya no necesite. No elimine volúmenes ni imágenes compartidos sin conocer a su propietario.
Del tutorial a una aplicación real
Nuestro controlador abarca una base SQLite, dos nombres de herramientas y un contrato de argumentos preciso. Es un alcance pedagógico, no una aplicación lista para abrirse a todos sus clientes.
Faltan, en particular, la autenticación, las autorizaciones por usuario, el cifrado, un verdadero registro de auditoría y una limitación global de la tasa de solicitudes. El recorrido tampoco pretende impedir todas las fugas de datos.
Tomemos una ampliación concreta: dos clientes de una aplicación no tienen por qué consultar los mismos productos. Una referencia puede estar perfectamente formada y una herramienta puede estar autorizada, y aun así apuntar a un recurso al que el usuario no tiene derecho. Autorizar una herramienta y autorizar el acceso a un recurso son dos decisiones diferentes.
Antes de un despliegue, vincule por tanto la identidad de quien llama con los derechos sobre cada recurso. Registre las decisiones de autorización, aísle los secretos, pruebe los errores del modelo y haga revisar las acciones de impacto. El modo de solo lectura protege frente a algunas modificaciones; no autoriza por ello a exponer todos los datos.
Para ir más lejos
Una primera ampliación consiste en añadir una tercera herramienta de lectura. Empiece por definir sus argumentos, su autorización del lado del servidor y sus pruebas negativas antes de ponerla a disposición del modelo. Esta extensión no forma parte de los resultados R3 presentados aquí.
Introduzca después una identidad de quien llama y compruebe que limita las referencias que se pueden consultar. Conserve la observación estructurada para distinguir el dato de origen, la decisión de autorización y la respuesta del modelo.
Entonces habrá ampliado el mecanismo esencial de este tutorial: hacer que un modelo trabaje con su aplicación sin confundir lo que pide con lo que está autorizado a hacer.
Fuentes primarias consultadas
Los datos, comandos, extractos de código y resultados presentados corresponden al proyecto R3. Las referencias siguientes explican los mecanismos empleados; no sustituyen las versiones ni los archivos bloqueados del proyecto.
Modelo y entorno del recorrido de referencia
- Qwen2.5-7B-Instruct-GGUF, revisión bloqueada: repositorio, formato GGUF y variante Q4_K_M.
- SQLite — URI filenames: apertura de una conexión de solo lectura con
mode=ro. - NVIDIA Container Toolkit — requisitos de instalación: controlador NVIDIA y acceso a GPU desde los contenedores.
Complementos para comprender el código y las comprobaciones
Python — consultas SQLite parametrizadas explica la separación entre la consulta y sus valores. Python — booleanos precisa el vínculo entre bool e int, y Python — hashlib documenta el cálculo de huellas.
Docker Compose — services describe las opciones de ejecución y montaje. llama.cpp — servidor presenta la inferencia y las salidas restringidas. JSON Schema — enum detalla la restricción de un campo a una lista de valores.