





Imaginez le portail documentaire d'un fabricant. Vous avez déjà le back-office, les notices et les droits d'accès. Vous aimeriez maintenant exploiter ces textes avec un modèle de langage, mais les références de machines et le vocabulaire technique ne ressemblent pas toujours à ce qu'il a rencontré pendant son apprentissage initial.
Une piste consiste à lui faire étudier les notices. Pas en lui demandant de les lire dans un prompt, mais en poursuivant son entraînement : nous cachons certaines parties du texte, puis nous lui demandons de les retrouver.
Cela ressemble à un exercice à trous. La difficulté intéressante arrive ensuite : le modèle progresse-t-il sur les notices sans régresser sur d'autres textes ? Et comment le savoir si les trous changent à chaque évaluation ?
Dans ce tutoriel, nous allons adapter BERT à un domaine, comparer une variante avec des révisions régulières d'un corpus de contrôle, puis mesurer les deux effets avec un examen identique pour chaque modèle. Les notices sont synthétiques : nous étudions un mécanisme d'apprentissage, pas un assistant de maintenance prêt à être déployé.
Télécharger le projet complet du tutoriel
Ce que nous construisons
Le projet compare trois états d'un même modèle. La référence, ou baseline, correspond au modèle avant notre adaptation. La deuxième voie poursuit son apprentissage sur les documents du domaine. La troisième y ajoute du replay : des blocs du corpus de contrôle reviennent périodiquement dans les lots d'entraînement.
Un checkpoint est un état sauvegardé du modèle ; pour reprendre un entraînement, il faut aussi les autres états nécessaires au calcul. Nous reviendrons sur cette distinction au moment de la reprise.
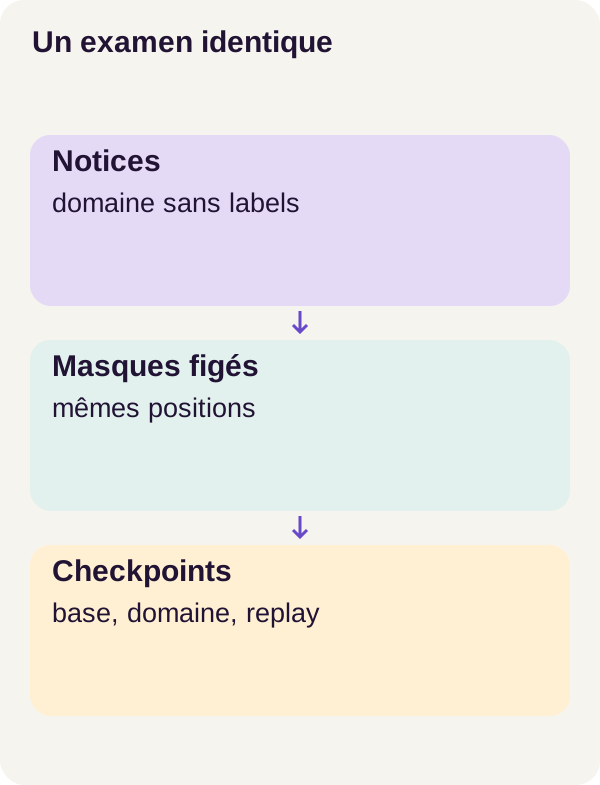
Avant de comparer ces checkpoints, le programme prépare les mêmes textes d'évaluation et les mêmes positions à prédire. Il mesure ensuite deux choses, séparément sur le domaine et sur le contrôle : la probabilité accordée aux tokens attendus, résumée par la NLL, et la fréquence à laquelle le meilleur choix du modèle est le bon, appelée exactitude top-1.
À la fin, vous saurez suivre le chemin texte → tokens → entrée partiellement corrompue → prédictions → métriques. Vous saurez également distinguer une amélioration sur cet exercice d'une capacité à répondre correctement à une question métier. Le programme ne construit ni le portail évoqué en introduction, ni un système de décision industrielle.
Concepts expliqués
Un token n'est pas forcément un mot
Le modèle ne reçoit pas directement une chaîne Python. Un tokenizer découpe le texte en unités de vocabulaire, les tokens, puis leur associe des identifiants numériques. Une unité peut représenter un mot, un fragment de mot ou un signe. Dans ce projet, nous travaillons sur des IDs de sous-mots.
Pensez à une conversion de représentation : votre application manipule du texte ; le modèle manipule des tableaux d'entiers. Un ID désigne une entrée de vocabulaire. Sa valeur numérique n'indique pas, à elle seule, le sens du token.
La variante utilisée est google-bert/bert-base-uncased. Sa fiche officielle précise qu'elle a été préentraînée en anglais et qu'elle ne distingue pas les majuscules des minuscules. Les explications françaises de cet article ne changent ni ce modèle ni les données de référence.
Apprendre avec un exercice à trous
Un masked language model, ou MLM, cherche à retrouver des tokens à partir de leur contexte. BERT peut utiliser le texte situé avant et après la position à prédire. Il ne réalise donc pas ici le même exercice qu'un modèle qui doit uniquement écrire la suite d'un texte. Ce principe est décrit dans l'article de BERT et le guide Hugging Face sur le MLM.
Pour représenter l'idée, imaginons cette phrase à trous : « La température documentée est de [MASK] degrés. » Le modèle doit proposer ce qui manque à partir du contexte. C'est une illustration du mécanisme, pas une sortie mesurée ni une tokenisation BERT réelle.
Mais où trouve-t-on la bonne réponse, puisque les notices ne sont pas étiquetées ? Dans le texte original, avant de le modifier. Le programme conserve l'identifiant du token attendu, puis altère son emplacement dans l'entrée. Il fabrique ainsi automatiquement l'exemple et son corrigé : on parle d'apprentissage auto-supervisé.
« Sans étiquettes manuelles » ne signifie donc pas « sans cibles d'apprentissage ». Ici, aucune personne n'a besoin d'annoter chaque phrase avec une catégorie ; les tokens d'origine jouent le rôle de labels.
Ce que l'entraînement modifie
À chaque position, le modèle produit des logits : des scores pour les tokens possibles. Le softmax transforme ces scores en une distribution de probabilités. La perte, ou loss, pénalise le modèle lorsqu'il accorde trop peu de probabilité au token de référence.
La rétropropagation calcule les gradients, c'est-à-dire la sensibilité de cette perte aux paramètres du réseau. L'optimiseur utilise ces gradients pour modifier les poids, les nombres appris qui déterminent le comportement du modèle. Un lot, ou batch, regroupe plusieurs exemples traités lors d'un calcul.
Nous ne repartons pas de poids aléatoires : BERT possède déjà un apprentissage initial. Nous continuons un objectif de langage sur un corpus spécialisé. C'est une adaptation de domaine par poursuite du préentraînement, étudiée notamment dans Don't Stop Pretraining.
Ce n'est pas encore un entraînement supervisé à répondre à des questions techniques. Retrouver un token dans une notice et choisir une procédure correcte face à une demande sont deux tâches différentes. Le tutoriel mesure seulement la première.
S'adapter sans tout miser sur le nouveau domaine
En entraînant le modèle sur les notices, nous modifions des poids qui participaient aussi à ses prédictions sur d'autres textes. Ses résultats peuvent donc progresser ici et se dégrader ailleurs.
L'oubli catastrophique désigne ce problème de perte de performances au fil de nouveaux apprentissages. Dans notre expérience, nous observons un indicateur plus restreint : une éventuelle dégradation sur le corpus de contrôle choisi. Nous ne mesurons pas l'ensemble des connaissances antérieures de BERT.
Le replay joue le rôle de révisions intercalées : au lieu de ne travailler que le nouveau sujet, l'entraînement rencontre aussi des exemples du contrôle. Il ne restaure pas d'anciens poids et n'interroge pas un second modèle. Dans r1, la variante modifie le programme de lots, pas le principe du MLM.
Enfin, la comparaison doit porter sur le même examen. Pour un développeur web, l'analogie est une suite de tests de non-régression : changer les cas de test en même temps que l'implémentation empêche d'isoler ce qui a produit le changement de score.
Prérequis Docker et GPU
Vous devez pouvoir lire des fonctions Python, des listes, des dictionnaires et du JSON, et utiliser un terminal avec Docker. Les notions d'apprentissage nécessaires sont expliquées dans le parcours.
La reproduction r1 utilise Linux x86_64, Docker Compose, NVIDIA Container Toolkit et une RTX 3090 de 24 Gio. Prévoyez 16 Gio de RAM et 16 Gio de disque, hors couches Docker partagées. Ce sont les provisions du projet, pas des minima mesurés ; aucun parcours CPU n'est validé ici.
locks/models.lock.json fixe google-bert/bert-base-uncased à la révision 86b5e0934494bd15c9632b12f734a8a67f723594. locks/environment.lock.json décrit l'environnement. Comme un fichier de dépendances verrouillées dans un projet web, ces fichiers permettent d'identifier la recette utilisée : ne remplacez pas une version pour faire disparaître silencieusement une erreur.
Le service acquire télécharge les actifs publics. Le service gpu effectue les calculs locaux sans réseau. Le script check_environment.py initialise CUDA, l'environnement de calcul NVIDIA, depuis le conteneur. Une carte visible sur l'hôte ne suffit pas ; Docker doit aussi pouvoir l'utiliser. Le guide GPU de Docker Compose explique cette intégration.
Données et fonction centrale
Qu'allons-nous réellement compter ?
Un corpus est un ensemble de documents. Un split est une partition de cet ensemble : l'entraînement sert à modifier le modèle, la validation à suivre les choix de développement, et le test à l'évaluation finale. Le domaine et le contrôle possèdent chacun une validation et un test.
Voici les effectifs conservés dans l'évaluation r1. Il s'agit de positions supervisées, c'est-à-dire de tokens sur lesquels porte le score, et non de nombres de documents ou de questions.
| Partition | Tokens évalués | Rôle |
|---|---|---|
domain-validation |
3 089 | Suivre l'adaptation sur le domaine |
domain-test |
3 054 | Mesurer le résultat final sur le domaine |
control-validation |
1 318 | Suivre les effets sur le contrôle |
control-test |
1 233 | Mesurer le résultat final sur le contrôle |
Les trois checkpoints reçoivent les mêmes positions et les mêmes entrées corrompues pour chaque partition. Le terme « tokens masqués » est un raccourci : nous verrons que certaines positions évaluées restent visibles dans l'entrée.
Un exemple du corpus r1 porte l'identifiant domain-006-0. C'est une notice fictive Velon sur un couplage de pompe : elle demande d'isoler la pompe avant inspection et mentionne une température de service documentée de 62 degrés. Cette information appartient aux données de l'exercice. Ce n'est jamais une consigne pour un équipement réel.
Figer les questions et leur corrigé
L'extrait continu suivant, issu de src/domain_mlm/eval_masks.py, construit le jeu de comparaison puis vérifie qu'il reste identique.
def freeze_evaluation_masks(config):
    tokenizer = AutoTokenizer.from_pretrained("models", local_files_only=True)
    generator = torch.Generator().manual_seed(config["seed"] + 1000)
    sets = {}
    for corpus in ("domain", "control"):
        for split in ("validation", "test"):
            key = corpus + "-" + split
            rows = read_json("outputs/" + key + ".json")
            ids = torch.tensor([r["input_ids"] for r in rows])
            masked, labels, _ = mask_tokens(
                ids, tokenizer, generator, config["mask_probability"]
            )
            sets[key] = [
                {
                    **row,
                    "original_ids": row["input_ids"],
                    "input_ids": masked[i].tolist(),
                    "labels": labels[i].tolist(),
                }
                for i, row in enumerate(rows)
            ]
    target = Path("outputs/eval-masks.json")
    if target.exists():
        assert read_json(target) == sets, "Evaluation masks changed"
    else:
        save_json(target, sets)
Commençons par ce que cette fonction ne fait pas : elle n'appelle pas BERT pour prédire des tokens et ne lance aucun entraînement. Elle prépare les exemples qui seront envoyés aux modèles plus tard.
AutoTokenizer.from_pretrained("models", local_files_only=True) charge le tokenizer déjà acquis dans le répertoire local. Le nom models est ici un chemin, pas une demande de téléchargement automatique.
torch.Generator().manual_seed(config["seed"] + 1000) crée un générateur pseudo-aléatoire dédié. La graine, ou seed, fixe le point de départ de sa suite de tirages. Le décalage + 1000 est un choix du projet : il ne signifie pas « mille masques ».
Les deux boucles parcourent successivement domain-validation, domain-test, control-validation et control-test. torch.tensor(...) transforme les listes d'IDs en un tableau numérique, ou tenseur. Cette construction suppose des lignes de longueur compatible ; l'extrait ne réalise pas lui-même leur mise à longueur.
Après mask_tokens, chaque ligne conserve ses métadonnées grâce à **row, puis trois représentations complémentaires : original_ids pour le texte tokenisé avant transformation, input_ids pour l'entrée corrompue, et labels pour les cibles à retrouver. tolist() rend les tenseurs enregistrables en JSON.
Enfin, outputs/eval-masks.json est créé s'il n'existe pas. S'il existe, le code reconstruit les données attendues et les compare intégralement au contenu enregistré. Une différence provoque Evaluation masks changed au lieu d'écraser silencieusement l'ancien examen. Le parcours r1 annonce également un verrou et des comptes de cibles par split ; leur écriture complémentaire n'apparaît pas dans cet extrait.
Même graine et mêmes masques : deux garanties différentes
Le générateur est partagé par les quatre partitions et avance à chaque tirage. Modifier l'ordre des lignes, leur longueur ou le nombre de tirages peut donc modifier la suite obtenue, même en gardant la même graine initiale. La comparaison du fichier protège les données effectivement préparées, pas seulement une valeur de configuration.
Cette protection a une limite explicite : elle emploie assert. Python peut désactiver les assertions en mode optimisé, notamment avec l'option -O. Gardez le mode d'exécution du parcours ; dans une adaptation de production, un contrôle impératif ne devrait pas dépendre d'assertions désactivables. C'est le comportement décrit dans la documentation Python, et non une modification du code ci-dessus.
Figer les masques élimine une source de variation, pas toutes les autres. Il faut encore conserver le tokenizer, les données, les paramètres d'évaluation et l'environnement. PyTorch rappelle que la même graine ne garantit pas une identité entre toutes les plateformes ou versions.
Fabriquer une entrée et des cibles MLM
Le verrou décrit l'examen. L'extrait continu de src/domain_mlm/collator.py décrit maintenant le mécanisme qui fabrique les entrées et les cibles, également utilisé pour l'entraînement.
def mask_tokens(input_ids, tokenizer, generator, probability=0.15):
    if not 0 <= probability <= 1:
        raise ValueError("Mask probability out of range")
    eligible = torch.ones_like(input_ids, dtype=torch.bool)
    for value in tokenizer.all_special_ids:
        eligible &= input_ids != value
    chosen = (torch.rand(input_ids.shape, generator=generator) < probability) & eligible
    labels = input_ids.clone()
    labels[~chosen] = -100
    corrupted = input_ids.clone()
    choice = torch.rand(input_ids.shape, generator=generator)
    corrupted[chosen & (choice < 0.8)] = tokenizer.mask_token_id
    admissible = torch.tensor(
        [i for i in range(len(tokenizer)) if i not in tokenizer.all_special_ids]
    )
    random_ids = admissible[
        torch.randint(len(admissible), input_ids.shape, generator=generator)
    ]
    random_positions = chosen & (choice >= 0.8) & (choice < 0.9)
    corrupted[random_positions] = random_ids[random_positions]
    return corrupted, labels, eligible
La première étape consiste à distinguer ce qui peut être choisi de ce qui l'a réellement été.
eligible est un tableau de booléens, de la même forme que les IDs. La boucle retire les tokens spéciaux du tokenizer, par exemple les marqueurs de début, de séparation ou de remplissage. Le padding, ou remplissage, sert à compléter les séquences courtes pour former des tableaux de même largeur ; il ne représente pas du texte à retrouver.
chosen applique ensuite un tirage à chaque position et le combine avec eligible. Le paramètre probability vaut 0.15 par défaut dans cette fonction. Lors du gel d'évaluation, l'appelant transmet config["mask_probability"] : c'est donc la configuration verrouillée qu'il faut consulter pour connaître la valeur effective du parcours.
labels commence comme une copie des tokens d'origine. Les positions non choisies deviennent -100. Avec le contrat de cross-entropy de PyTorch, cette valeur signale une cible à ignorer. Elle ne remplace pas le texte dans l'entrée du modèle. Un token non supervisé peut toujours aider à retrouver son voisin grâce au contexte.
Le code crée ensuite corrupted, une copie indépendante de l'entrée. Pour les positions choisies, un second tirage détermine la transformation : en dessous de 0.8, le token devient le marqueur masque ; entre 0.8 et 0.9, il est remplacé par un token aléatoire admissible ; à partir de 0.9, il reste inchangé.
Nous retrouvons donc la répartition 80 % masque, 10 % remplacement aléatoire, 10 % inchangé, parmi les positions choisies. Ce sont des probabilités, pas des quotas exacts imposés à chaque lot. Si la sélection vaut 15 %, les proportions attendues sur les positions éligibles sont respectivement 15 % × 80 % = 12 %, 1,5 % et 1,5 %.
Un détail compte : admissible exclut les IDs spéciaux, mais pas l'ID d'origine de chaque position. Le tirage aléatoire peut donc retomber sur le token original. Observer une entrée inchangée ne suffit pas à déterminer quelle branche a été tirée.
Suivre une ligne sans charger BERT
Voici un exemple pédagogique construit à la main avec des IDs fictifs. Il n'utilise pas le vocabulaire réel de BERT et ne provient pas des résultats r1. Nous choisissons trois positions pour montrer les trois branches ; nous ne cherchons pas à reproduire leurs fréquences avec une si petite ligne.
| Position | ID original | Éligible ? | Choisie ? | ID fourni au modèle | Label | Explication |
|---|---|---|---|---|---|---|
| 0 | 1, début | Non | Non | 1 | -100 | Marqueur spécial |
| 1 | 7 | Oui | Oui | 3, masque | 7 | Le modèle doit retrouver 7 |
| 2 | 8 | Oui | Oui | 12 | 8 | Le remplacement ne change pas le corrigé |
| 3 | 9 | Oui | Oui | 9 | 9 | Le token reste visible mais est évalué |
| 4 | 10 | Oui | Non | 10 | -100 | Contexte visible, sans cible directe |
| 5 | 2, séparation | Non | Non | 2 | -100 | Marqueur spécial |
| 6 | 0, remplissage | Non | Non | 0 | -100 | Padding |
Il y a trois cibles, mais un seul marqueur masque. Compter uniquement les occurrences de [MASK] donnerait donc le mauvais dénominateur pour la métrique. Les cibles se repèrent ici avec labels != -100.
Les noms proches peuvent prêter à confusion : eligible indique les positions candidates au masquage ; chosen les positions supervisées ; un masque d'attention indique, lui, quelles positions le réseau peut utiliser comme contexte. La fonction montrée ne retourne pas de masque d'attention : elle retourne corrupted, labels et eligible.
Dernier cas à connaître avant de modifier le programme : la fonction accepte une probabilité nulle et ne force pas la présence d'une cible dans chaque lot. À probability=0, tous les labels valent -100. Un calcul de perte moyenne doit traiter explicitement un lot sans cible, plutôt que le prendre pour un apprentissage parfait. Cet extrait ne montre pas la politique de l'entraînement pour ce cas ; cela ne signifie pas qu'il s'est produit dans r1.
Installer, contrôler et figer l'examen
Préparer l'environnement
Extrayez le ZIP et placez votre terminal dans son répertoire racine. Toutes les commandes suivantes partent de ce dossier. Elles conservent l'ordre du parcours r1 décrit par README.md et lesson/tutorial.json.
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm gpu python -m pytest -q
setup.sh prépare le projet. docker compose config --quiet vérifie que la configuration Compose est exploitable, puis build construit les images des services. L'acquisition récupère les actifs selon les verrous ; le contrôle d'environnement vérifie CUDA dans le conteneur ; pytest exécute les tests du programme.
Attendez une fin sans erreur de ces étapes avant l'entraînement. Une suite de tests réussie contrôle les mécanismes qu'elle couvre ; elle ne dit pas encore si l'adaptation sera utile.
Préparer les documents et conserver l'examen
docker compose run --rm gpu python -m domain_mlm.cli prepare --config configs/minimum.yaml
docker compose run --rm gpu python -m domain_mlm.cli inspect-mask --config configs/minimum.yaml
docker compose run --rm gpu python -m domain_mlm.cli freeze-eval --config configs/minimum.yaml
prepare crée les données du parcours. inspect-mask permet d'observer leur transformation : rapprochez les IDs d'origine, l'entrée corrompue et les labels. Cherchez notamment une position ignorée et une position choisie ; elles ne jouent pas le même rôle.
freeze-eval prépare ensuite les quatre partitions d'évaluation figées. Dans outputs/eval-masks.json, vérifiez la présence de leurs noms et des champs original_ids, input_ids et labels. Les comptes de cibles doivent correspondre au tableau précédent.
Le gel intervient avant les entraînements que nous voulons comparer. Il empêche de remplacer discrètement un examen difficile par un autre plus favorable. Un changement de checkpoint reste alors comparable sur les mêmes entrées, à condition de conserver aussi le reste du protocole.
Adapter, reprendre et mesurer
Nous pouvons maintenant lancer l'adaptation seule, puis celle avec replay. Les commandes suivantes testent également une interruption et une reprise avant de produire les mesures finales.
docker compose run --rm gpu python -m domain_mlm.cli train --config configs/minimum.yaml
docker compose run --rm gpu python -m domain_mlm.cli train --config configs/minimum.yaml --variant replay
docker compose run --rm gpu python -m domain_mlm.cli train --config configs/minimum.yaml --stop-after 150 --run-name interrupted
docker compose run --rm gpu python -m domain_mlm.cli train --config configs/minimum.yaml --resume artifacts/checkpoints/interrupted/state.pt --run-name resumed
docker compose run --rm gpu python -m domain_mlm.cli compare-resume --config configs/minimum.yaml
docker compose run --rm gpu python -m domain_mlm.cli evaluate --config configs/minimum.yaml
docker compose run --rm gpu python -m domain_mlm.cli inspect-cases --config configs/minimum.yaml
Lire les commandes comme une expérience
La première commande train suit la voie d'adaptation de domaine. La deuxième sélectionne --variant replay. Selon la description r1, cette variante change seulement le programme de lots : elle introduit les révisions du contrôle dans l'apprentissage. Ce n'est pas un second type de modèle ni une nouvelle métrique.
Les deux variantes doivent ensuite être relues par rapport à la référence non adaptée, sur domaine et contrôle. Regarder seulement les notices reviendrait à vérifier une nouvelle fonctionnalité en oubliant les tests des fonctionnalités existantes.
Reprendre n'est pas seulement recharger des poids
La commande avec --stop-after 150 --run-name interrupted produit l'arrêt prévu par le parcours. La suivante reprend artifacts/checkpoints/interrupted/state.pt sous le nom resumed. Gardez cet ordre : le fichier doit exister avant sa lecture.
Pourquoi ne pas simplement recharger le modèle et recommencer ? Parce qu'une trajectoire d'entraînement dépend aussi de l'état de l'optimiseur et des tirages aléatoires. Le RNG, ou générateur de nombres pseudo-aléatoires, doit reprendre à l'endroit atteint, pas nécessairement au début de sa suite. La documentation de torch.Generator distingue justement graine initiale et état sauvegardé.
Les étapes interrupted, resumed et compare-resume servent à contrôler cette reprise complète dans r1. Elles ne doivent pas être interprétées comme un entraînement supplémentaire destiné à améliorer le score. Consultez le résultat de compare-resume pour vérifier cette propriété lors de votre exécution.
Enfin, evaluate produit les métriques, puis inspect-cases montre des exemples. Cet ordre est utile : les cas expliquent une mesure globale, ils ne la remplacent pas. Pour une notice donnée, comparez le token attendu, les prédictions et leurs probabilités ; ne sélectionnez pas seulement le cas le plus convaincant.
Métriques avant les mesures
NLL : combien de probabilité reçoit la bonne réponse ?
NLL signifie negative log-likelihood, ou log-vraisemblance négative. Pour une position évaluée, si le modèle donne la probabilité p au token d'origine, sa contribution vaut :
NLL de la position = -ln(p)
ln est le logarithme naturel. Il n'est pas nécessaire de mémoriser ses valeurs : retenez que donner davantage de probabilité au token attendu réduit la pénalité. Une probabilité très faible coûte beaucoup plus qu'une hésitation modérée. Le logarithme naturel exprime cette perte en nats, pas en pourcentage.
Le tableau suivant est un exemple pédagogique à trois candidats, indépendant de BERT et des mesures r1. « Autre » représente ici un seul troisième candidat ; chaque ligne somme à 1.
| Situation fictive | Probabilité du token attendu | Principal concurrent | Autre | Top-1 correct ? | NLL approximative |
|---|---|---|---|---|---|
| A | 0,20 | 0,75 | 0,05 | Non | 1,6094 |
| B | 0,40 | 0,50 | 0,10 | Non | 0,9163 |
| C | 0,60 | 0,35 | 0,05 | Oui | 0,5108 |
| D | 0,90 | 0,07 | 0,03 | Oui | 0,1054 |
Entre A et B, le meilleur choix reste faux, mais la probabilité du token attendu augmente : la NLL s'améliore. Entre C et D, le meilleur choix reste juste, et la NLL distingue encore les deux distributions. L'exactitude top-1 ne raconte donc pas tout ce que racontent les probabilités.
Sur un corpus, nous additionnons les contributions puis divisons par le nombre de positions supervisées. Les autres positions, notamment celles dont le label vaut -100, ne doivent pas diluer cette moyenne.
Prenons un autre calcul fictif : un bloc apporte une cible avec NLL 2, et un autre trois cibles avec NLL moyenne 0,5. La moyenne par token vaut (2 + 3 × 0,5) / 4 = 0,875. La moyenne non pondérée des deux blocs donnerait (2 + 0,5) / 2 = 1,25, une autre quantité. L'unité annoncée ici est bien le token évalué, pas le document ou le lot.
Exactitude top-1 : le premier choix est-il le bon ?
Pour chaque position supervisée, nous retenons le token de plus forte probabilité et comparons son ID à l'ID de référence.
exactitude top-1 = nombre de tokens correctement prédits / nombre de tokens évalués
Trois bonnes prédictions sur quatre donnent 3 / 4 = 0,75, soit 75 %. Cela ne veut pas dire que trois documents sur quatre sont entièrement compris, ni que trois réponses métier sur quatre seraient correctes.
Le corrigé reste le token d'origine. Un autre token plausible ne reçoit pas de crédit parce qu'une personne pourrait trouver la phrase acceptable. De même, prédire correctement un morceau d'un mot ne garantit pas que tout le mot ou toute la phrase soit correct. Ces conventions rendent la mesure précise, mais en limitent l'interprétation.
L'indicateur d'oubli : une différence signée
Le champ control_test_forgetting_nll mesure :
NLL du variant sur control-test - NLL de la référence sur control-test
Une valeur positive signifie que la NLL a augmenté : le variant est moins bon sur cet exercice de contrôle. Une valeur négative signifie une amélioration. Zéro signifie que les deux NLL moyennes sont égales ; cela ne prouve pas que chaque prédiction est identique.
Exemple fictif : si la référence vaut 2,0 et le variant 2,6, l'indicateur vaut +0,6. Avec un variant à 1,7, il vaut -0,3. Ces différences ne sont ni des pourcentages ni des nombres de connaissances perdues.
Une hausse de NLL peut être importante alors que le top-1 varie peu : le modèle peut conserver beaucoup de premiers choix et réduire fortement la probabilité des cibles sur quelques positions. Les deux métriques sont complémentaires.
Résultats réels et ce que nous avons appris
Les nombres suivants sont ceux de la reproduction r1, sur le corpus synthétique et les masques figés décrits plus haut. Ils ne sont pas les exemples de calcul de la section précédente.
| État du modèle | Top-1 sur domain-test |
Top-1 sur control-test |
control_test_forgetting_nll |
|---|---|---|---|
| Référence non adaptée | 0,3850687622789784 | 0,46228710462287104 | 0, par définition de la différence |
| Adaptation de domaine seule | 0,9747871643745907 | 0,45093268450932683 | +0,6229252393711704 |
| Adaptation avec replay | 0,9754420432220039 | 0,9772911597729116 | -2,7341342250796132 |
Le tableau donne les écarts de NLL, pas leurs valeurs absolues. Sans la NLL de la référence, ces différences ne permettent pas de reconstituer les trois pertes. Conservez cette distinction en relisant les sorties produites par evaluate.
L'adaptation seule progresse sur les notices, mais régresse sur le contrôle
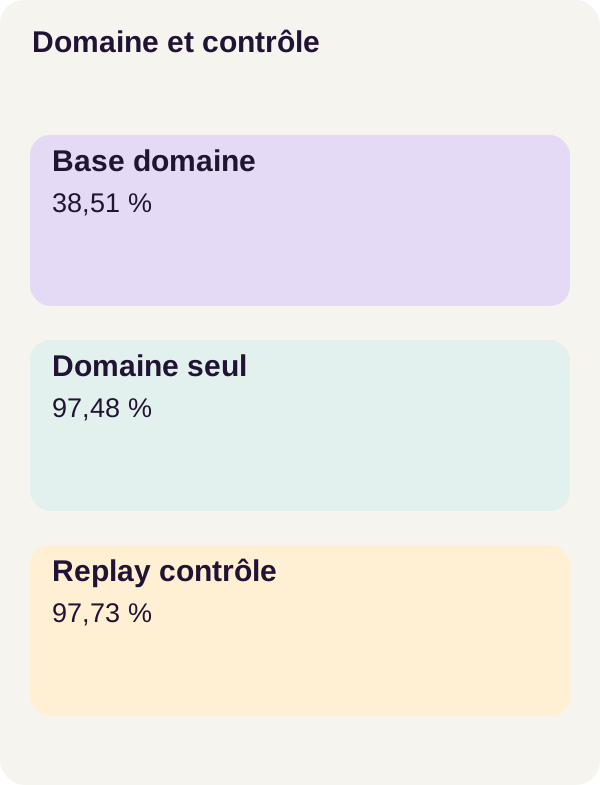
En pourcentage, le top-1 domaine passe d'environ 38,51 % à 97,48 %. Sur le contrôle, il passe d'environ 46,23 % à 45,09 %, soit une baisse d'environ 1,14 point de pourcentage. L'indicateur NLL de +0,6229252393711704 décrit lui aussi une dégradation du contrôle, selon une autre échelle.
Nous pouvons rendre ces proportions concrètes. En multipliant les taux publiés par les effectifs de cibles, nous retrouvons 1 176 puis 2 977 tokens corrects sur 3 054 pour le domaine, et 570 puis 556 sur 1 233 pour le contrôle. Ce sont des effectifs calculés à partir des mesures, pas de nouvelles inférences.
Le résultat montre donc bien le compromis recherché : une amélioration sur le nouveau domaine ne garantit pas la conservation des performances ailleurs.
Le replay améliore les deux scores dans cette expérience
Avec replay, le domaine atteint environ 97,54 %, soit 2 979 tokens corrects sur 3 054 ; le contrôle atteint environ 97,73 %, soit 1 205 sur 1 233. L'indicateur NLL négatif montre également une amélioration du contrôle par rapport à la référence.
Sur le domaine, l'écart entre adaptation seule et replay correspond à deux tokens corrects supplémentaires, soit environ 0,0655 point de pourcentage. Cela remet en perspective les nombreuses décimales du tableau : elles ne sont pas une preuve de supériorité générale ou de significativité statistique.
Sur le contrôle, le replay fait ici davantage que maintenir le niveau initial : il l'améliore fortement. Le constat appartient à ce corpus synthétique. Nous ne pouvons pas en déduire que le modèle a préservé toutes ses capacités générales, ni qu'il saura répondre correctement à une question d'utilisateur.
Ce que le gel des masques ne prouve pas
Des exemples identiques rendent la comparaison plus lisible. Ils ne démontrent pas, à eux seuls, l'absence de chevauchement entre données d'entraînement et d'évaluation, ni la diversité des formulations.
La description r1 indique un replay du corpus de contrôle, mais les deux extraits montrés ne détaillent ni les IDs réinjectés ni la fréquence du replay. Pour auditer cette frontière, il faut lire la configuration et le programme de lots du ZIP. Dans une adaptation à vos données, réservez des partitions de contrôle distinctes pour le replay et pour l'évaluation : entraîner sur le contrôle test puis le noter serait un autre protocole.
Ce point n'est pas un constat de fuite dans r1. C'est une distinction entre ce que vérifie le code de masquage visible ici et ce qu'il faut contrôler ailleurs dans le projet.
La leçon principale n'est donc pas « le replay résout l'oubli ». Elle est plus utile : mesurer ensemble l'apprentissage du domaine et les régressions sur un contrôle, puis conserver les preuves qui permettent de comprendre leurs différences.
Exercice : prédire, puis exécuter
Imaginez deux checkpoints évalués avec des masques tirés indépendamment. Le premier doit retrouver des mots courants, le second des références techniques rares. Un écart de score suffit-il pour attribuer une amélioration ou une régression au modèle ?
Avant la commande, notez votre réponse à cette question, puis à celle-ci : le score pourrait-il changer même si nous utilisions deux fois exactement le même checkpoint ?
Un petit contre-exemple construit à la main aide à formuler l'hypothèse. Supposons qu'un modèle fixe retrouve correctement les positions A et B, mais pas C et D. Un examen portant sur A et B donne 100 %. Un autre portant sur C et D donne 0 %. Les poids n'ont pas changé : seules les questions ont changé. Ce n'est pas une sortie de BERT, mais une démonstration du piège de comparaison.
Lancez maintenant l'exercice fourni :
docker compose run --rm gpu python -m domain_mlm.cli exercise --config configs/exercise.yaml
Comparez sa sortie au jeu de masques figés. L'explication attendue n'est pas que tout changement de masque entraîne nécessairement un changement de score : il peut aussi ne rien changer. Le problème est qu'il introduit une cause supplémentaire, que le score seul ne permet pas de séparer de l'effet du checkpoint.
À l'inverse, un examen figé ne doit pas devenir un ensemble de réponses sur lequel nous ajustons sans cesse nos paramètres. La validation sert aux choix de développement ; le test reste réservé au bilan final. Pour étudier la variabilité du masquage dans une expérience séparée, une possibilité serait de préparer plusieurs examens à l'avance et de faire passer chacun d'eux à tous les checkpoints. Cette extension n'est pas exécutée par le parcours présenté.
Terminez par les figures, le contrôle des checkpoints, la prévisualisation du nettoyage et l'arrêt du projet :
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
--dry-run affiche ce que le nettoyage viserait, mais ne supprime aucun résultat. L'arrêt Compose ne remplace pas la conservation des JSON et checkpoints nécessaires pour relire votre expérience.
Adaptation, production, dépannage et nettoyage
Remplacer le corpus synthétique sans perdre la comparaison
Commencez par définir les capacités que le modèle doit acquérir et celles qu'il doit conserver. Un corpus de contrôle utile à votre application doit représenter ces dernières ; ce n'est pas automatiquement un échantillon de tout ce que le préentraînement initial avait appris.
Versionnez les documents, le tokenizer, les partitions et les masques. Dans une nouvelle expérience, isolez aussi les documents proches ou les versions d'une même notice pour éviter qu'un test ne se résume à retrouver une formulation presque vue à l'entraînement. Cette recommandation complète le protocole ; aucun audit de proximité documentaire n'est détaillé par les deux extraits présentés.
Choisissez vos réglages sur la validation, en gardant une trace de l'intervalle et de la provenance du replay. Fixez des seuils d'acceptation sur domaine et contrôle avant la livraison. Ne réduisez pas la comparaison à un seul exemple réussi ou à la seule NLL domaine.
Pour des textes français ou multilingues, ne supposez pas que la variante anglaise verrouillée répond au même besoin. Changer le tokenizer ou le modèle crée une nouvelle expérience : le nombre et la granularité des tokens peuvent changer, donc une NLL par token n'est plus directement comparable à celle de r1.
Passer de prédictions de tokens à une application
Le projet adapte un modèle de langage masqué. Il ne valide pas un système de questions-réponses, un extracteur de consignes ou une décision de maintenance. Ces usages demandent leurs propres données de référence, critères d'erreur et évaluations par les experts du domaine.
Sur des documents métier, encadrez l'accès, les informations sensibles et la conservation des artefacts. Une notice correctement complétée dans un exercice ne devient pas une procédure approuvée. Le cas Velon et ses 62 degrés restent des données fictives, pas une instruction opérationnelle.
Diagnostiquer sans modifier silencieusement l'expérience
CUDA échoue. Relancez check_environment.py, puis vérifiez l'accès du conteneur au GPU avec le guide NVIDIA Container Toolkit. Ne changez pas le modèle pour résoudre un problème d'environnement.
L'acquisition échoue. Restaurez le réseau du service acquire, puis rejouez sa commande. Gardez les verrous du modèle et des dépendances ; une autre révision ne constituerait pas la même reproduction.
Evaluation masks changed apparaît. Comparez les données préparées, leur ordre, la configuration et le tokenizer avec ceux du gel initial. Ne supprimez pas l'ancien fichier pour faire passer le contrôle : vous perdriez votre base de comparaison. Une modification volontaire demande une expérience distincte et un nouveau gel, pas un remplacement invisible.
Le checkpoint de reprise manque. Vérifiez que la commande interrupted a terminé et produit le fichier attendu avant de lancer resumed. L'existence d'un fichier de poids quelconque ne remplace pas l'état complet demandé par cette commande.
Enfin, docker compose down --remove-orphans arrête les services du projet sans supprimer les sorties décrites ici. clean.py --dry-run annonce seulement ses cibles. Conservez vos résultats avant d'entreprendre un nettoyage différent.
Sources officielles
Les mesures, les chemins, les commandes et les deux extraits de code ci-dessus appartiennent au parcours r1 téléchargeable. Les références suivantes servent à approfondir les mécanismes ; elles ne sont pas la source de ses scores et ne remplacent pas ses versions verrouillées.
- Hugging Face : tâches de masked language modeling et BERT base uncased : objectif MLM et modèle utilisé.
- Devlin et al. : BERT et Gururangan et al. : Don't Stop Pretraining : contexte de la représentation bidirectionnelle et de l'adaptation par préentraînement.
- PyTorch : cross entropy, référence versionnée de CrossEntropyLoss, générateurs aléatoires et reproductibilité : cibles ignorées, état aléatoire et limites des garanties.
- Python : instruction assert, Docker Compose : prise en charge GPU et NVIDIA Container Toolkit : contrôles d'exécution et environnement.