





Imagine el portal documental de un fabricante. Ya dispone del back office, los manuales y los derechos de acceso. Ahora le gustaría aprovechar estos textos con un modelo de lenguaje, pero las referencias de máquinas y el vocabulario técnico no siempre se parecen a lo que encontró durante su aprendizaje inicial.
Una posibilidad consiste en hacer que estudie los manuales. No pidiéndole que los lea en un prompt, sino continuando su entrenamiento: ocultamos ciertas partes del texto y después le pedimos que las encuentre.
Se parece a un ejercicio de rellenar huecos. La dificultad interesante llega después: ¿el modelo progresa con los manuales sin empeorar en otros textos? ¿Y cómo saberlo si los huecos cambian en cada evaluación?
En este tutorial adaptaremos BERT a un dominio, compararemos una variante con repasos periódicos de un corpus de control y mediremos ambos efectos con un examen idéntico para cada modelo. Los manuales son sintéticos: estudiamos un mecanismo de aprendizaje, no un asistente de mantenimiento listo para desplegarse.
Descargar el proyecto completo del tutorial
Lo que vamos a construir
El proyecto compara tres estados de un mismo modelo. La referencia, o baseline, corresponde al modelo antes de nuestra adaptación. El segundo camino continúa su aprendizaje con los documentos del dominio. El tercero añade replay: bloques del corpus de control vuelven periódicamente a los lotes de entrenamiento.
Un checkpoint es un estado guardado del modelo; para reanudar un entrenamiento también hacen falta los demás estados necesarios para el cálculo. Volveremos a esta distinción al hablar de la reanudación.
Antes de comparar estos checkpoints, el programa prepara los mismos textos de evaluación y las mismas posiciones que predecir. Después mide dos cosas, por separado en el dominio y en el control: la probabilidad asignada a los tokens esperados, resumida por la NLL, y la frecuencia con la que la mejor elección del modelo es correcta, llamada exactitud top-1.
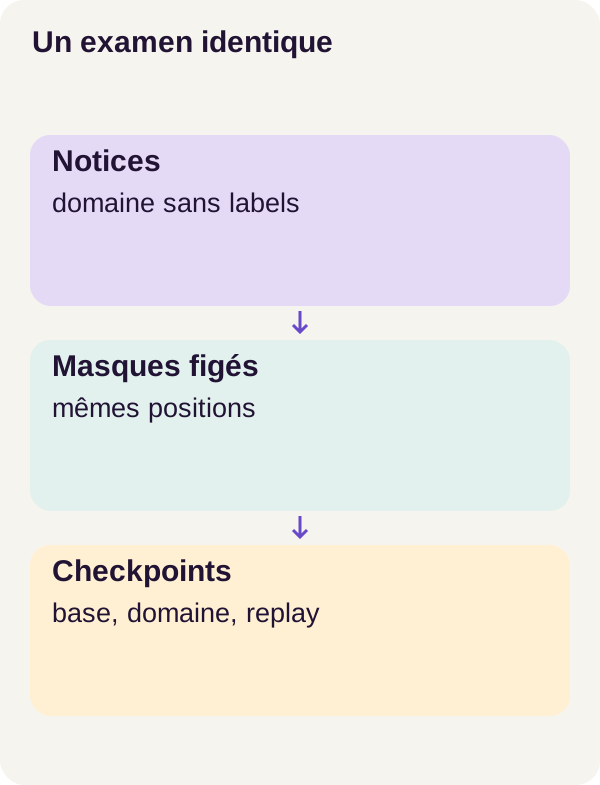
Al final, sabrá seguir el recorrido texto → tokens → entrada parcialmente alterada → predicciones → métricas. También sabrá distinguir una mejora en este ejercicio de la capacidad de responder correctamente a una pregunta de negocio. El programa no construye ni el portal mencionado en la introducción ni un sistema de decisión industrial.
Conceptos explicados
Un token no siempre es una palabra
El modelo no recibe directamente una cadena de Python. Un tokenizer divide el texto en unidades de vocabulario, los tokens, y después les asigna identificadores numéricos. Una unidad puede representar una palabra, un fragmento de palabra o un signo. En este proyecto trabajamos con IDs de subpalabras.
Piense en una conversión de representación: su aplicación maneja texto; el modelo maneja tablas de enteros. Un ID designa una entrada del vocabulario. Su valor numérico no indica por sí solo el significado del token.
La variante utilizada es google-bert/bert-base-uncased. Su ficha oficial precisa que fue preentrenada en inglés y que no distingue mayúsculas de minúsculas. Las explicaciones francesas de este artículo no cambian ni este modelo ni los datos de referencia.
Aprender con un ejercicio de rellenar huecos
Un masked language model, o MLM, intenta recuperar tokens a partir de su contexto. BERT puede utilizar el texto situado antes y después de la posición que debe predecir. Por tanto, aquí no realiza el mismo ejercicio que un modelo que solo debe escribir la continuación de un texto. Este principio se describe en el artículo de BERT y en la guía de Hugging Face sobre MLM.
Para representar la idea, imaginemos esta frase con un hueco: «La temperatura documentada es de [MASK] grados». El modelo debe proponer lo que falta a partir del contexto. Es una ilustración del mecanismo, no una salida medida ni una tokenización BERT real.
Pero ¿dónde está la respuesta correcta, si los manuales no están etiquetados? En el texto original, antes de modificarlo. El programa conserva el identificador del token esperado y luego altera su posición en la entrada. Así fabrica automáticamente el ejemplo y su solución: se habla de aprendizaje autosupervisado.
«Sin etiquetas manuales» no significa «sin objetivos de aprendizaje». Aquí nadie necesita anotar cada frase con una categoría; los tokens originales desempeñan el papel de labels.
Lo que modifica el entrenamiento
En cada posición, el modelo produce logits: puntuaciones para los tokens posibles. El softmax transforma estas puntuaciones en una distribución de probabilidades. La pérdida, o loss, penaliza al modelo cuando asigna demasiada poca probabilidad al token de referencia.
La retropropagación calcula los gradientes, es decir, la sensibilidad de esta pérdida a los parámetros de la red. El optimizador usa estos gradientes para modificar los pesos, los números aprendidos que determinan el comportamiento del modelo. Un lote, o batch, agrupa varios ejemplos tratados en un cálculo.
No partimos de pesos aleatorios: BERT ya posee un aprendizaje inicial. Continuamos un objetivo de lenguaje sobre un corpus especializado. Es una adaptación de dominio mediante la continuación del preentrenamiento, estudiada entre otros en Don't Stop Pretraining.
Todavía no es un entrenamiento supervisado para responder a preguntas técnicas. Recuperar un token en un manual y elegir un procedimiento correcto ante una solicitud son dos tareas distintas. El tutorial solo mide la primera.
Adaptarse sin apostarlo todo al nuevo dominio
Al entrenar el modelo con los manuales, modificamos pesos que también participaban en sus predicciones sobre otros textos. Por tanto, sus resultados pueden mejorar aquí y deteriorarse en otro lugar.
El olvido catastrófico designa este problema de pérdida de rendimiento a medida que se producen nuevos aprendizajes. En nuestro experimento observamos un indicador más limitado: un posible deterioro en el corpus de control elegido. No medimos el conjunto de conocimientos previos de BERT.
El replay desempeña el papel de repasos intercalados: en lugar de trabajar solo el nuevo tema, el entrenamiento también encuentra ejemplos del control. No restaura pesos antiguos ni consulta un segundo modelo. En r1, la variante modifica el calendario de lotes, no el principio del MLM.
Por último, la comparación debe basarse en el mismo examen. Para un desarrollador web, la analogía es una batería de pruebas de no regresión: cambiar los casos de prueba al mismo tiempo que la implementación impide aislar qué produjo el cambio de puntuación.
Requisitos de Docker y GPU
Debe poder leer funciones de Python, listas, diccionarios y JSON, y utilizar un terminal con Docker. Los conceptos de aprendizaje necesarios se explican en el recorrido.
La reproducción r1 utiliza Linux x86_64, Docker Compose, NVIDIA Container Toolkit y una RTX 3090 de 24 GiB. Prevea 16 GiB de RAM y 16 GiB de disco, sin contar las capas compartidas de Docker. Son las provisiones del proyecto, no mínimos medidos; aquí no se valida ningún recorrido en CPU.
locks/models.lock.json fija google-bert/bert-base-uncased a la revisión 86b5e0934494bd15c9632b12f734a8a67f723594. locks/environment.lock.json describe el entorno. Como un archivo de dependencias bloqueadas en un proyecto web, estos archivos permiten identificar la receta utilizada: no sustituya una versión para hacer desaparecer silenciosamente un error.
El servicio acquire descarga los activos públicos. El servicio gpu realiza los cálculos locales sin red. El script check_environment.py inicializa CUDA, el entorno de cálculo de NVIDIA, desde el contenedor. Que una tarjeta sea visible en el host no basta; Docker también debe poder utilizarla. La guía de GPU de Docker Compose explica esta integración.
Datos y función central
¿Qué vamos a contar realmente?
Un corpus es un conjunto de documentos. Un split es una partición de este conjunto: el entrenamiento sirve para modificar el modelo, la validación para seguir las decisiones de desarrollo y la prueba para la evaluación final. El dominio y el control tienen cada uno una validación y una prueba.
Estos son los recuentos conservados en la evaluación r1. Se trata de posiciones supervisadas, es decir, tokens sobre los que se calcula la puntuación, y no de números de documentos o preguntas.
| Partición | Tokens evaluados | Función |
|---|---|---|
domain-validation |
3 089 | Seguir la adaptación en el dominio |
domain-test |
3 054 | Medir el resultado final en el dominio |
control-validation |
1 318 | Seguir los efectos sobre el control |
control-test |
1 233 | Medir el resultado final en el control |
Los tres checkpoints reciben las mismas posiciones y las mismas entradas alteradas para cada partición. El término «tokens enmascarados» es un atajo: veremos que algunas posiciones evaluadas siguen visibles en la entrada.
Un ejemplo del corpus r1 lleva el identificador domain-006-0. Es un manual ficticio de Velon sobre un acoplamiento de bomba: pide aislar la bomba antes de la inspección y menciona una temperatura de servicio documentada de 62 grados. Esta información pertenece a los datos del ejercicio. Nunca es una instrucción para un equipo real.
Fijar las preguntas y sus soluciones
El siguiente extracto continuo, procedente de src/domain_mlm/eval_masks.py, construye el conjunto de comparación y después comprueba que siga siendo idéntico.
def freeze_evaluation_masks(config):
    tokenizer = AutoTokenizer.from_pretrained("models", local_files_only=True)
    generator = torch.Generator().manual_seed(config["seed"] + 1000)
    sets = {}
    for corpus in ("domain", "control"):
        for split in ("validation", "test"):
            key = corpus + "-" + split
            rows = read_json("outputs/" + key + ".json")
            ids = torch.tensor([r["input_ids"] for r in rows])
            masked, labels, _ = mask_tokens(
                ids, tokenizer, generator, config["mask_probability"]
            )
            sets[key] = [
                {
                    **row,
                    "original_ids": row["input_ids"],
                    "input_ids": masked[i].tolist(),
                    "labels": labels[i].tolist(),
                }
                for i, row in enumerate(rows)
            ]
    target = Path("outputs/eval-masks.json")
    if target.exists():
        assert read_json(target) == sets, "Evaluation masks changed"
    else:
        save_json(target, sets)
Empecemos por lo que esta función no hace: no llama a BERT para predecir tokens ni inicia ningún entrenamiento. Prepara los ejemplos que se enviarán a los modelos más tarde.
AutoTokenizer.from_pretrained("models", local_files_only=True) carga el tokenizer ya adquirido en el directorio local. El nombre models es aquí una ruta, no una petición de descarga automática.
torch.Generator().manual_seed(config["seed"] + 1000) crea un generador pseudoaleatorio dedicado. La semilla, o seed, fija el punto de partida de su secuencia de sorteos. El desplazamiento + 1000 es una elección del proyecto: no significa «mil máscaras».
Los dos bucles recorren sucesivamente domain-validation, domain-test, control-validation y control-test. torch.tensor(...) transforma las listas de IDs en una tabla numérica, o tensor. Esta construcción supone filas de longitud compatible; el extracto no realiza por sí mismo su igualación de longitud.
Después de mask_tokens, cada fila conserva sus metadatos gracias a **row y dispone de tres representaciones complementarias: original_ids para el texto tokenizado antes de la transformación, input_ids para la entrada alterada y labels para los objetivos que recuperar. tolist() hace que los tensores se puedan guardar en JSON.
Por último, se crea outputs/eval-masks.json si no existe. Si existe, el código reconstruye los datos esperados y los compara íntegramente con el contenido guardado. Una diferencia provoca Evaluation masks changed en lugar de sobrescribir silenciosamente el examen anterior. El recorrido r1 también anuncia un bloqueo y recuentos de objetivos por split; su escritura complementaria no aparece en este extracto.
Misma semilla y mismas máscaras: dos garantías distintas
El generador se comparte entre las cuatro particiones y avanza con cada sorteo. Por tanto, modificar el orden de las filas, su longitud o el número de sorteos puede modificar la secuencia obtenida, incluso conservando la misma semilla inicial. La comparación del archivo protege los datos realmente preparados, no solo un valor de configuración.
Esta protección tiene un límite explícito: emplea assert. Python puede desactivar las aserciones en modo optimizado, especialmente con la opción -O. Mantenga el modo de ejecución del recorrido; en una adaptación de producción, un control obligatorio no debería depender de aserciones que se puedan desactivar. Es el comportamiento descrito en la documentación de Python, no una modificación del código anterior.
Fijar las máscaras elimina una fuente de variación, no todas las demás. Todavía hay que conservar el tokenizer, los datos, los parámetros de evaluación y el entorno. PyTorch recuerda que la misma semilla no garantiza una identidad entre todas las plataformas o versiones.
Fabricar una entrada y objetivos MLM
El bloqueo describe el examen. El extracto continuo de src/domain_mlm/collator.py describe ahora el mecanismo que fabrica las entradas y los objetivos, utilizado también para el entrenamiento.
def mask_tokens(input_ids, tokenizer, generator, probability=0.15):
    if not 0 <= probability <= 1:
        raise ValueError("Mask probability out of range")
    eligible = torch.ones_like(input_ids, dtype=torch.bool)
    for value in tokenizer.all_special_ids:
        eligible &= input_ids != value
    chosen = (torch.rand(input_ids.shape, generator=generator) < probability) & eligible
    labels = input_ids.clone()
    labels[~chosen] = -100
    corrupted = input_ids.clone()
    choice = torch.rand(input_ids.shape, generator=generator)
    corrupted[chosen & (choice < 0.8)] = tokenizer.mask_token_id
    admissible = torch.tensor(
        [i for i in range(len(tokenizer)) if i not in tokenizer.all_special_ids]
    )
    random_ids = admissible[
        torch.randint(len(admissible), input_ids.shape, generator=generator)
    ]
    random_positions = chosen & (choice >= 0.8) & (choice < 0.9)
    corrupted[random_positions] = random_ids[random_positions]
    return corrupted, labels, eligible
El primer paso consiste en distinguir lo que puede elegirse de lo que realmente se eligió.
eligible es una tabla de valores booleanos, con la misma forma que los IDs. El bucle elimina los tokens especiales del tokenizer, por ejemplo los marcadores de inicio, separación o relleno. El padding, o relleno, sirve para completar las secuencias cortas y formar tablas de igual anchura; no representa texto que recuperar.
A continuación, chosen aplica un sorteo en cada posición y lo combina con eligible. El parámetro probability vale 0.15 por defecto en esta función. Durante la fijación de la evaluación, quien llama transmite config["mask_probability"]: por tanto, debe consultar la configuración bloqueada para conocer el valor efectivo del recorrido.
labels empieza como una copia de los tokens originales. Las posiciones no elegidas pasan a ser -100. Según el contrato de cross-entropy de PyTorch, este valor indica un objetivo que se debe ignorar. No sustituye el texto en la entrada del modelo. Un token no supervisado puede seguir ayudando a recuperar a su vecino gracias al contexto.
Después el código crea corrupted, una copia independiente de la entrada. Para las posiciones elegidas, un segundo sorteo determina la transformación: por debajo de 0.8, el token se convierte en el marcador de máscara; entre 0.8 y 0.9, se sustituye por un token aleatorio admisible; a partir de 0.9, no cambia.
Por tanto, encontramos la distribución 80 % máscara, 10 % sustitución aleatoria, 10 % sin cambio, entre las posiciones elegidas. Son probabilidades, no cuotas exactas impuestas en cada lote. Si la selección vale 15 %, las proporciones esperadas en las posiciones elegibles son respectivamente 15 % × 80 % = 12 %, 1,5 % y 1,5 %.
Hay un detalle importante: admissible excluye los IDs especiales, pero no el ID original de cada posición. Por tanto, el sorteo aleatorio puede volver a caer en el token original. Observar una entrada sin cambios no basta para determinar qué rama se sorteó.
Seguir una fila sin cargar BERT
Este es un ejemplo pedagógico construido a mano con IDs ficticios. No utiliza el vocabulario real de BERT ni procede de los resultados r1. Elegimos tres posiciones para mostrar las tres ramas; no pretendemos reproducir sus frecuencias con una fila tan pequeña.
| Posición | ID original | ¿Elegible? | ¿Elegida? | ID proporcionado al modelo | Label | Explicación |
|---|---|---|---|---|---|---|
| 0 | 1, inicio | No | No | 1 | -100 | Marcador especial |
| 1 | 7 | Sí | Sí | 3, máscara | 7 | El modelo debe recuperar 7 |
| 2 | 8 | Sí | Sí | 12 | 8 | La sustitución no cambia la solución |
| 3 | 9 | Sí | Sí | 9 | 9 | El token sigue visible, pero se evalúa |
| 4 | 10 | Sí | No | 10 | -100 | Contexto visible, sin objetivo directo |
| 5 | 2, separación | No | No | 2 | -100 | Marcador especial |
| 6 | 0, relleno | No | No | 0 | -100 | Padding |
Hay tres objetivos, pero un solo marcador de máscara. Por tanto, contar solo las apariciones de [MASK] daría el denominador incorrecto para la métrica. Aquí los objetivos se identifican con labels != -100.
Los nombres parecidos pueden inducir a confusión: eligible indica las posiciones candidatas al enmascaramiento; chosen, las posiciones supervisadas; una máscara de atención indica qué posiciones puede usar la red como contexto. La función mostrada no devuelve una máscara de atención: devuelve corrupted, labels y eligible.
Último caso que debe conocer antes de modificar el programa: la función acepta una probabilidad nula y no fuerza la presencia de un objetivo en cada lote. Con probability=0, todos los labels valen -100. Un cálculo de pérdida media debe tratar explícitamente un lote sin objetivo, en vez de tomarlo por un aprendizaje perfecto. Este extracto no muestra la política de entrenamiento para este caso; eso no significa que se produjera en r1.
Instalar, comprobar y fijar el examen
Preparar el entorno
Extraiga el ZIP y sitúe el terminal en su directorio raíz. Todos los comandos siguientes parten de esta carpeta. Conservan el orden del recorrido r1 descrito por README.md y lesson/tutorial.json.
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm gpu python -m pytest -q
setup.sh prepara el proyecto. docker compose config --quiet comprueba que la configuración de Compose se puede utilizar, y después build construye las imágenes de los servicios. La adquisición recupera los activos según los bloqueos; la comprobación del entorno verifica CUDA en el contenedor; pytest ejecuta las pruebas del programa.
Espere a que estos pasos terminen sin errores antes del entrenamiento. Una batería de pruebas correcta comprueba los mecanismos que cubre; todavía no dice si la adaptación resultará útil.
Preparar los documentos y conservar el examen
docker compose run --rm gpu python -m domain_mlm.cli prepare --config configs/minimum.yaml
docker compose run --rm gpu python -m domain_mlm.cli inspect-mask --config configs/minimum.yaml
docker compose run --rm gpu python -m domain_mlm.cli freeze-eval --config configs/minimum.yaml
prepare crea los datos del recorrido. inspect-mask permite observar su transformación: compare los IDs originales, la entrada alterada y los labels. Busque en particular una posición ignorada y una posición elegida; no desempeñan el mismo papel.
Después, freeze-eval prepara las cuatro particiones de evaluación fijadas. En outputs/eval-masks.json, compruebe que están sus nombres y los campos original_ids, input_ids y labels. Los recuentos de objetivos deben coincidir con la tabla anterior.
La fijación ocurre antes de los entrenamientos que queremos comparar. Impide sustituir discretamente un examen difícil por otro más favorable. Así, un cambio de checkpoint sigue siendo comparable con las mismas entradas, siempre que se conserve también el resto del protocolo.
Adaptar, reanudar y medir
Ahora podemos iniciar la adaptación sola y después la que incluye replay. Los siguientes comandos también prueban una interrupción y una reanudación antes de generar las mediciones finales.
docker compose run --rm gpu python -m domain_mlm.cli train --config configs/minimum.yaml
docker compose run --rm gpu python -m domain_mlm.cli train --config configs/minimum.yaml --variant replay
docker compose run --rm gpu python -m domain_mlm.cli train --config configs/minimum.yaml --stop-after 150 --run-name interrupted
docker compose run --rm gpu python -m domain_mlm.cli train --config configs/minimum.yaml --resume artifacts/checkpoints/interrupted/state.pt --run-name resumed
docker compose run --rm gpu python -m domain_mlm.cli compare-resume --config configs/minimum.yaml
docker compose run --rm gpu python -m domain_mlm.cli evaluate --config configs/minimum.yaml
docker compose run --rm gpu python -m domain_mlm.cli inspect-cases --config configs/minimum.yaml
Leer los comandos como un experimento
El primer comando train sigue el camino de adaptación de dominio. El segundo selecciona --variant replay. Según la descripción r1, esta variante solo cambia el calendario de lotes: introduce los repasos del control en el aprendizaje. No es un segundo tipo de modelo ni una nueva métrica.
Las dos variantes deben releerse después frente a la referencia sin adaptar, en dominio y control. Mirar solo los manuales equivaldría a comprobar una funcionalidad nueva olvidando las pruebas de las funcionalidades existentes.
Reanudar no consiste solo en recargar pesos
El comando con --stop-after 150 --run-name interrupted produce la parada prevista por el recorrido. El siguiente reanuda artifacts/checkpoints/interrupted/state.pt con el nombre resumed. Mantenga este orden: el archivo debe existir antes de leerse.
¿Por qué no basta con recargar el modelo y empezar de nuevo? Porque una trayectoria de entrenamiento también depende del estado del optimizador y de los sorteos aleatorios. El RNG, o generador de números pseudoaleatorios, debe reanudarse en el punto alcanzado, no necesariamente al inicio de su secuencia. La documentación de torch.Generator distingue precisamente entre semilla inicial y estado guardado.
Los pasos interrupted, resumed y compare-resume sirven para controlar esta reanudación completa en r1. No deben interpretarse como un entrenamiento adicional destinado a mejorar la puntuación. Consulte el resultado de compare-resume para comprobar esta propiedad durante su ejecución.
Por último, evaluate produce las métricas y después inspect-cases muestra ejemplos. Este orden es útil: los casos explican una medición global, no la sustituyen. Para un manual dado, compare el token esperado, las predicciones y sus probabilidades; no elija solo el caso más convincente.
Métricas antes de las mediciones
NLL: ¿cuánta probabilidad recibe la respuesta correcta?
NLL significa negative log-likelihood, o log-verosimilitud negativa. Para una posición evaluada, si el modelo asigna la probabilidad p al token original, su contribución vale:
NLL de la posición = -ln(p)
ln es el logaritmo natural. No es necesario memorizar sus valores: recuerde que asignar más probabilidad al token esperado reduce la penalización. Una probabilidad muy baja cuesta mucho más que una duda moderada. El logaritmo natural expresa esta pérdida en nats, no en porcentaje.
La siguiente tabla es un ejemplo pedagógico con tres candidatos, independiente de BERT y de las mediciones r1. «Otro» representa aquí un solo tercer candidato; cada fila suma 1.
| Situación ficticia | Probabilidad del token esperado | Principal competidor | Otro | ¿Top-1 correcto? | NLL aproximada |
|---|---|---|---|---|---|
| A | 0,20 | 0,75 | 0,05 | No | 1,6094 |
| B | 0,40 | 0,50 | 0,10 | No | 0,9163 |
| C | 0,60 | 0,35 | 0,05 | Sí | 0,5108 |
| D | 0,90 | 0,07 | 0,03 | Sí | 0,1054 |
Entre A y B, la mejor elección sigue siendo incorrecta, pero aumenta la probabilidad del token esperado: la NLL mejora. Entre C y D, la mejor elección sigue siendo correcta, y la NLL todavía distingue las dos distribuciones. Por tanto, la exactitud top-1 no cuenta todo lo que cuentan las probabilidades.
En un corpus, sumamos las contribuciones y después dividimos por el número de posiciones supervisadas. Las demás posiciones, especialmente aquellas cuyo label vale -100, no deben diluir esta media.
Tomemos otro cálculo ficticio: un bloque aporta un objetivo con NLL 2 y otro tres objetivos con NLL media 0,5. La media por token vale (2 + 3 × 0,5) / 4 = 0,875. La media no ponderada de los dos bloques daría (2 + 0,5) / 2 = 1,25, otra cantidad. La unidad anunciada aquí es efectivamente el token evaluado, no el documento ni el lote.
Exactitud top-1: ¿es correcta la primera elección?
Para cada posición supervisada, retenemos el token con mayor probabilidad y comparamos su ID con el ID de referencia.
exactitud top-1 = número de tokens predichos correctamente / número de tokens evaluados
Tres predicciones correctas de cuatro dan 3 / 4 = 0,75, es decir, 75 %. Esto no significa que tres documentos de cada cuatro se comprendan por completo, ni que tres respuestas de negocio de cada cuatro serían correctas.
La solución sigue siendo el token original. Otro token plausible no recibe crédito porque una persona podría considerar aceptable la frase. Del mismo modo, predecir correctamente un fragmento de palabra no garantiza que toda la palabra o toda la frase sea correcta. Estas convenciones hacen precisa la medición, pero limitan su interpretación.
El indicador de olvido: una diferencia con signo
El campo control_test_forgetting_nll mide:
NLL de la variante en control-test - NLL de la referencia en control-test
Un valor positivo significa que la NLL aumentó: la variante es peor en este ejercicio de control. Un valor negativo significa una mejora. Cero significa que las dos NLL medias son iguales; no demuestra que cada predicción sea idéntica.
Ejemplo ficticio: si la referencia vale 2,0 y la variante 2,6, el indicador vale +0,6. Con una variante en 1,7, vale -0,3. Estas diferencias no son ni porcentajes ni números de conocimientos perdidos.
Un aumento de NLL puede ser importante aunque el top-1 varíe poco: el modelo puede conservar muchas primeras elecciones y reducir mucho la probabilidad de los objetivos en algunas posiciones. Las dos métricas son complementarias.
Resultados reales y lo que hemos aprendido
Los números siguientes son los de la reproducción r1, sobre el corpus sintético y las máscaras fijadas descritas antes. No son los ejemplos de cálculo de la sección anterior.
| Estado del modelo | Top-1 en domain-test |
Top-1 en control-test |
control_test_forgetting_nll |
|---|---|---|---|
| Referencia sin adaptar | 0,3850687622789784 | 0,46228710462287104 | 0, por definición de la diferencia |
| Adaptación de dominio sola | 0,9747871643745907 | 0,45093268450932683 | +0,6229252393711704 |
| Adaptación con replay | 0,9754420432220039 | 0,9772911597729116 | -2,7341342250796132 |
La tabla muestra las diferencias de NLL, no sus valores absolutos. Sin la NLL de referencia, estas diferencias no permiten reconstruir las tres pérdidas. Mantenga esta distinción al releer las salidas producidas por evaluate.
La adaptación sola progresa con los manuales, pero empeora en el control
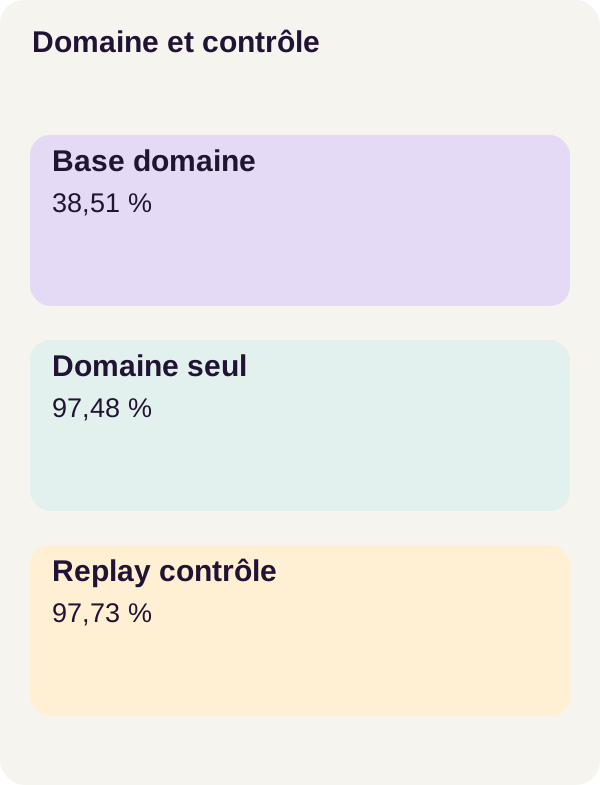
En porcentaje, el top-1 de dominio pasa de aproximadamente 38,51 % a 97,48 %. En el control, pasa de aproximadamente 46,23 % a 45,09 %, una caída de aproximadamente 1,14 puntos porcentuales. El indicador NLL de +0,6229252393711704 también describe un deterioro del control, en otra escala.
Podemos hacer concretas estas proporciones. Al multiplicar las tasas publicadas por los recuentos de objetivos, obtenemos 1 176 y después 2 977 tokens correctos de 3 054 para el dominio, y 570 y después 556 de 1 233 para el control. Son recuentos calculados a partir de las mediciones, no nuevas inferencias.
Por tanto, el resultado muestra el compromiso buscado: una mejora en el nuevo dominio no garantiza conservar el rendimiento en otros lugares.
El replay mejora ambas puntuaciones en este experimento
Con replay, el dominio alcanza aproximadamente 97,54 %, es decir, 2 979 tokens correctos de 3 054; el control alcanza aproximadamente 97,73 %, es decir, 1 205 de 1 233. El indicador NLL negativo también muestra una mejora del control respecto a la referencia.
En el dominio, la diferencia entre la adaptación sola y el replay corresponde a dos tokens correctos adicionales, es decir, aproximadamente 0,0655 puntos porcentuales. Esto pone en perspectiva los muchos decimales de la tabla: no prueban una superioridad general ni una significación estadística.
En el control, el replay hace aquí más que mantener el nivel inicial: lo mejora mucho. La observación pertenece a este corpus sintético. No podemos deducir que el modelo haya conservado todas sus capacidades generales ni que sabrá responder correctamente a una pregunta de usuario.
Lo que no demuestra la fijación de las máscaras
Ejemplos idénticos hacen más legible la comparación. Por sí solos, no demuestran la ausencia de solapamiento entre los datos de entrenamiento y de evaluación, ni la diversidad de las formulaciones.
La descripción r1 indica un replay del corpus de control, pero los dos extractos mostrados no detallan ni los IDs reinyectados ni la frecuencia del replay. Para auditar esta frontera, hay que leer la configuración y el programa de lotes del ZIP. En una adaptación a sus datos, reserve particiones de control distintas para el replay y para la evaluación: entrenar con el control de prueba y luego calificarlo sería otro protocolo.
Este punto no es una constatación de fuga en r1. Es una distinción entre lo que comprueba el código de enmascaramiento visible aquí y lo que hay que controlar en otra parte del proyecto.
Por tanto, la lección principal no es «el replay resuelve el olvido». Es más útil: medir conjuntamente el aprendizaje del dominio y las regresiones en un control, y conservar las pruebas que permitan comprender sus diferencias.
Ejercicio: predecir y después ejecutar
Imagine dos checkpoints evaluados con máscaras obtenidas de forma independiente. El primero debe recuperar palabras comunes; el segundo, referencias técnicas poco frecuentes. ¿Basta una diferencia de puntuación para atribuir una mejora o una regresión al modelo?
Antes del comando, anote su respuesta a esta pregunta y después a esta otra: ¿podría cambiar la puntuación incluso si utilizáramos exactamente el mismo checkpoint dos veces?
Un pequeño contraejemplo construido a mano ayuda a formular la hipótesis. Supongamos que un modelo fijo recupera correctamente las posiciones A y B, pero no C y D. Un examen sobre A y B da 100 %. Otro sobre C y D da 0 %. Los pesos no cambiaron: solo cambiaron las preguntas. No es una salida de BERT, sino una demostración de la trampa de la comparación.
Ejecute ahora el ejercicio proporcionado:
docker compose run --rm gpu python -m domain_mlm.cli exercise --config configs/exercise.yaml
Compare su salida con el conjunto de máscaras fijadas. La explicación esperada no es que todo cambio de máscara implique necesariamente un cambio de puntuación: también puede no cambiar nada. El problema es que introduce una causa adicional que la puntuación por sí sola no permite separar del efecto del checkpoint.
A la inversa, un examen fijado no debe convertirse en un conjunto de respuestas sobre el que ajustamos sin parar nuestros parámetros. La validación sirve para las decisiones de desarrollo; la prueba sigue reservada al balance final. Para estudiar la variabilidad del enmascaramiento en un experimento separado, una posibilidad sería preparar varios exámenes de antemano y pasar cada uno de ellos a todos los checkpoints. Esta extensión no la ejecuta el recorrido presentado.
Termine con las figuras, la comprobación de los checkpoints, la previsualización de la limpieza y la detención del proyecto:
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
--dry-run muestra lo que apuntaría la limpieza, pero no elimina ningún resultado. Detener Compose no sustituye la conservación de los JSON y checkpoints necesarios para revisar su experimento.
Adaptación, producción, resolución de problemas y limpieza
Sustituir el corpus sintético sin perder la comparación
Empiece por definir las capacidades que el modelo debe adquirir y aquellas que debe conservar. Un corpus de control útil para su aplicación debe representar estas últimas; no es automáticamente una muestra de todo lo que el preentrenamiento inicial había aprendido.
Versione los documentos, el tokenizer, las particiones y las máscaras. En un nuevo experimento, aísle también los documentos cercanos o las versiones de un mismo manual para evitar que una prueba se reduzca a recuperar una formulación casi vista durante el entrenamiento. Esta recomendación completa el protocolo; ninguno de los dos extractos presentados detalla una auditoría de cercanía documental.
Elija sus ajustes en la validación, conservando un registro del intervalo y del origen del replay. Fije umbrales de aceptación en dominio y control antes de la entrega. No reduzca la comparación a un único ejemplo correcto ni solo a la NLL del dominio.
Para textos franceses o multilingües, no suponga que la variante inglesa bloqueada responde a la misma necesidad. Cambiar el tokenizer o el modelo crea un nuevo experimento: el número y la granularidad de los tokens pueden cambiar, por lo que una NLL por token ya no es directamente comparable con la de r1.
Pasar de predicciones de tokens a una aplicación
El proyecto adapta un modelo de lenguaje enmascarado. No valida un sistema de preguntas y respuestas, un extractor de instrucciones ni una decisión de mantenimiento. Estos usos requieren sus propios datos de referencia, criterios de error y evaluaciones por expertos del dominio.
En documentos de negocio, encuadre el acceso, la información sensible y la conservación de los artefactos. Un manual completado correctamente en un ejercicio no se convierte en un procedimiento aprobado. El caso Velon y sus 62 grados siguen siendo datos ficticios, no una instrucción operativa.
Diagnosticar sin modificar silenciosamente el experimento
CUDA falla. Vuelva a ejecutar check_environment.py, después compruebe el acceso del contenedor a la GPU con la guía de NVIDIA Container Toolkit. No cambie el modelo para resolver un problema de entorno.
La adquisición falla. Restaure la red del servicio acquire y después repita su comando. Mantenga los bloqueos del modelo y de las dependencias; otra revisión no constituiría la misma reproducción.
Aparece Evaluation masks changed. Compare los datos preparados, su orden, la configuración y el tokenizer con los de la fijación inicial. No elimine el archivo antiguo para superar el control: perdería su base de comparación. Una modificación voluntaria requiere un experimento distinto y una nueva fijación, no una sustitución invisible.
Falta el checkpoint de reanudación. Compruebe que el comando interrupted haya terminado y producido el archivo esperado antes de iniciar resumed. La existencia de cualquier archivo de pesos no sustituye el estado completo que pide este comando.
Por último, docker compose down --remove-orphans detiene los servicios del proyecto sin eliminar las salidas descritas aquí. clean.py --dry-run solo anuncia sus objetivos. Conserve sus resultados antes de emprender una limpieza diferente.
Fuentes oficiales
Las mediciones, las rutas, los comandos y los dos extractos de código anteriores pertenecen al recorrido r1 descargable. Las siguientes referencias sirven para profundizar en los mecanismos; no son la fuente de sus puntuaciones y no sustituyen sus versiones bloqueadas.
- Hugging Face: tareas de masked language modeling y BERT base uncased: objetivo MLM y modelo utilizado.
- Devlin et al.: BERT y Gururangan et al.: Don't Stop Pretraining: contexto de la representación bidireccional y de la adaptación mediante preentrenamiento.
- PyTorch: cross entropy, referencia versionada de CrossEntropyLoss, generadores aleatorios y reproducibilidad: objetivos ignorados, estado aleatorio y límites de las garantías.
- Python: instrucción assert, Docker Compose: compatibilidad con GPU y NVIDIA Container Toolkit: controles de ejecución y entorno.