





Immaginate il portale documentale di un produttore. Avete già il back office, i manuali e i diritti di accesso. Ora vorreste sfruttare questi testi con un modello linguistico, ma i riferimenti delle macchine e il vocabolario tecnico non assomigliano sempre a ciò che ha incontrato durante il suo addestramento iniziale.
Una possibilità consiste nel fargli studiare i manuali. Non chiedendogli di leggerli in un prompt, ma proseguendo il suo addestramento: nascondiamo alcune parti del testo e poi gli chiediamo di ritrovarle.
Somiglia a un esercizio a riempimento. La difficoltà interessante arriva dopo: il modello migliora sui manuali senza peggiorare su altri testi? E come saperlo se le lacune cambiano a ogni valutazione?
In questo tutorial adatteremo BERT a un dominio, confronteremo una variante con ripassi regolari di un corpus di controllo e misureremo entrambi gli effetti con lo stesso esame per ciascun modello. I manuali sono sintetici: studiamo un meccanismo di apprendimento, non un assistente di manutenzione pronto per il deployment.
Scaricare il progetto completo del tutorial
Cosa costruiamo
Il progetto confronta tre stati dello stesso modello. Il riferimento, o baseline, corrisponde al modello prima del nostro adattamento. Il secondo percorso prosegue l'apprendimento sui documenti del dominio. Il terzo vi aggiunge il replay: blocchi del corpus di controllo ritornano periodicamente nei batch di addestramento.
Un checkpoint è uno stato salvato del modello; per riprendere un addestramento servono anche gli altri stati necessari al calcolo. Torneremo su questa distinzione al momento della ripresa.
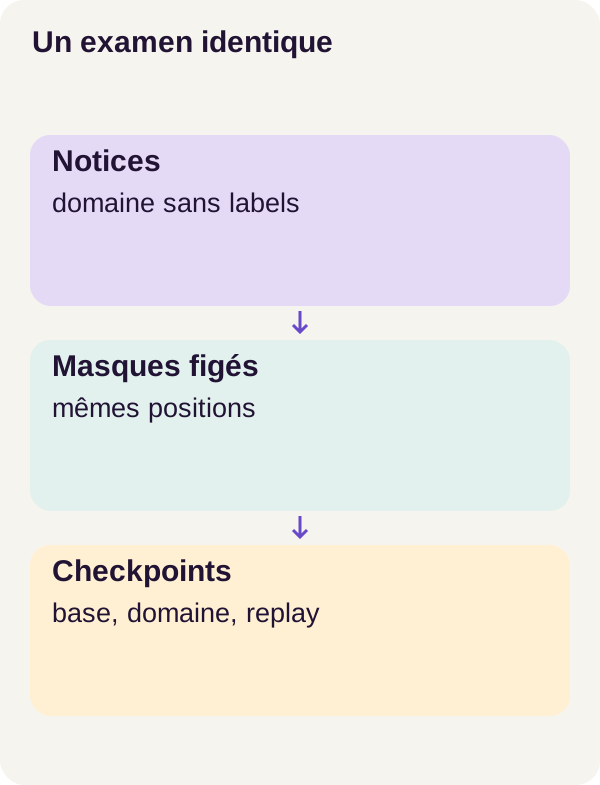
Prima di confrontare questi checkpoint, il programma prepara gli stessi testi di valutazione e le stesse posizioni da predire. Misura poi due aspetti, separatamente sul dominio e sul controllo: la probabilità attribuita ai token attesi, riassunta dalla NLL, e la frequenza con cui la scelta migliore del modello è corretta, detta accuratezza top-1.
Alla fine saprete seguire il percorso testo → token → input parzialmente corrotto → previsioni → metriche. Saprete inoltre distinguere un miglioramento in questo esercizio dalla capacità di rispondere correttamente a una domanda aziendale. Il programma non costruisce né il portale evocato nell'introduzione né un sistema decisionale industriale.
Concetti spiegati
Un token non è necessariamente una parola
Il modello non riceve direttamente una stringa Python. Un tokenizer suddivide il testo in unità di vocabolario, i token, e assegna loro identificatori numerici. Un'unità può rappresentare una parola, un frammento di parola o un segno. In questo progetto lavoriamo su ID di sottoparole.
Pensate a una conversione di rappresentazione: la vostra applicazione gestisce testo; il modello gestisce matrici di interi. Un ID designa una voce di vocabolario. Il suo valore numerico non indica da solo il significato del token.
La variante usata è google-bert/bert-base-uncased. La sua scheda ufficiale precisa che è stata preaddestrata in inglese e che non distingue maiuscole e minuscole. Le spiegazioni francesi di questo articolo non modificano né questo modello né i dati di riferimento.
Imparare con un esercizio a riempimento
Un masked language model, o MLM, cerca di ritrovare i token dal loro contesto. BERT può usare il testo che si trova prima e dopo la posizione da predire. Non svolge dunque qui lo stesso esercizio di un modello che deve soltanto scrivere la continuazione di un testo. Il principio è descritto nell'articolo su BERT e nella guida Hugging Face sull'MLM.
Per rappresentare l'idea, immaginiamo questa frase con una lacuna: « La temperatura documentata è di [MASK] gradi. » Il modello deve proporre ciò che manca in base al contesto. È un'illustrazione del meccanismo, non un output misurato né una tokenizzazione BERT reale.
Ma dove si trova la risposta corretta, dato che i manuali non sono etichettati? Nel testo originale, prima di modificarlo. Il programma conserva l'identificatore del token atteso e ne altera la posizione nell'input. Crea così automaticamente l'esempio e la sua soluzione: si parla di apprendimento auto-supervisionato.
« Senza etichette manuali » non significa quindi « senza obiettivi di apprendimento ». Qui nessuno deve annotare ogni frase con una categoria; i token originali svolgono il ruolo delle label.
Cosa modifica l'addestramento
In ogni posizione il modello produce dei logit: punteggi per i token possibili. Il softmax trasforma questi punteggi in una distribuzione di probabilità. La perdita, o loss, penalizza il modello quando attribuisce una probabilità troppo bassa al token di riferimento.
La retropropagazione calcola i gradienti, cioè la sensibilità di questa perdita ai parametri della rete. L'ottimizzatore usa questi gradienti per modificare i pesi, i numeri appresi che determinano il comportamento del modello. Un batch, o lotto, raggruppa più esempi trattati in un calcolo.
Non ripartiamo da pesi casuali: BERT possiede già un apprendimento iniziale. Proseguiamo un obiettivo linguistico su un corpus specializzato. È un adattamento di dominio tramite prosecuzione del preaddestramento, studiato tra l'altro in Don't Stop Pretraining.
Non si tratta ancora di un addestramento supervisionato per rispondere a domande tecniche. Ritrovare un token in un manuale e scegliere una procedura corretta davanti a una richiesta sono due compiti diversi. Il tutorial misura solo il primo.
Adattarsi senza puntare tutto sul nuovo dominio
Addestrando il modello sui manuali, modifichiamo pesi che partecipavano anche alle sue previsioni su altri testi. I suoi risultati possono quindi migliorare qui e peggiorare altrove.
L'oblio catastrofico indica questo problema di perdita di prestazioni nel corso di nuovi apprendimenti. Nel nostro esperimento osserviamo un indicatore più ristretto: un eventuale peggioramento sul corpus di controllo scelto. Non misuriamo l'insieme delle conoscenze precedenti di BERT.
Il replay svolge il ruolo di ripassi intervallati: invece di lavorare solo sul nuovo argomento, l'addestramento incontra anche esempi del controllo. Non ripristina vecchi pesi e non interroga un secondo modello. In r1, la variante modifica il programma dei batch, non il principio dell'MLM.
Infine, il confronto deve riguardare lo stesso esame. Per uno sviluppatore web, l'analogia è una suite di test di non regressione: cambiare i casi di test insieme all'implementazione impedisce di isolare ciò che ha prodotto la variazione del punteggio.
Prerequisiti Docker e GPU
Dovete saper leggere funzioni Python, liste, dizionari e JSON, e usare un terminale con Docker. I concetti di apprendimento necessari sono spiegati nel percorso.
La riproduzione r1 usa Linux x86_64, Docker Compose, NVIDIA Container Toolkit e una RTX 3090 da 24 GiB. Prevedete 16 GiB di RAM e 16 GiB di disco, esclusi i layer Docker condivisi. Sono le risorse previste dal progetto, non minimi misurati; qui non è validato alcun percorso CPU.
locks/models.lock.json fissa google-bert/bert-base-uncased alla revisione 86b5e0934494bd15c9632b12f734a8a67f723594. locks/environment.lock.json descrive l'ambiente. Come un file di dipendenze bloccate in un progetto web, questi file permettono di identificare la ricetta usata: non sostituite una versione per far sparire silenziosamente un errore.
Il servizio acquire scarica le risorse pubbliche. Il servizio gpu esegue i calcoli locali senza rete. Lo script check_environment.py inizializza CUDA, l'ambiente di calcolo NVIDIA, dal contenitore. Una scheda visibile sull'host non basta; deve poterla usare anche Docker. La guida GPU di Docker Compose spiega questa integrazione.
Dati e funzione centrale
Che cosa conteremo realmente?
Un corpus è un insieme di documenti. Uno split è una partizione di questo insieme: l'addestramento serve a modificare il modello, la validazione a seguire le scelte di sviluppo e il test alla valutazione finale. Il dominio e il controllo possiedono ciascuno una validazione e un test.
Ecco le quantità mantenute nella valutazione r1. Si tratta di posizioni supervisionate, cioè token sui quali si applica il punteggio, e non di numeri di documenti o domande.
| Partizione | Token valutati | Ruolo |
|---|---|---|
domain-validation |
3 089 | Seguire l'adattamento sul dominio |
domain-test |
3 054 | Misurare il risultato finale sul dominio |
control-validation |
1 318 | Seguire gli effetti sul controllo |
control-test |
1 233 | Misurare il risultato finale sul controllo |
I tre checkpoint ricevono le stesse posizioni e gli stessi input corrotti per ogni partizione. Il termine « token mascherati » è una scorciatoia: vedremo che alcune posizioni valutate rimangono visibili nell'input.
Un esempio del corpus r1 porta l'identificatore domain-006-0. È un manuale Velon fittizio su un accoppiamento di pompa: chiede di isolare la pompa prima dell'ispezione e menziona una temperatura di esercizio documentata di 62 gradi. Questa informazione appartiene ai dati dell'esercizio. Non è mai un'istruzione per un'apparecchiatura reale.
Fissare le domande e le relative soluzioni
Il seguente estratto continuo, tratto da src/domain_mlm/eval_masks.py, costruisce il set di confronto e poi verifica che resti identico.
def freeze_evaluation_masks(config):
    tokenizer = AutoTokenizer.from_pretrained("models", local_files_only=True)
    generator = torch.Generator().manual_seed(config["seed"] + 1000)
    sets = {}
    for corpus in ("domain", "control"):
        for split in ("validation", "test"):
            key = corpus + "-" + split
            rows = read_json("outputs/" + key + ".json")
            ids = torch.tensor([r["input_ids"] for r in rows])
            masked, labels, _ = mask_tokens(
                ids, tokenizer, generator, config["mask_probability"]
            )
            sets[key] = [
                {
                    **row,
                    "original_ids": row["input_ids"],
                    "input_ids": masked[i].tolist(),
                    "labels": labels[i].tolist(),
                }
                for i, row in enumerate(rows)
            ]
    target = Path("outputs/eval-masks.json")
    if target.exists():
        assert read_json(target) == sets, "Evaluation masks changed"
    else:
        save_json(target, sets)
Partiamo da ciò che questa funzione non fa: non chiama BERT per predire token e non avvia alcun addestramento. Prepara gli esempi che saranno inviati ai modelli in seguito.
AutoTokenizer.from_pretrained("models", local_files_only=True) carica il tokenizer già acquisito nella directory locale. Il nome models è qui un percorso, non una richiesta di download automatico.
torch.Generator().manual_seed(config["seed"] + 1000) crea un generatore pseudo-casuale dedicato. Il seme, o seed, fissa il punto di partenza della sua sequenza di estrazioni. Lo scarto + 1000 è una scelta del progetto: non significa « mille maschere ».
I due cicli percorrono successivamente domain-validation, domain-test, control-validation e control-test. torch.tensor(...) trasforma le liste di ID in una matrice numerica, o tensore. Questa costruzione presuppone righe di lunghezza compatibile; l'estratto non ne effettua direttamente il padding.
Dopo mask_tokens, ogni riga conserva i suoi metadati grazie a **row, quindi tre rappresentazioni complementari: original_ids per il testo tokenizzato prima della trasformazione, input_ids per l'input corrotto e labels per gli obiettivi da ritrovare. tolist() rende i tensori registrabili in JSON.
Infine, outputs/eval-masks.json viene creato se non esiste. Se esiste, il codice ricostruisce i dati attesi e li confronta integralmente con il contenuto registrato. Una differenza provoca Evaluation masks changed anziché sovrascrivere silenziosamente il vecchio esame. Il percorso r1 annuncia anche un blocco e conteggi di obiettivi per split; la loro scrittura complementare non appare in questo estratto.
Stesso seme e stesse maschere: due garanzie diverse
Il generatore è condiviso dalle quattro partizioni e avanza a ogni estrazione. Modificare l'ordine delle righe, la loro lunghezza o il numero di estrazioni può quindi modificare la sequenza ottenuta, anche mantenendo lo stesso seme iniziale. Il confronto del file protegge i dati effettivamente preparati, non soltanto un valore di configurazione.
Questa protezione ha un limite esplicito: usa assert. Python può disattivare le asserzioni in modalità ottimizzata, in particolare con l'opzione -O. Mantenete la modalità di esecuzione del percorso; in un adattamento di produzione, un controllo obbligatorio non dovrebbe dipendere da asserzioni disattivabili. È il comportamento descritto nella documentazione Python, non una modifica del codice qui sopra.
Fissare le maschere elimina una fonte di variazione, non tutte le altre. Occorre ancora conservare il tokenizer, i dati, i parametri di valutazione e l'ambiente. PyTorch ricorda che lo stesso seme non garantisce l'identità fra tutte le piattaforme o versioni.
Creare un input e obiettivi MLM
Il blocco descrive l'esame. L'estratto continuo di src/domain_mlm/collator.py descrive ora il meccanismo che crea input e obiettivi, usato anche per l'addestramento.
def mask_tokens(input_ids, tokenizer, generator, probability=0.15):
    if not 0 <= probability <= 1:
        raise ValueError("Mask probability out of range")
    eligible = torch.ones_like(input_ids, dtype=torch.bool)
    for value in tokenizer.all_special_ids:
        eligible &= input_ids != value
    chosen = (torch.rand(input_ids.shape, generator=generator) < probability) & eligible
    labels = input_ids.clone()
    labels[~chosen] = -100
    corrupted = input_ids.clone()
    choice = torch.rand(input_ids.shape, generator=generator)
    corrupted[chosen & (choice < 0.8)] = tokenizer.mask_token_id
    admissible = torch.tensor(
        [i for i in range(len(tokenizer)) if i not in tokenizer.all_special_ids]
    )
    random_ids = admissible[
        torch.randint(len(admissible), input_ids.shape, generator=generator)
    ]
    random_positions = chosen & (choice >= 0.8) & (choice < 0.9)
    corrupted[random_positions] = random_ids[random_positions]
    return corrupted, labels, eligible
Il primo passo consiste nel distinguere ciò che può essere scelto da ciò che è stato realmente scelto.
eligible è una matrice di booleani, della stessa forma degli ID. Il ciclo rimuove i token speciali del tokenizer, per esempio i marcatori di inizio, separazione o riempimento. Il padding, o riempimento, serve a completare le sequenze brevi per formare matrici della stessa larghezza; non rappresenta testo da ritrovare.
chosen applica poi un'estrazione a ogni posizione e la combina con eligible. Il parametro probability vale 0.15 per impostazione predefinita in questa funzione. Durante il blocco della valutazione, il chiamante trasmette config["mask_probability"]: occorre quindi consultare la configurazione bloccata per conoscere il valore effettivo del percorso.
labels inizia come copia dei token originali. Le posizioni non selezionate diventano -100. Con il contratto della cross-entropy di PyTorch, questo valore segnala un obiettivo da ignorare. Non sostituisce il testo nell'input del modello. Un token non supervisionato può sempre aiutare a ritrovare il vicino grazie al contesto.
Il codice crea poi corrupted, una copia indipendente dell'input. Per le posizioni scelte, una seconda estrazione determina la trasformazione: sotto 0.8, il token diventa il marcatore di maschera; fra 0.8 e 0.9, viene sostituito da un token casuale ammissibile; da 0.9 in poi resta invariato.
Ritroviamo quindi la ripartizione 80 % maschera, 10 % sostituzione casuale, 10 % invariato, tra le posizioni scelte. Sono probabilità, non quote esatte imposte a ogni batch. Se la selezione vale 15 %, le proporzioni attese sulle posizioni idonee sono rispettivamente 15 % × 80 % = 12 %, 1,5 % e 1,5 %.
Un dettaglio conta: admissible esclude gli ID speciali, ma non l'ID originale di ogni posizione. L'estrazione casuale può quindi ricadere sul token originale. Osservare un input invariato non basta a determinare quale ramo sia stato estratto.
Seguire una riga senza caricare BERT
Ecco un esempio didattico costruito a mano con ID fittizi. Non usa il vocabolario reale di BERT e non proviene dai risultati r1. Scegliamo tre posizioni per mostrare i tre rami; non cerchiamo di riprodurne le frequenze con una riga così piccola.
| Posizione | ID originale | Idonea? | Scelta? | ID fornito al modello | Label | Spiegazione |
|---|---|---|---|---|---|---|
| 0 | 1, inizio | No | No | 1 | -100 | Marcatore speciale |
| 1 | 7 | Sì | Sì | 3, maschera | 7 | Il modello deve ritrovare 7 |
| 2 | 8 | Sì | Sì | 12 | 8 | La sostituzione non cambia la soluzione |
| 3 | 9 | Sì | Sì | 9 | 9 | Il token resta visibile ma viene valutato |
| 4 | 10 | Sì | No | 10 | -100 | Contesto visibile, senza obiettivo diretto |
| 5 | 2, separazione | No | No | 2 | -100 | Marcatore speciale |
| 6 | 0, riempimento | No | No | 0 | -100 | Padding |
Ci sono tre obiettivi, ma un solo marcatore di maschera. Contare soltanto le occorrenze di [MASK] darebbe quindi il denominatore errato per la metrica. Gli obiettivi sono qui individuati con labels != -100.
I nomi simili possono creare confusione: eligible indica le posizioni candidate al mascheramento; chosen le posizioni supervisionate; una maschera di attenzione indica invece quali posizioni la rete può usare come contesto. La funzione mostrata non restituisce una maschera di attenzione: restituisce corrupted, labels e eligible.
Ultimo caso da conoscere prima di modificare il programma: la funzione accetta una probabilità nulla e non forza la presenza di un obiettivo in ogni batch. Con probability=0, tutte le label valgono -100. Un calcolo della perdita media deve gestire esplicitamente un batch senza obiettivo, anziché considerarlo un apprendimento perfetto. Questo estratto non mostra la politica di addestramento per questo caso; ciò non significa che si sia verificato in r1.
Installare, controllare e fissare l'esame
Preparare l'ambiente
Estraete lo ZIP e posizionate il terminale nella sua directory radice. Tutti i comandi seguenti partono da questa cartella. Mantengono l'ordine del percorso r1 descritto da README.md e lesson/tutorial.json.
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm gpu python -m pytest -q
setup.sh prepara il progetto. docker compose config --quiet verifica che la configurazione Compose sia utilizzabile, quindi build costruisce le immagini dei servizi. L'acquisizione recupera le risorse secondo i blocchi; il controllo dell'ambiente verifica CUDA nel contenitore; pytest esegue i test del programma.
Attendete che questi passaggi terminino senza errori prima dell'addestramento. Una suite di test riuscita controlla i meccanismi che copre; non dice ancora se l'adattamento sarà utile.
Preparare i documenti e conservare l'esame
docker compose run --rm gpu python -m domain_mlm.cli prepare --config configs/minimum.yaml
docker compose run --rm gpu python -m domain_mlm.cli inspect-mask --config configs/minimum.yaml
docker compose run --rm gpu python -m domain_mlm.cli freeze-eval --config configs/minimum.yaml
prepare crea i dati del percorso. inspect-mask permette di osservarne la trasformazione: avvicinate gli ID originali, l'input corrotto e le label. Cercate in particolare una posizione ignorata e una posizione scelta; non svolgono lo stesso ruolo.
freeze-eval prepara poi le quattro partizioni di valutazione fisse. In outputs/eval-masks.json, verificate la presenza dei loro nomi e dei campi original_ids, input_ids e labels. I conteggi degli obiettivi devono corrispondere alla tabella precedente.
Il blocco avviene prima degli addestramenti che vogliamo confrontare. Impedisce di sostituire discretamente un esame difficile con un altro più favorevole. Una modifica del checkpoint resta così confrontabile sugli stessi input, a condizione di conservare anche il resto del protocollo.
Adattare, riprendere e misurare
Ora possiamo avviare l'adattamento da solo, poi quello con replay. I comandi seguenti testano anche un'interruzione e una ripresa prima di produrre le misure finali.
docker compose run --rm gpu python -m domain_mlm.cli train --config configs/minimum.yaml
docker compose run --rm gpu python -m domain_mlm.cli train --config configs/minimum.yaml --variant replay
docker compose run --rm gpu python -m domain_mlm.cli train --config configs/minimum.yaml --stop-after 150 --run-name interrupted
docker compose run --rm gpu python -m domain_mlm.cli train --config configs/minimum.yaml --resume artifacts/checkpoints/interrupted/state.pt --run-name resumed
docker compose run --rm gpu python -m domain_mlm.cli compare-resume --config configs/minimum.yaml
docker compose run --rm gpu python -m domain_mlm.cli evaluate --config configs/minimum.yaml
docker compose run --rm gpu python -m domain_mlm.cli inspect-cases --config configs/minimum.yaml
Leggere i comandi come un esperimento
Il primo comando train segue il percorso di adattamento di dominio. Il secondo seleziona --variant replay. Secondo la descrizione r1, questa variante cambia soltanto il programma dei batch: introduce i ripassi del controllo nell'apprendimento. Non è un secondo tipo di modello né una nuova metrica.
Le due varianti devono poi essere rilette rispetto al riferimento non adattato, su dominio e controllo. Guardare solo i manuali equivarrebbe a verificare una nuova funzionalità dimenticando i test delle funzionalità esistenti.
Riprendere non significa solo ricaricare i pesi
Il comando con --stop-after 150 --run-name interrupted produce l'arresto previsto dal percorso. Il successivo riprende artifacts/checkpoints/interrupted/state.pt con il nome resumed. Rispettate quest'ordine: il file deve esistere prima della sua lettura.
Perché non limitarsi a ricaricare il modello e ricominciare? Perché una traiettoria di addestramento dipende anche dallo stato dell'ottimizzatore e dalle estrazioni casuali. Il RNG, o generatore di numeri pseudo-casuali, deve riprendere dal punto raggiunto, non necessariamente dall'inizio della sua sequenza. La documentazione di torch.Generator distingue proprio seme iniziale e stato salvato.
I passaggi interrupted, resumed e compare-resume servono a controllare questa ripresa completa in r1. Non devono essere interpretati come un addestramento supplementare destinato a migliorare il punteggio. Consultate il risultato di compare-resume per verificare questa proprietà durante la vostra esecuzione.
Infine, evaluate produce le metriche, poi inspect-cases mostra esempi. Quest'ordine è utile: i casi spiegano una misura globale, non la sostituiscono. Per un dato manuale, confrontate il token atteso, le previsioni e le loro probabilità; non selezionate solo il caso più convincente.
Metriche prima delle misure
NLL: quanta probabilità riceve la risposta corretta?
NLL significa negative log-likelihood, o log-verosimiglianza negativa. Per una posizione valutata, se il modello assegna la probabilità p al token originale, il suo contributo vale:
NLL della posizione = -ln(p)
ln è il logaritmo naturale. Non è necessario memorizzarne i valori: ricordate che attribuire più probabilità al token atteso riduce la penalità. Una probabilità molto bassa costa molto più di un'esitazione moderata. Il logaritmo naturale esprime questa perdita in nat, non in percentuale.
La tabella seguente è un esempio didattico con tre candidati, indipendente da BERT e dalle misure r1. « Altro » rappresenta qui un singolo terzo candidato; ogni riga somma a 1.
| Situazione fittizia | Probabilità del token atteso | Principale concorrente | Altro | Top-1 corretto? | NLL approssimativa |
|---|---|---|---|---|---|
| A | 0,20 | 0,75 | 0,05 | No | 1,6094 |
| B | 0,40 | 0,50 | 0,10 | No | 0,9163 |
| C | 0,60 | 0,35 | 0,05 | Sì | 0,5108 |
| D | 0,90 | 0,07 | 0,03 | Sì | 0,1054 |
Tra A e B, la scelta migliore resta errata, ma la probabilità del token atteso aumenta: la NLL migliora. Tra C e D, la scelta migliore resta corretta e la NLL distingue ancora le due distribuzioni. L'accuratezza top-1 non racconta dunque tutto ciò che raccontano le probabilità.
Su un corpus, sommiamo i contributi e poi dividiamo per il numero di posizioni supervisionate. Le altre posizioni, in particolare quelle la cui label vale -100, non devono diluire questa media.
Prendiamo un altro calcolo fittizio: un blocco apporta un obiettivo con NLL 2 e un altro tre obiettivi con NLL media 0,5. La media per token vale (2 + 3 × 0,5) / 4 = 0,875. La media non ponderata dei due blocchi darebbe (2 + 0,5) / 2 = 1,25, un'altra quantità. L'unità dichiarata qui è proprio il token valutato, non il documento o il batch.
Accuratezza top-1: la prima scelta è corretta?
Per ogni posizione supervisionata, prendiamo il token con la probabilità più alta e confrontiamo il suo ID con l'ID di riferimento.
accuratezza top-1 = numero di token predetti correttamente / numero di token valutati
Tre buone previsioni su quattro danno 3 / 4 = 0,75, ossia 75 %. Ciò non significa che tre documenti su quattro siano compresi interamente, né che tre risposte aziendali su quattro sarebbero corrette.
La soluzione resta il token originale. Un altro token plausibile non riceve credito perché una persona potrebbe trovare la frase accettabile. Allo stesso modo, predire correttamente una parte di parola non garantisce che l'intera parola o frase sia corretta. Queste convenzioni rendono la misura precisa, ma ne limitano l'interpretazione.
L'indicatore di oblio: una differenza con segno
Il campo control_test_forgetting_nll misura:
NLL della variante su control-test - NLL del riferimento su control-test
Un valore positivo significa che la NLL è aumentata: la variante è peggiore in questo esercizio di controllo. Un valore negativo indica un miglioramento. Zero significa che le due NLL medie sono uguali; ciò non prova che ogni previsione sia identica.
Esempio fittizio: se il riferimento vale 2,0 e la variante 2,6, l'indicatore vale +0,6. Con una variante a 1,7, vale -0,3. Queste differenze non sono né percentuali né numeri di conoscenze perse.
Un aumento della NLL può essere importante mentre il top-1 varia poco: il modello può mantenere molte prime scelte e ridurre fortemente la probabilità degli obiettivi in alcune posizioni. Le due metriche sono complementari.
Risultati reali e ciò che abbiamo imparato
I numeri seguenti sono quelli della riproduzione r1, sul corpus sintetico e sulle maschere fisse descritti sopra. Non sono gli esempi di calcolo della sezione precedente.
| Stato del modello | Top-1 su domain-test |
Top-1 su control-test |
control_test_forgetting_nll |
|---|---|---|---|
| Riferimento non adattato | 0,3850687622789784 | 0,46228710462287104 | 0, per definizione della differenza |
| Solo adattamento di dominio | 0,9747871643745907 | 0,45093268450932683 | +0,6229252393711704 |
| Adattamento con replay | 0,9754420432220039 | 0,9772911597729116 | -2,7341342250796132 |
La tabella riporta gli scarti di NLL, non i loro valori assoluti. Senza la NLL del riferimento, queste differenze non permettono di ricostruire le tre perdite. Conservate questa distinzione rileggendo gli output prodotti da evaluate.
Il solo adattamento migliora sui manuali, ma peggiora sul controllo
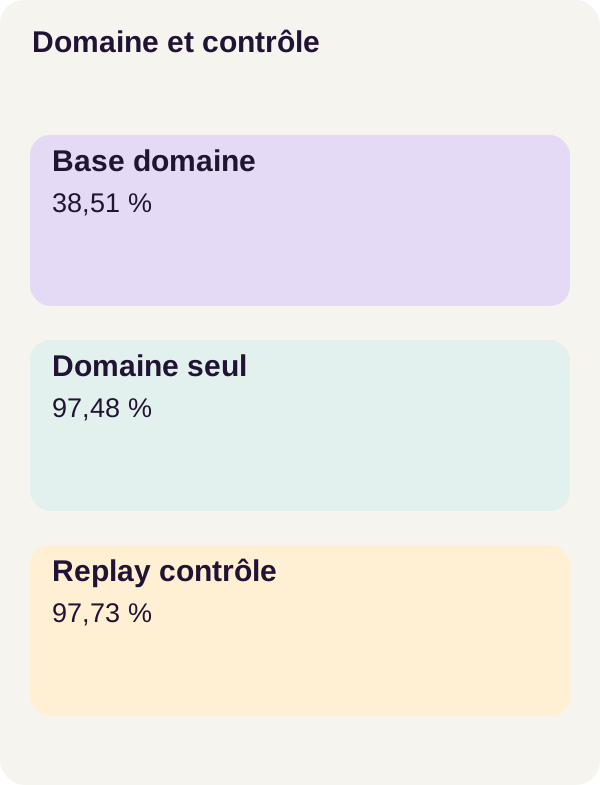
In percentuale, il top-1 del dominio passa da circa 38,51 % a 97,48 %. Sul controllo passa da circa 46,23 % a 45,09 %, ossia un calo di circa 1,14 punto percentuale. Anche l'indicatore NLL di +0,6229252393711704 descrive un peggioramento del controllo, su un'altra scala.
Possiamo rendere concrete queste proporzioni. Moltiplicando i tassi pubblicati per le quantità di obiettivi, ritroviamo 1 176 poi 2 977 token corretti su 3 054 per il dominio e 570 poi 556 su 1 233 per il controllo. Sono quantità calcolate dalle misure, non nuove inferenze.
Il risultato mostra dunque bene il compromesso cercato: un miglioramento sul nuovo dominio non garantisce il mantenimento delle prestazioni altrove.
Il replay migliora entrambi i punteggi in questo esperimento
Con il replay, il dominio raggiunge circa 97,54 %, ossia 2 979 token corretti su 3 054; il controllo raggiunge circa 97,73 %, ossia 1 205 su 1 233. L'indicatore NLL negativo mostra anch'esso un miglioramento del controllo rispetto al riferimento.
Sul dominio, lo scarto tra adattamento da solo e replay corrisponde a due token corretti aggiuntivi, ossia circa 0,0655 punto percentuale. Ciò rimette in prospettiva le molte cifre decimali della tabella: non sono prova di superiorità generale o di significatività statistica.
Sul controllo, il replay qui fa più che mantenere il livello iniziale: lo migliora fortemente. Il dato appartiene a questo corpus sintetico. Non possiamo dedurne che il modello abbia preservato tutte le sue capacità generali, né che saprà rispondere correttamente a una domanda di un utente.
Ciò che il blocco delle maschere non dimostra
Esempi identici rendono il confronto più leggibile. Non dimostrano però da soli l'assenza di sovrapposizione fra dati di addestramento e valutazione, né la diversità delle formulazioni.
La descrizione r1 indica un replay del corpus di controllo, ma i due estratti mostrati non dettagliano né gli ID reinseriti né la frequenza del replay. Per verificare questo confine, occorre leggere la configurazione e il programma dei batch dello ZIP. In un adattamento ai vostri dati, riservate partizioni di controllo distinte per il replay e per la valutazione: addestrare sul controllo test e poi valutarlo sarebbe un altro protocollo.
Questo punto non è un rilievo di fuga in r1. È una distinzione tra ciò che verifica il codice di mascheramento visibile qui e ciò che deve essere controllato altrove nel progetto.
La lezione principale non è quindi « il replay risolve l'oblio ». È più utile: misurare insieme l'apprendimento del dominio e le regressioni su un controllo, poi conservare le prove che permettono di comprenderne le differenze.
Esercizio: predire, poi eseguire
Immaginate due checkpoint valutati con maschere estratte indipendentemente. Il primo deve ritrovare parole comuni, il secondo riferimenti tecnici rari. Uno scarto di punteggio basta per attribuire un miglioramento o una regressione al modello?
Prima del comando, annotate la vostra risposta a questa domanda, poi a questa: il punteggio potrebbe cambiare anche se usassimo due volte esattamente lo stesso checkpoint?
Un piccolo controesempio costruito a mano aiuta a formulare l'ipotesi. Supponiamo che un modello fisso ritrovi correttamente le posizioni A e B, ma non C e D. Un esame sulle posizioni A e B dà 100 %. Un altro sulle posizioni C e D dà 0 %. I pesi non sono cambiati: sono cambiate soltanto le domande. Non è un output di BERT, ma una dimostrazione della trappola del confronto.
Avviate ora l'esercizio fornito:
docker compose run --rm gpu python -m domain_mlm.cli exercise --config configs/exercise.yaml
Confrontate il suo output con il set di maschere fisse. La spiegazione attesa non è che ogni cambiamento di maschera comporti necessariamente una variazione di punteggio: può anche non cambiare nulla. Il problema è che introduce una causa ulteriore, che il solo punteggio non permette di separare dall'effetto del checkpoint.
Al contrario, un esame fisso non deve diventare un insieme di risposte sul quale regoliamo continuamente i parametri. La validazione serve alle scelte di sviluppo; il test resta riservato al bilancio finale. Per studiare la variabilità del mascheramento in un esperimento separato, una possibilità sarebbe preparare in anticipo più esami e sottoporli tutti a ogni checkpoint. Questa estensione non è eseguita dal percorso presentato.
Concludete con le figure, il controllo dei checkpoint, l'anteprima della pulizia e l'arresto del progetto:
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
--dry-run mostra ciò che la pulizia prenderebbe di mira, ma non elimina alcun risultato. L'arresto di Compose non sostituisce la conservazione dei JSON e dei checkpoint necessari per rileggere il vostro esperimento.
Adattamento, produzione, risoluzione dei problemi e pulizia
Sostituire il corpus sintetico senza perdere il confronto
Cominciate definendo le capacità che il modello deve acquisire e quelle che deve conservare. Un corpus di controllo utile alla vostra applicazione deve rappresentare queste ultime; non è automaticamente un campione di tutto ciò che il preaddestramento iniziale aveva imparato.
Versionate i documenti, il tokenizer, le partizioni e le maschere. In un nuovo esperimento, isolate anche documenti simili o versioni dello stesso manuale per evitare che un test si riduca a ritrovare una formulazione quasi vista nell'addestramento. Questa raccomandazione completa il protocollo; nessuna verifica della vicinanza documentale è dettagliata dai due estratti presentati.
Scegliete le vostre impostazioni sulla validazione, mantenendo traccia dell'intervallo e della provenienza del replay. Fissate soglie di accettazione su dominio e controllo prima della consegna. Non riducete il confronto a un solo esempio riuscito o alla sola NLL del dominio.
Per testi francesi o multilingui, non supponete che la variante inglese bloccata risponda allo stesso bisogno. Cambiare tokenizer o modello crea un nuovo esperimento: il numero e la granularità dei token possono cambiare, quindi una NLL per token non è più direttamente confrontabile con quella di r1.
Passare dalle previsioni di token a un'applicazione
Il progetto adatta un modello linguistico mascherato. Non convalida un sistema di domande-risposte, un estrattore di istruzioni o una decisione di manutenzione. Questi usi richiedono dati di riferimento, criteri di errore e valutazioni propri da parte degli esperti del dominio.
Sui documenti aziendali, regolate l'accesso, le informazioni sensibili e la conservazione degli artefatti. Un manuale correttamente completato in un esercizio non diventa una procedura approvata. Il caso Velon e i suoi 62 gradi restano dati fittizi, non un'istruzione operativa.
Diagnosticare senza modificare silenziosamente l'esperimento
CUDA fallisce. Rieseguite check_environment.py, quindi verificate l'accesso del contenitore alla GPU con la guida NVIDIA Container Toolkit. Non cambiate modello per risolvere un problema di ambiente.
L'acquisizione fallisce. Ripristinate la rete del servizio acquire, quindi rieseguite il suo comando. Conservate i blocchi del modello e delle dipendenze; un'altra revisione non costituirebbe la stessa riproduzione.
Appare Evaluation masks changed. Confrontate i dati preparati, il loro ordine, la configurazione e il tokenizer con quelli del blocco iniziale. Non eliminate il vecchio file per far passare il controllo: perdereste la vostra base di confronto. Una modifica volontaria richiede un esperimento distinto e un nuovo blocco, non una sostituzione invisibile.
Manca il checkpoint di ripresa. Verificate che il comando interrupted sia terminato e abbia prodotto il file atteso prima di avviare resumed. L'esistenza di un qualunque file di pesi non sostituisce lo stato completo richiesto da questo comando.
Infine, docker compose down --remove-orphans arresta i servizi del progetto senza eliminare gli output descritti qui. clean.py --dry-run annuncia soltanto i suoi obiettivi. Conservate i vostri risultati prima di intraprendere una pulizia diversa.
Fonti ufficiali
Le misure, i percorsi, i comandi e i due estratti di codice qui sopra appartengono al percorso r1 scaricabile. I riferimenti seguenti servono ad approfondire i meccanismi; non sono la fonte dei suoi punteggi e non sostituiscono le sue versioni bloccate.
- Hugging Face: attività di masked language modeling e BERT base uncased: obiettivo MLM e modello usato.
- Devlin et al.: BERT e Gururangan et al.: Don't Stop Pretraining: contesto della rappresentazione bidirezionale e dell'adattamento tramite preaddestramento.
- PyTorch: cross entropy, riferimento versionato di CrossEntropyLoss, generatori casuali e riproducibilità: obiettivi ignorati, stato casuale e limiti delle garanzie.
- Python: istruzione assert, Docker Compose: supporto GPU e NVIDIA Container Toolkit: controlli di esecuzione e ambiente.