





Vous développez un écran de gestion qui doit récupérer un montant dans un PDF. L’assistant répond 120.00. Très bien… mais d’où vient ce nombre ? Du coût estimé, du coût approuvé, ou d’une autre ligne du document ? Avant de remplir le formulaire, vous aimeriez pouvoir cliquer sur la réponse et voir la zone qui la justifie.
C’est le point de départ de ce tutoriel. Nous suivrons le formulaire fictif Orion Service Record, qui contient une date, deux numéros de série et un coût approuvé. Notre programme devra répondre à une question sur la page, indiquer où se trouve la valeur et s’abstenir lorsque le champ demandé est absent.
Nous allons adapter un modèle capable de traiter des images et du texte avec LoRA, puis contrôler ses sorties en Python. Pas besoin de connaître cette technique à l’avance : nous verrons ce qu’elle modifie, comment elle apprend et, surtout, comment vérifier le résultat.
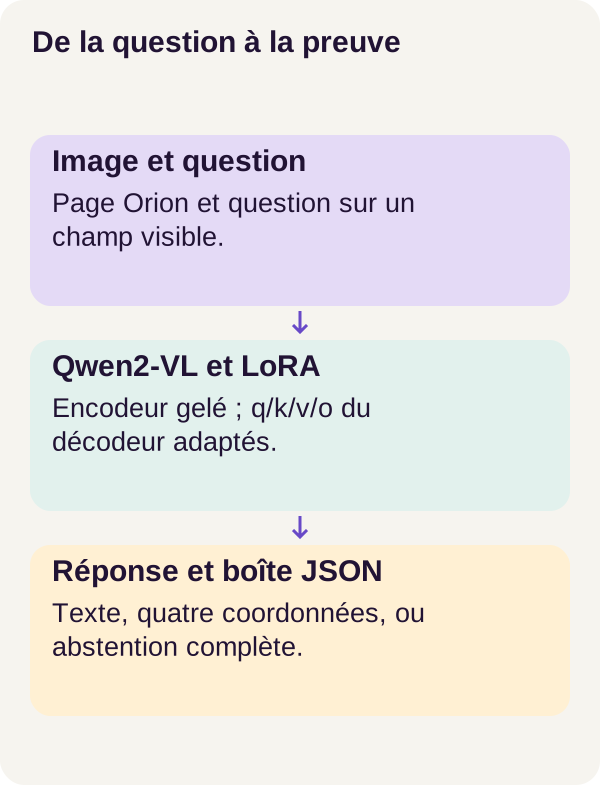
Le parcours suit image de page → question → modèle adapté → réponse et rectangle → validation → évaluation. Une réponse et un joli cadre ne suffiront pas : nous mesurerons séparément le texte, la localisation et l’abstention.
Le problème concret
Lire une page et répondre à une question sont deux tâches différentes. Un système peut reconnaître plusieurs montants sans savoir lequel correspond à « approved service cost ». Il peut aussi fournir le bon montant tout en désignant la mauvaise occurrence.
Nous faisons ici de la VQA, pour Visual Question Answering : répondre à une question à partir d’une image. Le PDF est rendu en image de page, puis cette image accompagne la question. Le résultat attendu n’est pas un résumé libre du document, mais une donnée structurée que le programme peut accepter ou rejeter.
Pour un développeur web, le parallèle est simple : comme avec une API, nous définissons un contrat de sortie. Mais un JSON conforme ne garantit pas que la donnée est vraie. Il faudra aussi comparer la prédiction aux annotations de référence, puis examiner la zone indiquée sur la page.
Le corpus est synthétique : ses formulaires sont générés pour une expérience contrôlée. Cela permet de connaître les réponses attendues et de provoquer certaines erreurs. Cela ne valide pas automatiquement le traitement de vos PDF clients.
Notions avant le code
Une réponse et une preuve forment un seul contrat
Notre question fil rouge demande le coût de service approuvé. Le modèle ne doit pas seulement produire 120.00, mais aussi une boîte, c’est-à-dire le rectangle de la zone qui porte la valeur demandée.
Voici une illustration du format attendu. Les coordonnées de cet exemple sont choisies pour l’explication ; ce n’est pas une prédiction mesurée du corpus.
{
  "answer": "120.00",
  "box": [600, 700, 800, 750]
}
answer est une chaîne de caractères, même pour un montant. box contient quatre coordonnées dans l’ordre gauche, haut, droite, bas. Elles sont exprimées sur une échelle de 0 à 1000, pas directement en pixels.
Pour un champ absent, la seconde forme autorisée est :
{
  "answer": null,
  "box": null
}
C’est une abstention : le système ne propose ni valeur ni localisation. Elle doit être complète. Une valeur sans boîte ou une boîte sans valeur est rejetée. De même, la chaîne "null" n’est pas la valeur JSON null : ce serait du texte, pas une absence.
Pourquoi conserver les deux éléments ensemble ? Parce que nous voulons éviter deux raccourcis. Un montant exact associé au mauvais rectangle ne permet pas de vérifier la bonne occurrence. À l’inverse, un rectangle bien placé ne rend pas un montant erroné acceptable.
Dans cet article, « preuve localisée » désigne la zone proposée comme justification. Le mot ne signifie pas que le programme a démontré la vérité de la réponse. Le modèle prédit aussi les coordonnées : elles peuvent être fausses. Le contrat rend cette proposition contrôlable ; l’évaluation dira si elle est correcte.
Ce que LoRA adapte réellement
Le modèle de base est Qwen2-VL-2B-Instruct. C’est un modèle vision-langage, ou VLM : il reçoit des informations visuelles et textuelles pour générer du texte. Sa fiche officielle présente la variante utilisée ; nous conservons celle du projet, sans la remplacer par un modèle plus récent.
Son encodeur visuel transforme l’image en représentations numériques. Son décodeur textuel utilise ces représentations et la question pour produire successivement les éléments de la réponse. Un token est une unité de texte manipulée par le modèle : un mot, un morceau de mot ou un signe peuvent occuper des tokens différents.
Le tokenizer convertit le texte en identifiants numériques. Le processeur prépare également les images pour le modèle. La documentation Qwen2-VL de Transformers illustre cette préparation multimodale. Vous n’avez pas à écrire un encodeur visuel dans ce tutoriel : nous utilisons les capacités du modèle préentraîné.
Les poids sont les paramètres numériques appris par le réseau. Un entraînement les ajuste à partir d’exemples et de réponses attendues. Adapter un modèle déjà entraîné à une tâche particulière s’appelle le fine-tuning, ou ajustement spécialisé.
LoRA, pour Low-Rank Adaptation, est une manière de réaliser cette adaptation sans modifier tous les poids. Dans notre projet, les poids de base restent gelés, donc non entraînables. Nous ajoutons de petites matrices qui apprennent une correction dans certaines couches. Cet ensemble de paramètres supplémentaires forme l’adaptateur.
Pensez à un composant existant dont on conserve le traitement principal et auquel on ajoute une correction spécialisée. L’analogie s’arrête là : cette correction n’est pas une liste de conditions écrites à la main, ce sont des nombres appris. Le guide conceptuel LoRA de PEFT décrit cette séparation entre poids gelés et matrices d’adaptation.
Pourquoi ce choix ici ? Nous disposons déjà d’un modèle vision-langage et voulons étudier une adaptation ciblée au contrat Orion. LoRA réduit le nombre de paramètres à entraîner et permet d’identifier l’adaptation enregistrée. Le parcours compare le modèle gelé et sa version adaptée ; il ne compare pas LoRA à un fine-tuning complet. Nous ne conclurons donc pas que LoRA est toujours la meilleure méthode.
Le corpus Orion comporte 400 pages. Le jeu de test contient 240 questions séparées : 180 répondables et 60 portant sur des champs absents. Pages et questions ne sont pas la même unité : ces nombres ne décrivent pas 240 PDF supplémentaires.
La préparation rend les pages, construit les paires question/réponse et fixe les rectangles attendus. Ces réponses de référence, parfois appelées gold, servent à apprendre et à évaluer. L’inférence, c’est-à-dire la production des prédictions, ne monte pas les annotations. Le programme doit travailler avec les entrées prévues, pas relire la solution.
La commande inspect-batch permettra d’examiner un lot : image, question, cible JSON et boîte. C’est le bon moment pour comprendre les exemples que nous demandons au modèle d’apprendre, avant de lancer l’entraînement.
Exemple de preuve localisée
Revenons à notre boîte illustrative [600, 700, 800, 750]. Sur une image de 1000 × 1000 pixels, elle correspond à un rectangle allant de 600 à 800 pixels horizontalement, et de 700 à 750 pixels verticalement.
Sur la même page rendue en 2000 × 2000 pixels, ce rectangle devient [1200, 1400, 1600, 1500] en pixels. Pourtant, sa représentation normalisée reste identique. Pour retrouver une abscisse, on calcule x_pixels = x_normalisé × largeur / 1000 ; pour une ordonnée, on utilise la hauteur.
Cette échelle ressemble à des pourcentages, avec 1000 comme borne plutôt que 100. Elle permet de désigner une même zone relative à différentes résolutions, à condition de conserver le même cadrage et la même orientation. Un recadrage change le repère ; augmenter la résolution ne rend pas non plus le modèle automatiquement plus précis.
Une page peut contenir « service cost » et « approved service cost ». Un cadre sur le premier champ ne justifie pas une réponse concernant le second, même si les montants coïncident. D’où l’intérêt de mesurer le recouvrement avec la boîte attendue.
La mesure utilisée est l’IoU, pour Intersection over Union : l’aire commune aux deux rectangles, divisée par l’aire totale couverte par l’un ou l’autre. Une valeur de 1 signifie qu’ils coïncident ; 0 signifie qu’ils n’ont aucune surface commune. Nous ferons ce calcul à la main après le code de validation.
Coder LoRA et choisir les tokens à apprendre
Deux petites matrices plutôt qu’une grande correction libre
Une couche linéaire transforme une liste de nombres en une autre liste de nombres. Ses coefficients sont rangés dans une matrice W. Une matrice est un tableau à deux dimensions ; un tenseur est le terme plus général utilisé par PyTorch pour les tableaux numériques.
LoRA conserve W et ajoute une correction de la forme (alpha/r) × B × A. La matrice A transforme l’entrée vers une petite dimension intermédiaire r ; B la transforme ensuite vers la dimension de sortie. On dit que la correction est de rang faible : sa construction limite le nombre de directions indépendantes qu’elle peut représenter.
Dans le projet, r = 8 et alpha = 16, donc le facteur multiplicatif vaut 16/8 = 2. Ce facteur règle l’amplitude de la correction ; ce n’est pas le taux d’apprentissage de l’optimiseur.
Les couches ciblées sont q_proj, k_proj, v_proj et o_proj dans l’attention du décodeur textuel. Pour les situer sans détailler tout le Transformer : les projections Q et K participent au calcul des rapprochements entre positions, V fournit les informations à combiner et O transforme le résultat de cette combinaison. Le calcul d’attention documenté par PyTorch illustre la combinaison de Q, K et V. Les noms désignent des couches du réseau, pas quatre outils de lecture de PDF. L’encodeur visuel reste gelé.
Prenons un exemple numérique indépendant des dimensions réelles de Qwen2-VL. Pour une projection de 1024 entrées vers 1024 sorties, W contient 1024 × 1024 = 1 048 576 coefficients. Avec un rang de 8, A contient 8 × 1024 = 8192 coefficients et B en contient autant : 16 384 paramètres d’adaptation, soit 64 fois moins que les coefficients de W, sans compter un éventuel biais.
Ce calcul porte sur une projection illustrative, pas sur le nombre total de paramètres du modèle. La grande matrice reste présente et utilisée. Réduire les paramètres entraînables ne signifie donc ni diviser toute la mémoire par 64, ni supprimer le coût du modèle de base.
Lire la couche LoRALinear
Voici la classe utilisée dans src/pdfvqa/lora.py. Les imports et le code qui l’insèrent dans le modèle sont fournis par le projet complet.
class LoRALinear(nn.Module):
    def __init__(self, base, rank=8, alpha=16, dropout=0.05):
        super().__init__()
        if not isinstance(base, nn.Linear) or rank <= 0 or not 0 <= dropout < 1:
            raise ValueError("Invalid LoRA layer")
        self.base = base.requires_grad_(False)
        self.A = nn.Parameter(
            torch.empty(
                rank, base.in_features, device=base.weight.device, dtype=torch.float32
            )
        )
        self.B = nn.Parameter(
            torch.zeros(
                base.out_features, rank, device=base.weight.device, dtype=torch.float32
            )
        )
        nn.init.kaiming_uniform_(self.A, a=math.sqrt(5))
        self.scale = alpha / rank
        self.dropout = nn.Dropout(dropout)

    def forward(self, x):
        original = self.base(x)
        update = torch.nn.functional.linear(
            torch.nn.functional.linear(self.dropout(x.float()), self.A), self.B
        )
        return (original.float() + self.scale * update).to(original.dtype)
La première partie conserve la couche originale. requires_grad_(False) indique à PyTorch de ne pas calculer de gradients pour ses paramètres. Un gradient sert à déterminer comment ajuster un paramètre pour réduire l’erreur d’apprentissage. Les poids gelés participent toujours au calcul ; ils ne sont simplement pas mis à jour par l’adaptation.
La deuxième partie crée les paramètres à apprendre. nn.Parameter enregistre A et B comme paramètres du module. Leurs dimensions correspondent bien au trajet « dimension d’entrée → rang → dimension de sortie ». Elles sont placées sur le même périphérique que la couche d’origine.
A reçoit une initialisation aléatoire, tandis que B commence à zéro. Au départ, passer par B donne donc une correction nulle : l’adaptateur ne modifie pas encore la sortie de la couche. L’entraînement apprendra ensuite cette correction, au lieu de commencer par perturber arbitrairement le modèle.
La méthode forward() calcule les deux branches. self.base(x) produit la sortie originale. Les deux appels à linear() appliquent successivement A et B. L’expression PyTorch correspond à la convention décrite par torch.nn.functional.linear, où le poids est stocké dans l’ordre sortie, entrée. On multiplie enfin la correction par self.scale, puis on l’ajoute à la sortie originale.
Le dropout intervient seulement dans la branche d’adaptation. Pendant l’apprentissage, sa valeur 0.05 donne à chaque élément une probabilité de 5 % d’être mis à zéro ; les éléments conservés sont redimensionnés par le module. En mode évaluation, il ne modifie plus son entrée. C’est le comportement documenté de nn.Dropout, pas une suppression définitive de paramètres.
Enfin, x.float(), les matrices en torch.float32 et original.float() rendent explicite le calcul de la correction et de la somme en FP32, un format sur 32 bits. .to(original.dtype) remet le résultat dans le type de la sortie initiale. Ne confondez pas cette gestion des formats numériques avec le gel des poids : l’une concerne la représentation des nombres, l’autre les paramètres que l’on entraîne.
Apprendre la réponse, pas recopier tout le contexte
Nous avons défini ce qui peut changer dans le modèle. Il faut maintenant définir sur quelles positions de texte nous calculons l’erreur.
Pendant l’entraînement, une séquence contient le contexte — dont la question et les éléments associés à l’image — puis la réponse attendue de l’assistant. La fonction de perte, ou loss, mesure l’écart entre les prédictions et les tokens à apprendre. Nous voulons entraîner la réponse JSON, pas demander au modèle de recopier la question ou les positions de remplissage.
Le padding, ou remplissage, ajoute des positions pour organiser des séquences de longueurs différentes dans des tableaux. Ces positions ne sont pas du contenu à prédire. Le code utilise donc la valeur spéciale -100 dans les étiquettes d’apprentissage, les labels, pour les positions ignorées par la perte.
def assistant_labels(input_ids, attention_mask, prompt_length, forbidden_ids):
    if (
        input_ids.ndim != 1
        or attention_mask.shape != input_ids.shape
        or not 0 < prompt_length < len(input_ids)
    ):
        raise ValueError("Invalid completion boundary")
    labels = input_ids.clone()
    labels[:prompt_length] = -100
    labels[~attention_mask.bool()] = -100
    for identifier in forbidden_ids:
        labels[input_ids == identifier] = -100
    if (labels != -100).sum() == 0:
        raise ValueError("No assistant target token")
    if (labels[:prompt_length] != -100).any():
        raise ValueError("Prompt included in loss")
    return labels
Le contrôle initial attend une séquence à une dimension, un attention_mask de même forme et une frontière prompt_length située après le début mais avant la fin. Cette frontière sépare le contexte de la réponse.
clone() copie les identifiants pour construire les labels sans modifier l’entrée. Les trois opérations suivantes marquent à -100 le préfixe du prompt, les positions où le masque d’attention vaut zéro et les identifiants présents dans forbidden_ids. Si aucune cible ne subsiste, la fonction refuse l’exemple au lieu de lancer un apprentissage sans réponse à apprendre. Le dernier contrôle vérifie que le prompt est bien exclu.
Prenons un exemple pédagogique d’identifiants, sans lien avec le vrai vocabulaire du tokenizer. L’entrée est [101, 501, 502, 601, 602, 603, 0], le préfixe occupe les trois premières positions, la dernière est du padding et 603 fait partie des identifiants interdits. Les labels deviennent [-100, -100, -100, 601, 602, -100, -100].
Seules les cibles 601 et 602 contribuent directement à la perte. Le contexte n’a pourtant pas été retiré de l’entrée. Le modèle peut toujours s’en servir pour produire la réponse. Masquer une cible d’apprentissage ne revient pas à effacer la question ou l’image.
La valeur -100 n’est donc ni un token que le modèle doit générer, ni un synonyme de JSON null. Elle signifie seulement « ignorer cette position pour la perte », selon le mécanisme ignore_index documenté par PyTorch.
La perte décale ensuite les cibles : la prédiction à une position apprend le token suivant. Ce décalage n’est pas réalisé dans assistant_labels(). La fonction présentée construit le masque ; le calcul de perte l’utilise ensuite. Dans la cible JSON, les valeurs et les coordonnées sont ainsi apprises à travers leur représentation en tokens.
À retenir : LoRA choisit quels paramètres changent ; le masque choisit quelles cibles contribuent à l’apprentissage ; le validateur vérifiera la forme de la sortie produite. Ces trois mécanismes ont des rôles différents.
Valider la réponse générée
Après l’inférence, nous recevons du texte brut. Il peut être incomplet, mal formé, ou contenir des coordonnées impossibles. Nous le contrôlons avant de le considérer comme une réponse exploitable par le programme.
L’extrait suivant provient de src/pdfvqa/validate_answer.py. Il ne consulte pas la réponse attendue pour arranger la prédiction.
"""Validate raw model output, without repairing it from the expected answer."""

import json


def validate_answer(raw, terminated=True):
    if not terminated:
        return {"valid": False, "error": "length", "value": None}
    try:
        value = json.loads(raw)
    except (ValueError, TypeError):
        return {"valid": False, "error": "json", "value": None}
    if not isinstance(value, dict) or set(value) != {"answer", "box"}:
        return {"valid": False, "error": "schema", "value": None}
    answer, box = value["answer"], value["box"]
    if answer is None and box is None:
        return {"valid": True, "error": None, "value": value}
    if answer is None or box is None:
        return {"valid": False, "error": "asymmetric_null", "value": None}
    if not isinstance(answer, str) or not answer.strip():
        return {"valid": False, "error": "answer", "value": None}
    if (
        not isinstance(box, list)
        or len(box) != 4
        or any(type(x) is not int for x in box)
    ):
        return {"valid": False, "error": "box_type", "value": None}
    if not 0 <= box[0] < box[2] <= 1000 or not 0 <= box[1] < box[3] <= 1000:
        return {"valid": False, "error": "box_bounds", "value": None}
    return {"valid": True, "error": None, "value": value}


def iou(a, b):
    intersection = max(0, min(a[2], b[2]) - max(a[0], b[0])) * max(
        0, min(a[3], b[3]) - max(a[1], b[1])
    )
    union = (a[2] - a[0]) * (a[3] - a[1]) + (b[2] - b[0]) * (b[3] - b[1]) - intersection
    return intersection / union if union > 0 else 0.0
Du texte brut à un objet accepté ou rejeté
terminated indique si la génération s’est terminée correctement. Lorsqu’il vaut False, la fonction retourne l’erreur length, même si le début de la sortie semble utilisable. L’appelant doit transmettre cet état : le validateur ne devine pas, à partir de la chaîne seule, comment le modèle s’est arrêté.
json.loads() décode ensuite le texte. Un échec donne json. Après décodage, le programme exige un dictionnaire contenant exactement answer et box : une clé manquante ou supplémentaire donne schema.
Vient ensuite le contrôle du couple. Deux valeurs None, issues des deux null JSON, constituent une abstention valide. Une seule valeur nulle produit asymmetric_null : l’abstention est incomplète. Sinon, answer doit être une chaîne non vide après vérification des espaces.
La boîte doit être une liste de quatre entiers, puis respecter 0 ≤ gauche < droite ≤ 1000 et 0 ≤ haut < bas ≤ 1000. Les inégalités strictes interdisent une largeur ou une hauteur nulle. La vérification type(x) is not int refuse notamment un booléen à la place d’une coordonnée. Les erreurs distinguent le type incorrect (box_type) d’une géométrie hors contrat (box_bounds).
La fonction utilise answer.strip() pour détecter une chaîne vide, mais retourne l’objet d’origine : elle ne nettoie pas systématiquement la réponse. Elle ne convertit pas non plus un montant, ne vérifie pas une devise et ne remplace pas des coordonnées hors page par leur valeur limite.
valid=True veut donc dire « conforme au contrat contrôlé ici », pas « correct dans le document ». Un mauvais montant accompagné d’un rectangle bien formé peut passer. De même, une abstention peut être structurellement valide alors que la page contient la réponse. C’est à l’évaluation de justesse de distinguer ces cas.
Calculer l’IoU avec un petit déplacement
La fonction iou() calcule d’abord la largeur et la hauteur de l’intersection. Les max(0, ...) empêchent de créer une aire négative lorsque les rectangles ne se touchent pas. L’union est la somme des deux aires, moins leur intersection, pour ne pas compter deux fois la zone commune.
Reprenons un exemple numérique illustratif, pas une mesure Orion. La boîte de référence est [600, 700, 800, 750]. La prédiction est décalée de 100 unités vers la droite : [700, 700, 900, 750].
Chaque rectangle a une aire de 200 × 50 = 10 000. Leur intersection ne mesure plus que 100 × 50 = 5000. L’union vaut 10 000 + 10 000 − 5000 = 15 000. L’IoU est donc 5000 / 15 000 = 1/3, soit environ 0,3333.
Le texte pourrait être resté exactement 120.00 dans les deux réponses. La baisse de l’IoU ne mesure pas un changement du texte : elle mesure la dégradation de la localisation. L’exercice final provoquera précisément cette séparation sur les sorties du projet.
La fonction iou() suppose des boîtes utilisables pour ce calcul ; elle ne remplace pas validate_answer(). Quant aux coordonnées prédites, elles ne sont jamais corrigées après génération à l’aide du gold. Sinon, nous mesurerions une réponse assistée par la solution, et non la prédiction du modèle.
Prérequis et commandes
Vous devez savoir lire du Python, utiliser un terminal et lancer Docker. Les extraits précédents expliquent les mécanismes ; le ZIP fournit le projet complet nécessaire à leur exécution.
Le profil de référence utilise Linux, Docker Engine, Compose, un pilote NVIDIA et NVIDIA Container Toolkit, sur une RTX 3090 de 24 Gio compatible BF16. Le parcours conseille 48 Gio de RAM et 55 Gio de disque. Ce sont des recommandations de préparation ; le profil CPU n’est pas validé.
La VRAM est la mémoire de la carte graphique, distincte de la RAM de la machine. BF16 désigne un format numérique sur 16 bits, parmi les types numériques de PyTorch. Sa présence dans le profil ne signifie pas que tous les calculs utilisent ce format : nous venons de voir la correction LoRA explicitement préparée en FP32.
Le pilote permet le calcul GPU sur l’hôte. NVIDIA Container Toolkit fournit l’intégration avec Docker. Voir la carte avec nvidia-smi confirme sa visibilité sur Linux, pas encore le fonctionnement du modèle dans le conteneur. check_environment.py effectue cette seconde vérification. La documentation officielle NVIDIA détaille l’installation adaptée au système ; les contrôles du projet ne modifient pas silencieusement celui-ci.
Décompressez le ZIP et placez le terminal dans son dossier racine. Toutes les commandes ci-dessous partent de cette racine et se lancent dans l’ordre. Le service acquisition récupère les actifs du modèle, tutorial prépare les données, entraîne et évalue, tandis que inference produit les prédictions sans consulter les labels.
Étape 1 — préparer
Nous vérifions l’environnement, préparons le projet, construisons les services et acquérons les fichiers attendus avant de lancer les tests.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
Chaque commande doit se terminer avec un code retour nul, donc sans erreur signalée. Ces contrôles ont des objectifs différents : Compose vérifie la configuration, le build construit les images, l’acquisition verrouillée récupère les actifs prévus, puis le contrôle d’environnement exécute le modèle dans Docker. Les tests vérifient enfin des comportements du programme.
Un build réussi ne remplace ni le contrôle GPU ni les tests. Et des tests réussis ne signifient pas que toutes les réponses du modèle seront correctes : cette mesure vient ensuite.
Étape 2 — construire la prédiction
Préparons les pages et leurs questions, regardons un lot, puis produisons une première référence sans adaptation.
docker compose run --rm tutorial python -m pdfvqa.cli prepare --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfvqa.cli inspect-batch --config configs/minimum.yaml
docker compose run --rm inference python -m pdfvqa.cli baseline --config configs/minimum.yaml
prepare construit les entrées et les cibles. inspect-batch permet d’inspecter ce que reçoit le modèle et ce qu’on lui demande de produire. Pour la question fil rouge, repérez le coût approuvé, puis vérifiez que la cible désigne bien ce champ plutôt que l’autre coût.
baseline signifie référence de comparaison. Ici, elle utilise le modèle gelé, sans l’adaptation Orion, mais avec le même contrat de sortie. Cette étape répond à une question essentielle : que sait déjà faire le modèle avant notre entraînement ?
Ouvrez les sorties intermédiaires. L’inspection sert à comprendre les données et les erreurs, pas à réécrire une réponse de référence pour qu’elle corresponde à une prédiction.
Étape 3 — mesurer et contrôler
Nous pouvons maintenant entraîner l’adaptateur, contrôler une reprise après interruption, puis produire et évaluer les réponses adaptées.
docker compose run --rm tutorial python -m pdfvqa.cli train --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfvqa.cli train-continuous --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfvqa.cli train-resume --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfvqa.cli verify-resume --config configs/minimum.yaml
docker compose run --rm inference python -m pdfvqa.cli predict --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfvqa.cli evaluate --config configs/minimum.yaml
train apprend les paramètres LoRA et enregistre un checkpoint, un état permettant de conserver le travail réalisé. Les commandes train-continuous et train-resume comparent une exécution continue à une exécution reprise. verify-resume vérifie que l’interruption n’a pas changé l’expérience.
Reprendre correctement demande plus que recharger quelques matrices. L’optimiseur, qui pilote leurs mises à jour, possède aussi un état ; les générateurs aléatoires doivent être restaurés. Le résultat de référence r001 indique une reprise EXACT. Cela décrit le contrôle de ce parcours, pas une promesse d’identité numérique sur tout matériel ou après modification des dépendances.
predict exécute ensuite le modèle adapté dans le service d’inférence. evaluate rejoint les prédictions et les annotations pour calculer les mesures. Les labels servent donc à noter après prédiction, pas à aider le modèle au moment où il répond.
Mesures avant les chiffres
Lire les métriques dans le bon ordre
Commençons par la validité JSON et du contrat. Le nom peut faire penser au simple décodage JSON, mais le contrôle présenté va plus loin : clés exactes, types, couple réponse/boîte et coordonnées. Un rejet doit rester visible ; il ne faut pas sauver les seuls fragments qui donnent une impression de réussite.
L’exactitude de réponse compare le texte à la référence après la règle de normalisation prévue par le projet. Ce n’est pas une appréciation libre du sens. Ne remplacez pas cette règle par une conversion de montant ou une reformulation choisie après avoir vu les résultats.
L’IoU mesure le recouvrement des boîtes pour les questions répondables. Elle ne s’applique pas aux champs absents : il n’existe pas de rectangle attendu à comparer à une abstention.
La justesse jointe exige que les contrôles de réponse, de schéma et de localisation soient satisfaits ensemble. Une bonne valeur ne compense donc pas une mauvaise boîte. Le seuil numérique d’acceptation de la localisation n’est pas détaillé dans cette présentation : conservez la règle de l’évaluateur du ZIP, sans la déduire de la moyenne d’IoU ni lui substituer un seuil arbitraire.
Enfin, la précision d’abstention répond à « parmi les abstentions émises, combien concernent réellement des champs absents ? ». Le rappel d’abstention répond à « parmi les champs absents, combien ont bien conduit à une abstention ? ».
Exemple pédagogique : sur dix champs absents, un système s’abstient correctement huit fois, mais s’abstient aussi une fois alors que la réponse est présente. Son rappel vaut 8/10 = 0,8 ; sa précision vaut 8/9, soit environ 0,8889. Les deux mesures ne racontent pas la même erreur. Cet exemple n’est pas le résultat du modèle Orion.
Un système qui répond toujours peut oublier les absences ; un système qui s’abstient toujours peut manquer toutes les valeurs présentes. C’est pourquoi nous conservons les deux populations et plusieurs mesures.
Interpréter les sorties étape par étape
Après predict, recherchez la réponse JSON brute, son statut de validation, la boîte et la surimpression, également appelée overlay. Il s’agit du rectangle dessiné sur l’image pour faciliter votre inspection, pas d’une validation supplémentaire du modèle.
Pour une sortie acceptée, comparez le texte, le champ demandé et la zone encadrée. Pour une sortie rejetée, gardez l’erreur : json, schema, box_bounds ou un autre motif. Transformer un résultat invalide en phrase plausible ferait perdre le diagnostic.
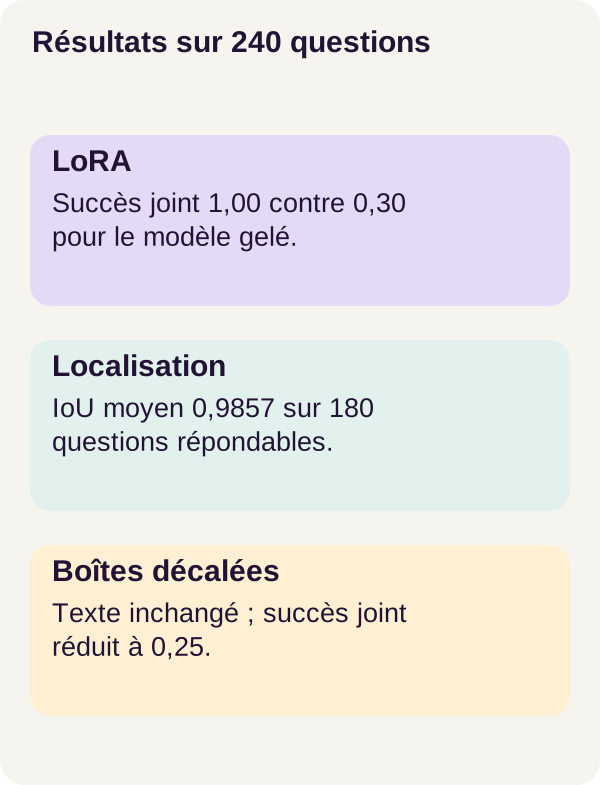
Voici les résultats de référence r001, sur les 240 questions de test du corpus synthétique Orion :
Sur mobile, faites défiler le tableau horizontalement.
| Mesure LoRA | Population concernée | Résultat observé |
|---|---|---|
| Exactitude de réponse | 240 questions | 1,0000 |
| Validité JSON et du contrat | 240 questions | 1,0000 |
| Justesse jointe | 240 questions | 1,0000 |
| IoU moyen | 180 questions répondables | 0,9857 |
| Précision d’abstention | Abstentions sur le test | 1,0000 |
| Rappel d’abstention | 60 champs absents | 1,0000 |
Le modèle gelé atteint 0,3000 de justesse jointe, contre 1,0000 après adaptation LoRA. Sur les 240 questions, cela correspond à 72 réussites jointes contre 240, selon le critère de ce parcours.
Comment lire le contraste entre justesse jointe parfaite et IoU de 0,9857 ? Les réponses passent toutes le critère de localisation de l’évaluateur, mais les rectangles ne coïncident pas tous exactement avec leur référence. Une réussite au critère n’est pas une égalité parfaite de coordonnées.
Les résultats montrent ici un gain de l’adaptation par rapport au modèle gelé. Ils ne prédisent pas les performances sur des écritures manuscrites, des scans dégradés ou des libellés clients différents. Ils ne démontrent pas non plus une supériorité sur des méthodes que ce parcours ne compare pas.
Dépannage et passage à un produit
Le modèle n’est pas utilisable dans Docker ? Revenez au contrôle d’environnement, à l’accès au GPU et à l’intégration NVIDIA. Un problème d’exécution ne se diagnostique pas à partir d’une métrique de réponse.
Le JSON est rejeté ? Inspectez le prompt, les limites de génération et la version du modèle. Une réponse arrêtée trop tôt peut être incomplète. Une boîte hors page reste invalide : ne la tronquez pas pour lui faire passer le contrôle et ne récupérez pas la valeur dans la référence.
Le texte est exact mais la boîte mal placée ? Montrez cette sortie comme insuffisamment justifiée. L’interface peut aider à voir l’erreur ; elle ne doit pas masquer celle-ci sous un score global.
Pour un produit, chaque proposition devrait rester liée à un PDF immuable, à une page, à une zone, à une version du modèle et à un journal de décision. Ce sont des éléments à prévoir autour du tutoriel, pas de nouveaux champs à ajouter silencieusement au contrat JSON testé.
Ce que nous avons appris
LoRA apprend une correction de faible rang dans des projections ciblées, sans modifier les poids de base. Le masque d’apprentissage conserve le contexte dans les entrées, mais limite les cibles sur lesquelles la perte est calculée.
Une fois la réponse produite, Python vérifie son contrat. L’évaluation vérifie ensuite autre chose : le bon texte, la bonne zone et la bonne décision de répondre ou de s’abstenir. Aucune de ces dimensions ne remplace les autres.
Sur Orion, l’adaptation améliore nettement la justesse jointe par rapport au modèle gelé. Pour comprendre pourquoi une réponse textuellement exacte reste insuffisante, nous allons maintenant déplacer uniquement sa justification visuelle.
Exercice — déplacer la preuve sans changer le texte
Avant de lancer l’exercice, écrivez votre hypothèse. Que deviennent l’exactitude textuelle, l’IoU et la justesse jointe si chaque boîte est décalée horizontalement de 100 unités normalisées, sans changer les réponses ? Que doit-il arriver aux abstentions, qui ne possèdent pas de boîte ?
Pensez au petit calcul précédent : deux rectangles peuvent rester dans la page tout en se recouvrant beaucoup moins. « Coordonnées autorisées » et « bonne localisation » ne sont pas synonymes.
Exécutez ensuite l’expérience fournie, sans modifier le code validé :
docker compose run --rm tutorial python -m pdfvqa.cli exercise --config configs/exercise.yaml
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
La première commande réalise l’exercice. La suivante produit les figures, et la dernière contrôle les checkpoints attendus. Comparez les sorties à votre prédiction avant de vous contenter du score final.
Résultat observé : les 240 textes restent identiques et l’exactitude textuelle vaut 1. L’IoU moyen tombe à 0,1692 et la justesse jointe à 0,25. Les 60 abstentions restent correctes, et aucune boîte n’est hors limites.
Le 0,25 devient particulièrement parlant : les 60 abstentions représentent 60/240 = 0,25 du test. Elles suffisent à expliquer toutes les réussites jointes restantes. Le texte n’a pas changé ; c’est la localisation des réponses présentes qui ne passe plus le contrôle conjoint.
Il n’y a pas de contradiction avec le validateur. Un rectangle déplacé peut conserver quatre entiers, une largeur positive et des coordonnées entre 0 et 1000. Il reste bien formé tout en montrant la mauvaise zone.
Cette perturbation des sorties est distincte des deux pages supplémentaires de l’exercice, dont un champ a réellement changé de position. Dans un cas, nous déplaçons une boîte après prédiction ; dans l’autre, nous changeons le document que le modèle doit lire. Ne présentez pas les chiffres de la première expérience comme la mesure de la seconde.
Choisir une action après l’évaluation
Une réponse insuffisamment justifiée doit être présentée à un opérateur avec le PDF et sa surimpression, pas envoyée automatiquement vers un système comptable. Une abstention ne doit pas être remplacée par la valeur approximative qui paraît la plus proche.
Il faut toutefois distinguer une métrique d’évaluation d’un contrôle disponible en production. La justesse jointe et l’IoU avec le gold nécessitent une annotation connue. Sur un nouveau PDF sans référence, le programme ne dispose pas soudainement de ces scores pour décider tout seul. Les règles de rejet, les contrôles métier et la revue humaine doivent donc être conçus et évalués séparément.
De même, le contrat testé exprime l’abstention par deux valeurs nulles ; il ne contient pas de champ expliquant son motif. Conserver un motif vérifié dans un journal ou une interface est un travail d’intégration supplémentaire, pas une information qu’il faudrait inventer à partir de null.
Pour adapter l’expérience à vos formulaires, séparez les données par famille et modèle de document. Gardez le test à part avant les itérations, puis mesurez séparément réponse, schéma, localisation et abstention. L’objectif n’est pas seulement d’obtenir un meilleur chiffre, mais de savoir quelles erreurs il peut cacher.
Sorties attendues et erreurs utiles
Après prepare, repérez les pages, les questions et les cibles séparées. Après baseline, conservez les sorties du modèle gelé pour comparer les mêmes cas. Après predict, examinez valid, error, puis answer et box dans la réponse structurée lorsqu’elle est disponible. Dans l’extrait de validation, cette réponse est rangée sous value, qui vaut None en cas de rejet.
evaluate précise les populations et distingue test et exercice. Cette distinction évite de mélanger des questions nouvelles avec une perturbation artificielle de prédictions existantes.
Un résultat asymmetric_null signale une réponse sans boîte, ou une boîte sans réponse. box_type signale un problème de représentation ; box_bounds, un problème de limites ou d’ordre des coordonnées. Ces erreurs sont des sorties utiles du programme. Les faire disparaître sans comprendre leur cause rendrait le système moins observable, pas plus exact.
Production, limites et nettoyage
Le tutoriel fournit une expérience sur des formulaires fictifs. Pour passer à des documents réels, constituez des exemples autorisés et représentatifs, avec des réponses et des zones vérifiées. Les variations de libellés, de qualité d’image et de mise en page doivent être évaluées plutôt que supposées couvertes.
Conservez la version du modèle, le document, la page, les zones, les unités et les règles de rejet. Ajoutez les droits d’accès, la surveillance et une revue humaine pour les coûts ou décisions contractuelles. Une absence, une unité ambiguë ou une boîte invalide ne doivent jamais être transformées en certitude par la seule présentation de l’interface.
Avant le nettoyage, sauvegardez les exports utiles. Le script ci-dessous ne vise que outputs/ :
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Le premier docker compose down arrête les services du projet. Le conteneur lancé ensuite exécute le nettoyage ciblé, puis le dernier arrêt termine le parcours. Ces commandes ne demandent pas de purge Docker globale.
Pour approfondir la méthode, la documentation officielle de PEFT et LoRA présente les adaptateurs sur modèles préentraînés. L’article fondateur de LoRA détaille l’idée d’une correction de faible rang. Ces références complètent l’explication ; l’implémentation présentée ici reste la classe LoRALinear du ZIP, pas une réécriture avec une autre bibliothèque.
Les documentations liées dans cet article servent à comprendre les mécanismes. Pour reproduire r001, conservez les commandes, la configuration et les dépendances du projet fourni : un exemple de documentation n’est pas une invitation à modifier l’environnement de référence.
Ce que nous avons appris : une valeur devient contrôlable lorsqu’elle reste reliée à sa page, à une zone et à des règles de validation explicites. La dernière étape n’est pas de croire le cadre affiché, mais de vérifier ce qu’il montre.