





Está desarrollando una pantalla de gestión que debe extraer un importe de un PDF. El asistente responde 120.00. Muy bien..., pero ¿de dónde procede esa cifra? ¿Del coste estimado, del coste aprobado o de otra línea del documento? Antes de completar el formulario, querría poder pulsar la respuesta y ver la zona que la justifica.
Este es el punto de partida del tutorial. Seguiremos el formulario ficticio Orion Service Record, que contiene una fecha, dos números de serie y un coste aprobado. Nuestro programa deberá responder una pregunta sobre la página, indicar dónde está el valor y abstenerse cuando falte el campo solicitado.
Adaptaremos con LoRA un modelo capaz de procesar imágenes y texto, y controlaremos sus salidas en Python. No necesita conocer esta técnica de antemano: veremos qué modifica, cómo aprende y, sobre todo, cómo comprobar el resultado.
El recorrido sigue imagen de página → pregunta → modelo adaptado → respuesta y rectángulo → validación → evaluación. Una respuesta y un marco bonito no bastarán: mediremos por separado el texto, la localización y la abstención.
El problema concreto
Leer una página y responder una pregunta son dos tareas distintas. Un sistema puede reconocer varios importes sin saber cuál corresponde a «approved service cost». También puede dar el importe correcto y señalar la ocurrencia equivocada.
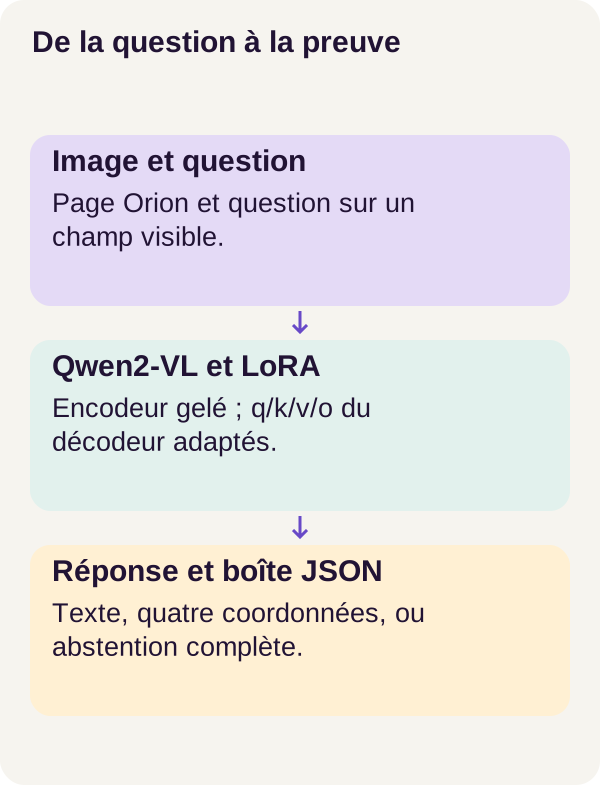
Aquí hacemos VQA, por Visual Question Answering: responder una pregunta a partir de una imagen. El PDF se representa como imagen de página y esa imagen acompaña a la pregunta. El resultado esperado no es un resumen libre del documento, sino un dato estructurado que el programa puede aceptar o rechazar.
Para un desarrollador web, el paralelismo es sencillo: como con una API, definimos un contrato de salida. Pero un JSON conforme no garantiza que el dato sea verdadero. También habrá que comparar la predicción con las anotaciones de referencia y examinar la zona indicada en la página.
El corpus es sintético: sus formularios se generan para un experimento controlado. Esto permite conocer las respuestas esperadas y provocar determinados errores. No valida automáticamente el tratamiento de sus PDF de clientes.
Conceptos antes del código
Una respuesta y una prueba forman un único contrato
Nuestra pregunta guía pide el coste de servicio aprobado. El modelo no debe producir solo 120.00, sino también una caja, es decir, el rectángulo de la zona que contiene el valor solicitado.
Esta es una ilustración del formato esperado. Las coordenadas de este ejemplo se han elegido para explicarlo; no son una predicción medida del corpus.
{
  "answer": "120.00",
  "box": [600, 700, 800, 750]
}
answer es una cadena de caracteres, incluso para un importe. box contiene cuatro coordenadas en el orden izquierda, arriba, derecha, abajo. Se expresan en una escala de 0 a 1000, no directamente en píxeles.
Para un campo ausente, la segunda forma permitida es:
{
  "answer": null,
  "box": null
}
Esto es una abstención: el sistema no propone ni valor ni localización. Debe ser completa. Se rechazan un valor sin caja o una caja sin valor. Del mismo modo, la cadena "null" no es el valor JSON null: sería texto, no una ausencia.
¿Por qué conservar ambos elementos juntos? Porque queremos evitar dos atajos. Un importe exacto asociado al rectángulo incorrecto no permite comprobar la ocurrencia adecuada. A la inversa, un rectángulo bien situado no hace aceptable un importe erróneo.
En este artículo, «prueba localizada» designa la zona propuesta como justificación. No significa que el programa haya demostrado la verdad de la respuesta. El modelo también predice las coordenadas: pueden ser erróneas. El contrato hace controlable esta propuesta; la evaluación dirá si es correcta.
Qué adapta realmente LoRA
El modelo base es Qwen2-VL-2B-Instruct. Es un modelo de visión y lenguaje, o VLM: recibe información visual y textual para generar texto. Su ficha oficial presenta la variante empleada; conservamos la del proyecto, sin sustituirla por un modelo más reciente.
Su codificador visual transforma la imagen en representaciones numéricas. Su decodificador textual utiliza esas representaciones y la pregunta para producir sucesivamente los elementos de la respuesta. Un token es una unidad de texto que manipula el modelo: una palabra, un fragmento de palabra o un signo pueden ocupar tokens distintos.
El tokenizer convierte el texto en identificadores numéricos. El procesador también prepara las imágenes para el modelo. La documentación de Qwen2-VL en Transformers ilustra esta preparación multimodal. En este tutorial no tiene que escribir un codificador visual: usamos las capacidades del modelo preentrenado.
Los pesos son los parámetros numéricos aprendidos por la red. Un entrenamiento los ajusta a partir de ejemplos y respuestas esperadas. Adaptar un modelo ya entrenado a una tarea concreta se llama fine-tuning, o ajuste especializado.
LoRA, por Low-Rank Adaptation, permite realizar esa adaptación sin modificar todos los pesos. En nuestro proyecto, los pesos base permanecen congelados, por lo que no se pueden entrenar. Añadimos pequeñas matrices que aprenden una corrección en determinadas capas. Ese conjunto de parámetros adicionales forma el adaptador.
Piense en un componente existente cuyo tratamiento principal se conserva y al que se añade una corrección especializada. La analogía termina ahí: esta corrección no es una lista de condiciones escrita a mano, sino números aprendidos. La guía conceptual de LoRA de PEFT describe esta separación entre pesos congelados y matrices de adaptación.
¿Por qué esta elección? Ya disponemos de un modelo de visión y lenguaje y queremos estudiar una adaptación dirigida al contrato Orion. LoRA reduce el número de parámetros que se entrenan y permite identificar la adaptación guardada. El recorrido compara el modelo congelado con su versión adaptada; no compara LoRA con un fine-tuning completo. Por tanto, no concluiremos que LoRA sea siempre el mejor método.
El corpus Orion contiene 400 páginas. El conjunto de prueba incluye 240 preguntas independientes: 180 respondibles y 60 sobre campos ausentes. Las páginas y las preguntas no son la misma unidad: estas cifras no describen 240 PDF adicionales.
La preparación representa las páginas, construye los pares pregunta/respuesta y fija los rectángulos esperados. Estas respuestas de referencia, a veces llamadas gold, sirven para aprender y evaluar. La inferencia, es decir, la producción de predicciones, no carga las anotaciones. El programa debe trabajar con las entradas previstas, no releer la solución.
El comando inspect-batch permite examinar un lote: imagen, pregunta, objetivo JSON y caja. Es el momento de entender los ejemplos que pedimos al modelo aprender antes de iniciar el entrenamiento.
Ejemplo de prueba localizada
Volvamos a nuestra caja ilustrativa [600, 700, 800, 750]. En una imagen de 1000 × 1000 píxeles, corresponde a un rectángulo de 600 a 800 píxeles horizontalmente y de 700 a 750 píxeles verticalmente.
En la misma página representada en 2000 × 2000 píxeles, este rectángulo pasa a ser [1200, 1400, 1600, 1500] en píxeles. Sin embargo, su representación normalizada sigue siendo la misma. Para recuperar una abscisa se calcula x_pixels = x_normalisé × largeur / 1000; para una ordenada, se usa la altura.
Esta escala se parece a porcentajes, con 1000 como límite en lugar de 100. Permite señalar una misma zona relativa con distintas resoluciones, siempre que se conserve el mismo encuadre y orientación. Un recorte cambia el referente; aumentar la resolución tampoco hace automáticamente al modelo más preciso.
Una página puede contener «service cost» y «approved service cost». Un marco sobre el primer campo no justifica una respuesta sobre el segundo, aunque los importes coincidan. De ahí el interés de medir el solapamiento con la caja esperada.
La medida usada es el IoU, por Intersection over Union: el área común a ambos rectángulos dividida por el área total cubierta por uno u otro. Un valor de 1 significa que coinciden; 0, que no tienen superficie común. Haremos este cálculo a mano después del código de validación.
Programar LoRA y elegir los tokens que se aprenderán
Dos matrices pequeñas en lugar de una gran corrección libre
Una capa lineal transforma una lista de números en otra. Sus coeficientes se almacenan en una matriz W. Una matriz es una tabla bidimensional; un tensor es el término más general que PyTorch usa para las tablas numéricas.
LoRA conserva W y añade una corrección de la forma (alpha/r) × B × A. La matriz A transforma la entrada hacia una pequeña dimensión intermedia r; después B la transforma hacia la dimensión de salida. Se dice que la corrección es de rango bajo: su construcción limita el número de direcciones independientes que puede representar.
En el proyecto, r = 8 y alpha = 16, por lo que el factor multiplicativo vale 16/8 = 2. Este factor regula la amplitud de la corrección; no es la tasa de aprendizaje del optimizador.
Las capas objetivo son q_proj, k_proj, v_proj y o_proj en la atención del decodificador textual. Para situarlas sin detallar todo el Transformer: las proyecciones Q y K participan en el cálculo de afinidades entre posiciones, V aporta la información que se combinará y O transforma el resultado. El cálculo de atención documentado por PyTorch ilustra la combinación de Q, K y V. Los nombres designan capas de la red, no cuatro herramientas de lectura de PDF. El codificador visual permanece congelado.
Tomemos un ejemplo numérico independiente de las dimensiones reales de Qwen2-VL. Para una proyección de 1024 entradas a 1024 salidas, W contiene 1024 × 1024 = 1 048 576 coeficientes. Con rango 8, A contiene 8 × 1024 = 8192 coeficientes y B otros tantos: 16 384 parámetros de adaptación, 64 veces menos que los coeficientes de W, sin contar un posible sesgo.
Este cálculo se refiere a una proyección ilustrativa, no al número total de parámetros del modelo. La gran matriz sigue presente y se utiliza. Reducir los parámetros entrenables no significa dividir toda la memoria entre 64 ni eliminar el coste del modelo base.
Leer la capa LoRALinear
Esta es la clase usada en src/pdfvqa/lora.py. Las importaciones y el código que la inserta en el modelo los proporciona el proyecto completo.
class LoRALinear(nn.Module):
    def __init__(self, base, rank=8, alpha=16, dropout=0.05):
        super().__init__()
        if not isinstance(base, nn.Linear) or rank <= 0 or not 0 <= dropout < 1:
            raise ValueError("Invalid LoRA layer")
        self.base = base.requires_grad_(False)
        self.A = nn.Parameter(
            torch.empty(
                rank, base.in_features, device=base.weight.device, dtype=torch.float32
            )
        )
        self.B = nn.Parameter(
            torch.zeros(
                base.out_features, rank, device=base.weight.device, dtype=torch.float32
            )
        )
        nn.init.kaiming_uniform_(self.A, a=math.sqrt(5))
        self.scale = alpha / rank
        self.dropout = nn.Dropout(dropout)

    def forward(self, x):
        original = self.base(x)
        update = torch.nn.functional.linear(
            torch.nn.functional.linear(self.dropout(x.float()), self.A), self.B
        )
        return (original.float() + self.scale * update).to(original.dtype)
La primera parte conserva la capa original. requires_grad_(False) indica a PyTorch que no calcule gradientes para sus parámetros. Un gradiente sirve para determinar cómo ajustar un parámetro y reducir el error de aprendizaje. Los pesos congelados siguen participando en el cálculo; simplemente no se actualizan durante la adaptación.
La segunda parte crea los parámetros que se aprenderán. nn.Parameter registra A y B como parámetros del módulo. Sus dimensiones corresponden al recorrido «dimensión de entrada → rango → dimensión de salida». Se colocan en el mismo dispositivo que la capa original.
A recibe una inicialización aleatoria, mientras que B empieza en cero. Al principio, pasar por B da una corrección nula: el adaptador aún no modifica la salida de la capa. El entrenamiento aprenderá después esta corrección, en lugar de empezar perturbando arbitrariamente el modelo.
El método forward() calcula las dos ramas. self.base(x) produce la salida original. Las dos llamadas a linear() aplican sucesivamente A y B. La expresión de PyTorch corresponde a la convención descrita por torch.nn.functional.linear, donde el peso se almacena en el orden salida, entrada. Finalmente multiplicamos la corrección por self.scale y la sumamos a la salida original.
El dropout interviene solo en la rama de adaptación. Durante el aprendizaje, su valor 0.05 da a cada elemento una probabilidad del 5 % de ponerse a cero; el módulo redimensiona los elementos conservados. En modo de evaluación ya no modifica su entrada. Es el comportamiento documentado de nn.Dropout, no una eliminación definitiva de parámetros.
Por último, x.float(), las matrices en torch.float32 y original.float() hacen explícito el cálculo de la corrección y de la suma en FP32, formato de 32 bits. .to(original.dtype) devuelve el resultado al tipo de la salida inicial. No confunda esta gestión de formatos numéricos con el congelamiento de pesos: una se refiere a la representación de los números, la otra a los parámetros que se entrenan.
Aprender la respuesta, no copiar todo el contexto
Hemos definido lo que puede cambiar en el modelo. Ahora hay que definir en qué posiciones del texto calculamos el error.
Durante el entrenamiento, una secuencia contiene el contexto —incluida la pregunta y los elementos asociados a la imagen— y después la respuesta esperada del asistente. La función de pérdida, o loss, mide la diferencia entre predicciones y tokens que aprender. Queremos entrenar la respuesta JSON, no pedir al modelo que copie la pregunta ni las posiciones de relleno.
El padding, o relleno, añade posiciones para organizar secuencias de distinta longitud en tablas. Estas posiciones no son contenido que predecir. Por ello, el código utiliza el valor especial -100 en las etiquetas de aprendizaje, los labels, para las posiciones que la pérdida ignora.
def assistant_labels(input_ids, attention_mask, prompt_length, forbidden_ids):
    if (
        input_ids.ndim != 1
        or attention_mask.shape != input_ids.shape
        or not 0 < prompt_length < len(input_ids)
    ):
        raise ValueError("Invalid completion boundary")
    labels = input_ids.clone()
    labels[:prompt_length] = -100
    labels[~attention_mask.bool()] = -100
    for identifier in forbidden_ids:
        labels[input_ids == identifier] = -100
    if (labels != -100).sum() == 0:
        raise ValueError("No assistant target token")
    if (labels[:prompt_length] != -100).any():
        raise ValueError("Prompt included in loss")
    return labels
El control inicial espera una secuencia unidimensional, un attention_mask de la misma forma y un límite prompt_length después del inicio pero antes del final. Este límite separa el contexto de la respuesta.
clone() copia los identificadores para construir las etiquetas sin modificar la entrada. Las tres operaciones siguientes marcan con -100 el prefijo del prompt, las posiciones cuyo máscara de atención vale cero y los identificadores de forbidden_ids. Si no queda ningún objetivo, la función rechaza el ejemplo en lugar de iniciar un aprendizaje sin respuesta que aprender. El último control verifica que el prompt quede excluido.
Tomemos un ejemplo pedagógico de identificadores, sin relación con el vocabulario real del tokenizer. La entrada es [101, 501, 502, 601, 602, 603, 0], el prefijo ocupa las tres primeras posiciones, la última es padding y 603 pertenece a los identificadores prohibidos. Las etiquetas pasan a ser [-100, -100, -100, 601, 602, -100, -100].
Solo los objetivos 601 y 602 contribuyen directamente a la pérdida. Sin embargo, el contexto no se ha retirado de la entrada. El modelo puede seguir utilizándolo para producir la respuesta. Enmascarar un objetivo de aprendizaje no equivale a borrar la pregunta o la imagen.
Por tanto, el valor -100 no es ni un token que deba generar el modelo ni un sinónimo de JSON null. Solo significa «ignorar esta posición para la pérdida», según el mecanismo ignore_index documentado por PyTorch.
La pérdida desplaza después los objetivos: la predicción de una posición aprende el token siguiente. Ese desplazamiento no se realiza en assistant_labels(). La función presentada construye la máscara; el cálculo de pérdida la usa después. Así se aprenden en la respuesta JSON los valores y las coordenadas mediante su representación en tokens.
En resumen: LoRA elige qué parámetros cambian; la máscara elige qué objetivos contribuyen al aprendizaje; el validador comprobará la forma de la salida producida. Estos tres mecanismos cumplen funciones distintas.
Validar la respuesta generada
Después de la inferencia, recibimos texto sin procesar. Puede estar incompleto, mal formado o contener coordenadas imposibles. Lo comprobamos antes de considerarlo una respuesta que el programa pueda utilizar.
El siguiente fragmento procede de src/pdfvqa/validate_answer.py. No consulta la respuesta esperada para arreglar la predicción.
"""Validate raw model output, without repairing it from the expected answer."""

import json


def validate_answer(raw, terminated=True):
    if not terminated:
        return {"valid": False, "error": "length", "value": None}
    try:
        value = json.loads(raw)
    except (ValueError, TypeError):
        return {"valid": False, "error": "json", "value": None}
    if not isinstance(value, dict) or set(value) != {"answer", "box"}:
        return {"valid": False, "error": "schema", "value": None}
    answer, box = value["answer"], value["box"]
    if answer is None and box is None:
        return {"valid": True, "error": None, "value": value}
    if answer is None or box is None:
        return {"valid": False, "error": "asymmetric_null", "value": None}
    if not isinstance(answer, str) or not answer.strip():
        return {"valid": False, "error": "answer", "value": None}
    if (
        not isinstance(box, list)
        or len(box) != 4
        or any(type(x) is not int for x in box)
    ):
        return {"valid": False, "error": "box_type", "value": None}
    if not 0 <= box[0] < box[2] <= 1000 or not 0 <= box[1] < box[3] <= 1000:
        return {"valid": False, "error": "box_bounds", "value": None}
    return {"valid": True, "error": None, "value": value}


def iou(a, b):
    intersection = max(0, min(a[2], b[2]) - max(a[0], b[0])) * max(
        0, min(a[3], b[3]) - max(a[1], b[1])
    )
    union = (a[2] - a[0]) * (a[3] - a[1]) + (b[2] - b[0]) * (b[3] - b[1]) - intersection
    return intersection / union if union > 0 else 0.0
Del texto sin procesar a un objeto aceptado o rechazado
terminated indica si la generación terminó correctamente. Cuando vale False, la función devuelve el error length, aunque el comienzo de la salida parezca utilizable. La persona que llama debe transmitir este estado: el validador no puede adivinar, a partir de la sola cadena, cómo se detuvo el modelo.
json.loads() decodifica después el texto. Un fallo produce json. Tras la decodificación, el programa exige un diccionario que contenga exactamente answer y box: una clave ausente o adicional produce schema.
A continuación se controla el par. Dos valores None, procedentes de los dos null de JSON, constituyen una abstención válida. Un solo valor nulo produce asymmetric_null: la abstención está incompleta. Si no, answer debe ser una cadena no vacía después de comprobar los espacios.
La caja debe ser una lista de cuatro enteros y respetar después 0 ≤ izquierda < derecha ≤ 1000 y 0 ≤ arriba < abajo ≤ 1000. Las desigualdades estrictas prohíben una anchura o altura nula. La comprobación type(x) is not int rechaza en particular un booleano en lugar de una coordenada. Los errores distinguen un tipo incorrecto (box_type) de una geometría fuera del contrato (box_bounds).
La función utiliza answer.strip() para detectar una cadena vacía, pero devuelve el objeto original: no limpia sistemáticamente la respuesta. Tampoco convierte un importe, comprueba una divisa ni sustituye unas coordenadas fuera de página por su valor límite.
valid=True significa, por tanto, «conforme al contrato controlado aquí», no «correcto en el documento». Un importe erróneo acompañado de un rectángulo bien formado puede pasar. Del mismo modo, una abstención puede ser estructuralmente válida aunque la página contenga la respuesta. Corresponde a la evaluación de exactitud distinguir estos casos.
Calcular el IoU con un pequeño desplazamiento
La función iou() calcula primero la anchura y la altura de la intersección. Los max(0, ...) evitan crear un área negativa cuando los rectángulos no se tocan. La unión es la suma de ambas áreas menos su intersección, para no contar dos veces la zona común.
Tomemos un ejemplo numérico ilustrativo, no una medición de Orion. La caja de referencia es [600, 700, 800, 750]. La predicción se desplaza 100 unidades a la derecha: [700, 700, 900, 750].
Cada rectángulo tiene un área de 200 × 50 = 10 000. Su intersección ya solo mide 100 × 50 = 5000. La unión vale 10 000 + 10 000 − 5000 = 15 000. Por tanto, el IoU es 5000 / 15 000 = 1/3, es decir, aproximadamente 0,3333.
El texto podría haber seguido siendo exactamente 120.00 en ambas respuestas. La disminución del IoU no mide un cambio del texto: mide el deterioro de la localización. El ejercicio final provocará precisamente esta separación en las salidas del proyecto.
La función iou() presupone cajas utilizables para este cálculo; no sustituye a validate_answer(). En cuanto a las coordenadas predichas, nunca se corrigen después de la generación con ayuda del gold. De otro modo, mediríamos una respuesta asistida por la solución y no la predicción del modelo.
Requisitos previos y comandos
Debe saber leer Python, usar un terminal y ejecutar Docker. Los fragmentos anteriores explican los mecanismos; el ZIP proporciona el proyecto completo necesario para ejecutarlos.
El perfil de referencia utiliza Linux, Docker Engine, Compose, un controlador NVIDIA y NVIDIA Container Toolkit, en una RTX 3090 de 24 GiB compatible con BF16. El recorrido recomienda 48 GiB de RAM y 55 GiB de disco. Son recomendaciones de preparación; el perfil de CPU no está validado.
La VRAM es la memoria de la tarjeta gráfica, distinta de la RAM de la máquina. BF16 designa un formato numérico de 16 bits, entre los tipos numéricos de PyTorch. Su presencia en el perfil no significa que todos los cálculos usen este formato: acabamos de ver la corrección LoRA preparada explícitamente en FP32.
El controlador permite el cálculo con GPU en el host. NVIDIA Container Toolkit proporciona la integración con Docker. Ver la tarjeta con nvidia-smi confirma que es visible en Linux, pero aún no que el modelo funcione en el contenedor. check_environment.py realiza esta segunda comprobación. La documentación oficial de NVIDIA explica la instalación adaptada al sistema; las comprobaciones del proyecto no lo modifican silenciosamente.
Descomprima el ZIP y sitúe el terminal en su carpeta raíz. Todos los comandos siguientes parten de esta raíz y se ejecutan en orden. El servicio acquisition recupera los activos del modelo, tutorial prepara los datos, entrena y evalúa, mientras que inference produce las predicciones sin consultar las etiquetas.
Paso 1 — preparar
Comprobamos el entorno, preparamos el proyecto, construimos los servicios y adquirimos los archivos esperados antes de ejecutar las pruebas.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
Cada comando debe terminar con un código de salida cero, es decir, sin error señalado. Estas comprobaciones tienen objetivos distintos: Compose verifica la configuración, el build construye las imágenes, la adquisición bloqueada recupera los activos previstos, y después el control del entorno ejecuta el modelo en Docker. Por último, las pruebas verifican comportamientos del programa.
Un build correcto no sustituye ni la comprobación de la GPU ni las pruebas. Y unas pruebas correctas no significan que todas las respuestas del modelo vayan a ser correctas: esa medición viene después.
Paso 2 — construir la predicción
Preparemos las páginas y sus preguntas, observemos un lote y produzcamos una primera referencia sin adaptación.
docker compose run --rm tutorial python -m pdfvqa.cli prepare --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfvqa.cli inspect-batch --config configs/minimum.yaml
docker compose run --rm inference python -m pdfvqa.cli baseline --config configs/minimum.yaml
prepare construye las entradas y los objetivos. inspect-batch permite inspeccionar lo que recibe el modelo y lo que se le pide que produzca. Para la pregunta hilo conductor, localice el coste aprobado y compruebe que el objetivo designa realmente ese campo y no el otro coste.
baseline significa referencia de comparación. Aquí utiliza el modelo congelado, sin la adaptación Orion, pero con el mismo contrato de salida. Esta etapa responde a una pregunta esencial: ¿qué sabe hacer ya el modelo antes de nuestro entrenamiento?
Abra las salidas intermedias. La inspección sirve para comprender los datos y los errores, no para reescribir una respuesta de referencia de modo que coincida con una predicción.
Paso 3 — medir y controlar
Ahora podemos entrenar el adaptador, controlar una reanudación tras una interrupción y, a continuación, producir y evaluar las respuestas adaptadas.
docker compose run --rm tutorial python -m pdfvqa.cli train --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfvqa.cli train-continuous --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfvqa.cli train-resume --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfvqa.cli verify-resume --config configs/minimum.yaml
docker compose run --rm inference python -m pdfvqa.cli predict --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfvqa.cli evaluate --config configs/minimum.yaml
train aprende los parámetros LoRA y guarda un checkpoint, un estado que permite conservar el trabajo realizado. Los comandos train-continuous y train-resume comparan una ejecución continua con una ejecución reanudada. verify-resume comprueba que la interrupción no haya cambiado el experimento.
Reanudar correctamente requiere más que recargar algunas matrices. El optimizador, que dirige sus actualizaciones, también tiene un estado; los generadores aleatorios deben restaurarse. El resultado de referencia r001 indica una reanudación EXACT. Describe el control de este recorrido, no promete una identidad numérica en cualquier material o tras modificar las dependencias.
Después, predict ejecuta el modelo adaptado en el servicio de inferencia. evaluate reúne las predicciones y las anotaciones para calcular las medidas. Por tanto, las etiquetas sirven para puntuar después de la predicción, no para ayudar al modelo cuando responde.
Medidas antes de las cifras
Leer las métricas en el orden correcto
Comencemos por la validez de JSON y del contrato. El nombre puede hacer pensar en la simple decodificación de JSON, pero el control presentado va más allá: claves exactas, tipos, pareja respuesta/caja y coordenadas. Un rechazo debe seguir siendo visible; no hay que guardar solo los fragmentos que dan una impresión de éxito.
La exactitud de respuesta compara el texto con la referencia tras la regla de normalización prevista por el proyecto. No es una valoración libre del sentido. No sustituya esta regla por una conversión de importe o una reformulación elegida después de ver los resultados.
El IoU mide el solapamiento de las cajas para las preguntas respondibles. No se aplica a los campos ausentes: no existe un rectángulo esperado que comparar con una abstención.
La exactitud conjunta exige que los controles de respuesta, esquema y localización se cumplan a la vez. Por tanto, un valor correcto no compensa una caja incorrecta. El umbral numérico de aceptación de la localización no se detalla en esta presentación: conserve la regla del evaluador del ZIP, sin deducirla de la media de IoU ni sustituirla por un umbral arbitrario.
Por último, la precisión de abstención responde a «entre las abstenciones emitidas, ¿cuántas se refieren realmente a campos ausentes?». El recall de abstención responde a «entre los campos ausentes, ¿cuántos condujeron efectivamente a una abstención?».
Ejemplo pedagógico: de diez campos ausentes, un sistema se abstiene correctamente ocho veces, pero también se abstiene una vez cuando la respuesta está presente. Su recall vale 8/10 = 0,8; su precisión vale 8/9, es decir, aproximadamente 0,8889. Las dos medidas no describen el mismo error. Este ejemplo no es el resultado del modelo Orion.
Un sistema que siempre responde puede olvidar las ausencias; un sistema que siempre se abstiene puede perder todos los valores presentes. Por eso conservamos ambas poblaciones y varias medidas.
Interpretar las salidas paso a paso
Después de predict, busque la respuesta JSON sin procesar, su estado de validación, la caja y la superposición, también llamada overlay. Es el rectángulo dibujado sobre la imagen para facilitar su inspección, no una validación adicional del modelo.
Para una salida aceptada, compare el texto, el campo solicitado y la zona enmarcada. Para una salida rechazada, conserve el error: json, schema, box_bounds u otro motivo. Transformar un resultado inválido en una frase verosímil haría perder el diagnóstico.
Estos son los resultados de referencia r001, sobre las 240 preguntas de prueba del corpus sintético Orion:
En móvil, desplácese horizontalmente por la tabla.
| Medida LoRA | Población afectada | Resultado observado |
|---|---|---|
| Exactitud de respuesta | 240 preguntas | 1,0000 |
| Validez de JSON y del contrato | 240 preguntas | 1,0000 |
| Exactitud conjunta | 240 preguntas | 1,0000 |
| IoU medio | 180 preguntas respondibles | 0,9857 |
| Precisión de abstención | Abstenciones en la prueba | 1,0000 |
| Recall de abstención | 60 campos ausentes | 1,0000 |
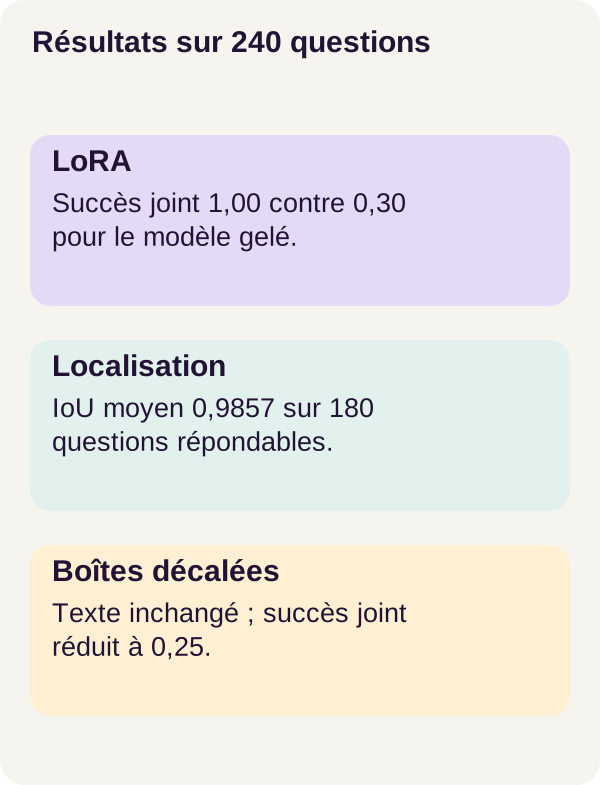
El modelo congelado alcanza 0,3000 de exactitud conjunta, frente a 1,0000 después de la adaptación LoRA. En las 240 preguntas, esto corresponde a 72 aciertos conjuntos frente a 240, según el criterio de este recorrido.
¿Cómo leer el contraste entre una exactitud conjunta perfecta y un IoU de 0,9857? Todas las respuestas pasan el criterio de localización del evaluador, pero no todos los rectángulos coinciden exactamente con su referencia. Superar el criterio no equivale a una igualdad perfecta de coordenadas.
Los resultados muestran aquí una ganancia de la adaptación frente al modelo congelado. No predicen el rendimiento con escritura manuscrita, escaneos degradados o etiquetas de clientes diferentes. Tampoco demuestran superioridad frente a métodos que este recorrido no compara.
Solución de problemas y paso a un producto
¿El modelo no se puede utilizar en Docker? Vuelva a la comprobación del entorno, al acceso a la GPU y a la integración de NVIDIA. Un problema de ejecución no se diagnostica a partir de una métrica de respuesta.
¿El JSON se rechaza? Inspeccione el prompt, los límites de generación y la versión del modelo. Una respuesta detenida demasiado pronto puede estar incompleta. Una caja fuera de página sigue siendo inválida: no la recorte para hacerla pasar el control ni recupere el valor de la referencia.
¿El texto es exacto pero la caja está mal situada? Muestre esta salida como insuficientemente justificada. La interfaz puede ayudar a ver el error; no debe ocultarlo bajo una puntuación global.
Para un producto, cada propuesta debería seguir vinculada a un PDF inmutable, a una página, a una zona, a una versión del modelo y a un registro de decisión. Son elementos que hay que prever alrededor del tutorial, no nuevos campos que añadir silenciosamente al contrato JSON probado.
Lo que hemos aprendido
LoRA aprende una corrección de bajo rango en proyecciones específicas, sin modificar los pesos base. La máscara de aprendizaje conserva el contexto en las entradas, pero limita los objetivos sobre los que se calcula la pérdida.
Una vez producida la respuesta, Python comprueba su contrato. Después, la evaluación verifica otra cosa: el texto correcto, la zona correcta y la decisión correcta de responder o abstenerse. Ninguna de estas dimensiones sustituye a las demás.
En Orion, la adaptación mejora claramente la exactitud conjunta frente al modelo congelado. Para comprender por qué una respuesta textualmente exacta sigue siendo insuficiente, vamos a desplazar ahora únicamente su justificación visual.
Ejercicio — desplazar la prueba sin cambiar el texto
Antes de ejecutar el ejercicio, escriba su hipótesis. ¿Qué ocurre con la exactitud textual, el IoU y la exactitud conjunta si cada caja se desplaza horizontalmente 100 unidades normalizadas, sin cambiar las respuestas? ¿Qué debe ocurrir con las abstenciones, que no tienen caja?
Piense en el pequeño cálculo anterior: dos rectángulos pueden permanecer en la página y, aun así, solaparse mucho menos. «Coordenadas permitidas» y «buena localización» no son sinónimos.
Ejecute después el experimento proporcionado, sin modificar el código validado:
docker compose run --rm tutorial python -m pdfvqa.cli exercise --config configs/exercise.yaml
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
El primer comando realiza el ejercicio. El siguiente produce las figuras y el último controla los checkpoints esperados. Compare las salidas con su predicción antes de conformarse con la puntuación final.
Resultado observado: los 240 textos siguen siendo idénticos y la exactitud textual vale 1. El IoU medio baja a 0,1692 y la exactitud conjunta a 0,25. Las 60 abstenciones siguen siendo correctas y ninguna caja está fuera de los límites.
El 0,25 resulta especialmente revelador: las 60 abstenciones representan 60/240 = 0,25 de la prueba. Bastan para explicar todos los aciertos conjuntos restantes. El texto no ha cambiado; es la localización de las respuestas presentes la que ya no supera el control conjunto.
No hay contradicción con el validador. Un rectángulo desplazado puede conservar cuatro enteros, una anchura positiva y coordenadas entre 0 y 1000. Sigue estando bien formado aunque muestre la zona equivocada.
Esta perturbación de las salidas es distinta de las dos páginas adicionales del ejercicio, en las que un campo ha cambiado realmente de posición. En un caso desplazamos una caja después de la predicción; en el otro cambiamos el documento que el modelo debe leer. No presente las cifras del primer experimento como la medida del segundo.
Elegir una acción después de la evaluación
Una respuesta insuficientemente justificada debe presentarse a una persona operadora con el PDF y su superposición, no enviarse automáticamente a un sistema contable. Una abstención no debe sustituirse por el valor aproximado que parezca más cercano.
Sin embargo, hay que distinguir una métrica de evaluación de un control disponible en producción. La exactitud conjunta y el IoU con el gold requieren una anotación conocida. En un PDF nuevo sin referencia, el programa no dispone de repente de estas puntuaciones para decidir por sí solo. Por tanto, las reglas de rechazo, los controles de negocio y la revisión humana deben diseñarse y evaluarse por separado.
Del mismo modo, el contrato probado expresa la abstención mediante dos valores nulos; no contiene un campo que explique su motivo. Conservar un motivo verificado en un registro o una interfaz es trabajo de integración adicional, no información que deba inventarse a partir de null.
Para adaptar el experimento a sus formularios, separe los datos por familia y modelo de documento. Mantenga la prueba aparte antes de las iteraciones y mida por separado respuesta, esquema, localización y abstención. El objetivo no es solo obtener una cifra mejor, sino saber qué errores puede ocultar.
Salidas esperadas y errores útiles
Después de prepare, localice las páginas, las preguntas y los objetivos separados. Después de baseline, conserve las salidas del modelo congelado para comparar los mismos casos. Después de predict, examine valid, error y luego answer y box en la respuesta estructurada cuando esté disponible. En el fragmento de validación, esta respuesta se guarda en value, que vale None en caso de rechazo.
evaluate precisa las poblaciones y distingue prueba y ejercicio. Esta distinción evita mezclar preguntas nuevas con una perturbación artificial de predicciones existentes.
Un resultado asymmetric_null señala una respuesta sin caja, o una caja sin respuesta. box_type señala un problema de representación; box_bounds, un problema de límites o de orden de las coordenadas. Estos errores son salidas útiles del programa. Hacerlos desaparecer sin comprender su causa volvería el sistema menos observable, no más exacto.
Producción, límites y limpieza
El tutorial ofrece un experimento con formularios ficticios. Para pasar a documentos reales, reúna ejemplos autorizados y representativos, con respuestas y zonas verificadas. Las variaciones de etiquetas, calidad de imagen y diseño deben evaluarse en vez de suponerse cubiertas.
Conserve la versión del modelo, el documento, la página, las zonas, las unidades y las reglas de rechazo. Añada derechos de acceso, supervisión y revisión humana para costes o decisiones contractuales. Una ausencia, una unidad ambigua o una caja inválida nunca deben transformarse en certeza solo mediante la presentación de la interfaz.
Antes de la limpieza, guarde las exportaciones útiles. El siguiente script solo se dirige a outputs/:
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
El primer docker compose down detiene los servicios del proyecto. El contenedor iniciado después ejecuta la limpieza específica y el último cierre termina el recorrido. Estos comandos no requieren una purga global de Docker.
Para profundizar en el método, la documentación oficial de PEFT y LoRA presenta los adaptadores sobre modelos preentrenados. El artículo fundador de LoRA detalla la idea de una corrección de bajo rango. Estas referencias complementan la explicación; la implementación presentada aquí sigue siendo la clase LoRALinear del ZIP, no una reescritura con otra biblioteca.
Las documentaciones enlazadas en este artículo sirven para comprender los mecanismos. Para reproducir r001, conserve los comandos, la configuración y las dependencias del proyecto proporcionado: un ejemplo de documentación no es una invitación a modificar el entorno de referencia.
Lo que hemos aprendido: un valor se vuelve controlable cuando sigue vinculado a su página, a una zona y a reglas de validación explícitas. El último paso no es creer en el marco mostrado, sino comprobar lo que muestra.