





State sviluppando una schermata gestionale che deve recuperare un importo da un PDF. L’assistente risponde 120.00. Benissimo… ma da dove viene questo numero? Dal costo stimato, dal costo approvato o da un’altra riga del documento? Prima di compilare il modulo, vorreste poter fare clic sulla risposta e vedere l’area che la giustifica.
È il punto di partenza di questo tutorial. Seguiremo il modulo fittizio Orion Service Record, che contiene una data, due numeri di serie e un costo approvato. Il nostro programma dovrà rispondere a una domanda sulla pagina, indicare dove si trova il valore e astenersi quando il campo richiesto è assente.
Adatteremo con LoRA un modello capace di trattare immagini e testo, quindi ne controlleremo gli output in Python. Non serve conoscere già questa tecnica: vedremo cosa modifica, come apprende e, soprattutto, come verificarne il risultato.
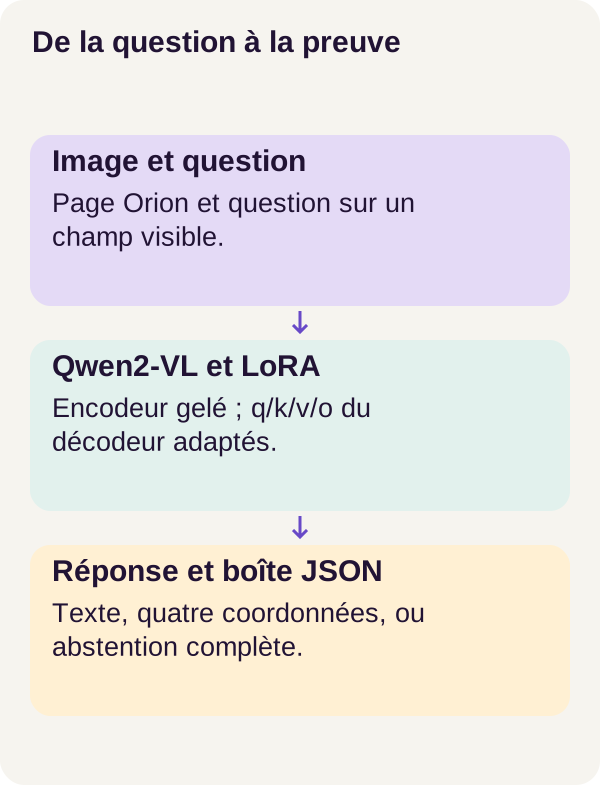
Il percorso segue immagine della pagina → domanda → modello adattato → risposta e rettangolo → validazione → valutazione. Una risposta e un bel riquadro non bastano: misureremo separatamente il testo, la localizzazione e l’astensione.
Il problema concreto
Leggere una pagina e rispondere a una domanda sono due attività diverse. Un sistema può riconoscere più importi senza sapere quale corrisponde a « approved service cost ». Può anche fornire l’importo giusto indicando però l’occorrenza sbagliata.
Qui lavoriamo con la VQA, per Visual Question Answering: rispondere a una domanda a partire da un’immagine. Il PDF viene reso come immagine di pagina, poi l’immagine accompagna la domanda. Il risultato atteso non è un riassunto libero del documento, ma un dato strutturato che il programma può accettare o rifiutare.
Per uno sviluppatore web, il parallelo è semplice: come con un’API, definiamo un contratto di output. Ma un JSON conforme non garantisce che il dato sia vero. Dovremo anche confrontare la previsione con le annotazioni di riferimento, poi esaminare l’area indicata sulla pagina.
Il corpus è sintetico: i suoi moduli sono generati per un’esperienza controllata. Questo permette di conoscere le risposte attese e provocare alcuni errori. Non convalida automaticamente il trattamento dei vostri PDF dei clienti.
Concetti prima del codice
Una risposta e una prova formano un unico contratto
La nostra domanda guida chiede il costo di servizio approvato. Il modello non deve produrre soltanto 120.00, ma anche una box, cioè il rettangolo dell’area che contiene il valore richiesto.
Ecco un’illustrazione del formato atteso. Le coordinate di questo esempio sono scelte a fini esplicativi; non è una previsione misurata sul corpus.
{
  "answer": "120.00",
  "box": [600, 700, 800, 750]
}
answer è una stringa di caratteri, anche per un importo. box contiene quattro coordinate nell’ordine sinistra, alto, destra, basso. Sono espresse su una scala da 0 a 1000, non direttamente in pixel.
Per un campo assente, la seconda forma autorizzata è:
{
  "answer": null,
  "box": null
}
Si tratta di un’astensione: il sistema non propone né valore né localizzazione. Deve essere completa. Un valore senza box o una box senza valore viene rifiutato. Allo stesso modo, la stringa "null" non è il valore JSON null: sarebbe testo, non un’assenza.
Perché mantenere insieme i due elementi? Perché vogliamo evitare due scorciatoie. Un importo esatto associato al rettangolo sbagliato non permette di verificare l’occorrenza corretta. Al contrario, un rettangolo ben posizionato non rende accettabile un importo errato.
In questo articolo, « prova localizzata » indica l’area proposta come giustificazione. Non significa che il programma abbia dimostrato la verità della risposta. Anche le coordinate sono previste dal modello: possono essere errate. Il contratto rende questa proposta controllabile; la valutazione dirà se è corretta.
Che cosa adatta davvero LoRA
Il modello di base è Qwen2-VL-2B-Instruct. È un modello visione-linguaggio, o VLM: riceve informazioni visive e testuali per generare testo. La sua scheda ufficiale presenta la variante utilizzata; manteniamo quella del progetto, senza sostituirla con un modello più recente.
Il suo encoder visivo trasforma l’immagine in rappresentazioni numeriche. Il suo decoder testuale usa queste rappresentazioni e la domanda per produrre in successione gli elementi della risposta. Un token è un’unità di testo manipolata dal modello: una parola, una parte di parola o un segno possono occupare token diversi.
Il tokenizer converte il testo in identificatori numerici. Il processore prepara anche le immagini per il modello. La documentazione Transformers su Qwen2-VL illustra questa preparazione multimodale. In questo tutorial non dovete scrivere un encoder visivo: usiamo le capacità del modello preaddestrato.
I pesi sono i parametri numerici appresi dalla rete. Un addestramento li regola a partire da esempi e risposte attese. Adattare un modello già addestrato a un compito specifico si chiama fine-tuning, o adattamento specializzato.
LoRA, per Low-Rank Adaptation, è un modo per realizzare questo adattamento senza modificare tutti i pesi. Nel nostro progetto, i pesi di base restano congelati, quindi non addestrabili. Aggiungiamo piccole matrici che apprendono una correzione in alcuni livelli. Questo insieme di parametri aggiuntivi forma l’adattatore.
Pensate a un componente esistente di cui si conserva l’elaborazione principale e al quale si aggiunge una correzione specializzata. L’analogia finisce qui: questa correzione non è una lista di condizioni scritte a mano, ma numeri appresi. La guida concettuale LoRA di PEFT descrive questa separazione tra pesi congelati e matrici di adattamento.
Perché questa scelta qui? Disponiamo già di un modello visione-linguaggio e vogliamo studiare un adattamento mirato al contratto Orion. LoRA riduce il numero di parametri da addestrare e permette di identificare l’adattamento registrato. Il percorso confronta il modello congelato con la sua versione adattata; non confronta LoRA con un fine-tuning completo. Non concluderemo quindi che LoRA sia sempre il metodo migliore.
Il corpus Orion comprende 400 pagine. Il set di test contiene 240 domande separate: 180 con risposta possibile e 60 su campi assenti. Pagine e domande non sono la stessa unità: questi numeri non descrivono 240 PDF aggiuntivi.
La preparazione rende le pagine, costruisce le coppie domanda/risposta e fissa i rettangoli attesi. Queste risposte di riferimento, talvolta dette gold, servono per apprendere e valutare. L’inferenza, cioè la produzione delle previsioni, non carica le annotazioni. Il programma deve lavorare con gli input previsti, non rileggere la soluzione.
Il comando inspect-batch permetterà di esaminare un lotto: immagine, domanda, target JSON e box. È il momento giusto per comprendere gli esempi che chiediamo al modello di apprendere, prima di avviare l’addestramento.
Esempio di prova localizzata
Torniamo alla nostra box illustrativa [600, 700, 800, 750]. Su un’immagine di 1000 × 1000 pixel, corrisponde a un rettangolo che va da 600 a 800 pixel orizzontalmente e da 700 a 750 pixel verticalmente.
Sulla stessa pagina resa in 2000 × 2000 pixel, questo rettangolo diventa [1200, 1400, 1600, 1500] in pixel. Eppure, la sua rappresentazione normalizzata resta identica. Per ritrovare un’ascissa si calcola x_pixels = x_normalisé × largeur / 1000; per un’ordinata si usa l’altezza.
Questa scala assomiglia alle percentuali, con 1000 come limite invece di 100. Permette di indicare la stessa area relativa a risoluzioni diverse, a condizione di mantenere lo stesso inquadramento e lo stesso orientamento. Un ritaglio cambia il riferimento; aumentare la risoluzione non rende automaticamente il modello più preciso.
Una pagina può contenere « service cost » e « approved service cost ». Un riquadro sul primo campo non giustifica una risposta sul secondo, anche se gli importi coincidono. Da qui l’interesse di misurare la sovrapposizione con la box attesa.
La misura utilizzata è l’IoU, per Intersection over Union: l’area comune ai due rettangoli, divisa per l’area totale coperta dall’uno o dall’altro. Un valore di 1 significa che coincidono; 0 significa che non hanno alcuna superficie in comune. Faremo questo calcolo a mano dopo il codice di validazione.
Programmare LoRA e scegliere i token da apprendere
Due piccole matrici anziché una grande correzione libera
Un livello lineare trasforma una lista di numeri in un’altra lista di numeri. I suoi coefficienti sono raccolti in una matrice W. Una matrice è una tabella a due dimensioni; un tensore è il termine più generale usato da PyTorch per le tabelle numeriche.
LoRA conserva W e aggiunge una correzione della forma (alpha/r) × B × A. La matrice A trasforma l’input verso una piccola dimensione intermedia r; B lo trasforma poi verso la dimensione di output. Si dice che la correzione è a rango basso: la sua costruzione limita il numero di direzioni indipendenti che può rappresentare.
Nel progetto, r = 8 e alpha = 16, quindi il fattore moltiplicativo vale 16/8 = 2. Questo fattore regola l’ampiezza della correzione; non è il tasso di apprendimento dell’ottimizzatore.
I livelli mirati sono q_proj, k_proj, v_proj e o_proj nell’attenzione del decoder testuale. Per collocarli senza descrivere l’intero Transformer: le proiezioni Q e K partecipano al calcolo delle relazioni tra posizioni, V fornisce le informazioni da combinare e O trasforma il risultato della combinazione. Il calcolo dell’attenzione documentato da PyTorch illustra la combinazione di Q, K e V. I nomi indicano livelli della rete, non quattro strumenti per leggere PDF. L’encoder visivo resta congelato.
Prendiamo un esempio numerico indipendente dalle dimensioni reali di Qwen2-VL. Per una proiezione da 1024 input a 1024 output, W contiene 1024 × 1024 = 1 048 576 coefficienti. Con un rango di 8, A contiene 8 × 1024 = 8192 coefficienti e B altrettanti: 16 384 parametri di adattamento, cioè 64 volte meno dei coefficienti di W, senza contare un eventuale bias.
Questo calcolo riguarda una proiezione illustrativa, non il numero totale di parametri del modello. La grande matrice resta presente e usata. Ridurre i parametri addestrabili non significa quindi dividere tutta la memoria per 64, né eliminare il costo del modello di base.
Leggere il livello LoRALinear
Ecco la classe usata in src/pdfvqa/lora.py. Gli import e il codice che la inserisce nel modello sono forniti dal progetto completo.
class LoRALinear(nn.Module):
    def __init__(self, base, rank=8, alpha=16, dropout=0.05):
        super().__init__()
        if not isinstance(base, nn.Linear) or rank <= 0 or not 0 <= dropout < 1:
            raise ValueError("Invalid LoRA layer")
        self.base = base.requires_grad_(False)
        self.A = nn.Parameter(
            torch.empty(
                rank, base.in_features, device=base.weight.device, dtype=torch.float32
            )
        )
        self.B = nn.Parameter(
            torch.zeros(
                base.out_features, rank, device=base.weight.device, dtype=torch.float32
            )
        )
        nn.init.kaiming_uniform_(self.A, a=math.sqrt(5))
        self.scale = alpha / rank
        self.dropout = nn.Dropout(dropout)

    def forward(self, x):
        original = self.base(x)
        update = torch.nn.functional.linear(
            torch.nn.functional.linear(self.dropout(x.float()), self.A), self.B
        )
        return (original.float() + self.scale * update).to(original.dtype)
La prima parte conserva il livello originale. requires_grad_(False) indica a PyTorch di non calcolare gradienti per i suoi parametri. Un gradiente serve a determinare come regolare un parametro per ridurre l’errore di apprendimento. I pesi congelati partecipano comunque al calcolo; semplicemente non vengono aggiornati dall’adattamento.
La seconda parte crea i parametri da apprendere. nn.Parameter registra A e B come parametri del modulo. Le loro dimensioni corrispondono al percorso « dimensione di input → rango → dimensione di output ». Sono collocati sullo stesso dispositivo del livello originale.
A riceve un’inizializzazione casuale, mentre B inizia da zero. All’inizio, il passaggio per B produce quindi una correzione nulla: l’adattatore non modifica ancora l’output del livello. L’addestramento apprenderà poi questa correzione, invece di iniziare perturbando arbitrariamente il modello.
Il metodo forward() calcola i due rami. self.base(x) produce l’output originale. Le due chiamate a linear() applicano successivamente A e B. L’espressione PyTorch corrisponde alla convenzione descritta da torch.nn.functional.linear, dove il peso è memorizzato nell’ordine output, input. Infine si moltiplica la correzione per self.scale, poi la si aggiunge all’output originale.
Il dropout interviene solo nel ramo di adattamento. Durante l’apprendimento, il suo valore 0.05 dà a ogni elemento una probabilità del 5 % di essere azzerato; gli elementi mantenuti vengono ridimensionati dal modulo. In modalità valutazione, non modifica più l’input. È il comportamento documentato di nn.Dropout, non una rimozione definitiva di parametri.
Infine, x.float(), le matrici in torch.float32 e original.float() rendono esplicito il calcolo della correzione e della somma in FP32, un formato a 32 bit. .to(original.dtype) riporta il risultato al tipo dell’output iniziale. Non confondete questa gestione dei formati numerici con il congelamento dei pesi: una riguarda la rappresentazione dei numeri, l’altra i parametri che si addestrano.
Apprendere la risposta, non ricopiare tutto il contesto
Abbiamo definito ciò che può cambiare nel modello. Ora dobbiamo definire su quali posizioni di testo calcoliamo l’errore.
Durante l’addestramento, una sequenza contiene il contesto — compresi la domanda e gli elementi associati all’immagine — poi la risposta attesa dell’assistente. La funzione di perdita, o loss, misura lo scarto tra le previsioni e i token da apprendere. Vogliamo addestrare la risposta JSON, non chiedere al modello di ricopiare la domanda o le posizioni di riempimento.
Il padding, o riempimento, aggiunge posizioni per organizzare sequenze di lunghezze diverse nelle tabelle. Queste posizioni non sono contenuto da prevedere. Il codice usa quindi il valore speciale -100 nelle etichette di apprendimento, le labels, per le posizioni ignorate dalla perdita.
def assistant_labels(input_ids, attention_mask, prompt_length, forbidden_ids):
    if (
        input_ids.ndim != 1
        or attention_mask.shape != input_ids.shape
        or not 0 < prompt_length < len(input_ids)
    ):
        raise ValueError("Invalid completion boundary")
    labels = input_ids.clone()
    labels[:prompt_length] = -100
    labels[~attention_mask.bool()] = -100
    for identifier in forbidden_ids:
        labels[input_ids == identifier] = -100
    if (labels != -100).sum() == 0:
        raise ValueError("No assistant target token")
    if (labels[:prompt_length] != -100).any():
        raise ValueError("Prompt included in loss")
    return labels
Il controllo iniziale richiede una sequenza a una dimensione, un attention_mask della stessa forma e un confine prompt_length collocato dopo l’inizio ma prima della fine. Questo confine separa il contesto dalla risposta.
clone() copia gli identificatori per costruire le label senza modificare l’input. Le tre operazioni successive marcano con -100 il prefisso del prompt, le posizioni in cui la maschera di attenzione vale zero e gli identificatori presenti in forbidden_ids. Se non resta alcun target, la funzione rifiuta l’esempio invece di avviare un apprendimento senza risposta da apprendere. L’ultimo controllo verifica che il prompt sia effettivamente escluso.
Prendiamo un esempio didattico di identificatori, senza legame con il vero vocabolario del tokenizer. L’input è [101, 501, 502, 601, 602, 603, 0], il prefisso occupa le prime tre posizioni, l’ultima è padding e 603 fa parte degli identificatori vietati. Le label diventano [-100, -100, -100, 601, 602, -100, -100].
Solo i target 601 e 602 contribuiscono direttamente alla perdita. Il contesto non è però stato rimosso dall’input. Il modello può sempre usarlo per produrre la risposta. Mascherare un target di apprendimento non equivale a cancellare la domanda o l’immagine.
Il valore -100 non è dunque né un token che il modello deve generare, né un sinonimo di JSON null. Significa soltanto « ignorare questa posizione per la perdita », secondo il meccanismo ignore_index documentato da PyTorch.
La perdita sposta poi i target: la previsione in una posizione apprende il token seguente. Questo spostamento non viene realizzato in assistant_labels(). La funzione presentata costruisce la maschera; il calcolo della perdita la usa in seguito. Nel target JSON, valori e coordinate vengono così appresi attraverso la loro rappresentazione in token.
Da ricordare: LoRA sceglie quali parametri cambiano; la maschera sceglie quali target contribuiscono all’apprendimento; il validatore verificherà la forma dell’output prodotto. Questi tre meccanismi hanno ruoli diversi.
Validare la risposta generata
Dopo l’inferenza, riceviamo testo grezzo. Può essere incompleto, mal formato o contenere coordinate impossibili. Lo controlliamo prima di considerarlo una risposta utilizzabile dal programma.
L’estratto seguente proviene da src/pdfvqa/validate_answer.py. Non consulta la risposta attesa per correggere la previsione.
"""Validate raw model output, without repairing it from the expected answer."""

import json


def validate_answer(raw, terminated=True):
    if not terminated:
        return {"valid": False, "error": "length", "value": None}
    try:
        value = json.loads(raw)
    except (ValueError, TypeError):
        return {"valid": False, "error": "json", "value": None}
    if not isinstance(value, dict) or set(value) != {"answer", "box"}:
        return {"valid": False, "error": "schema", "value": None}
    answer, box = value["answer"], value["box"]
    if answer is None and box is None:
        return {"valid": True, "error": None, "value": value}
    if answer is None or box is None:
        return {"valid": False, "error": "asymmetric_null", "value": None}
    if not isinstance(answer, str) or not answer.strip():
        return {"valid": False, "error": "answer", "value": None}
    if (
        not isinstance(box, list)
        or len(box) != 4
        or any(type(x) is not int for x in box)
    ):
        return {"valid": False, "error": "box_type", "value": None}
    if not 0 <= box[0] < box[2] <= 1000 or not 0 <= box[1] < box[3] <= 1000:
        return {"valid": False, "error": "box_bounds", "value": None}
    return {"valid": True, "error": None, "value": value}


def iou(a, b):
    intersection = max(0, min(a[2], b[2]) - max(a[0], b[0])) * max(
        0, min(a[3], b[3]) - max(a[1], b[1])
    )
    union = (a[2] - a[0]) * (a[3] - a[1]) + (b[2] - b[0]) * (b[3] - b[1]) - intersection
    return intersection / union if union > 0 else 0.0
Dal testo grezzo a un oggetto accettato o rifiutato
terminated indica se la generazione è terminata correttamente. Quando vale False, la funzione restituisce l’errore length, anche se l’inizio dell’output sembra utilizzabile. Il chiamante deve trasmettere questo stato: il validatore non può indovinare, dalla sola stringa, come il modello si sia fermato.
json.loads() decodifica poi il testo. Un errore restituisce json. Dopo la decodifica, il programma richiede un dizionario contenente esattamente answer e box: una chiave mancante o aggiuntiva restituisce schema.
Segue il controllo della coppia. Due valori None, provenienti dai due null JSON, costituiscono un’astensione valida. Un solo valore nullo produce asymmetric_null: l’astensione è incompleta. Altrimenti, answer deve essere una stringa non vuota dopo la verifica degli spazi.
La box deve essere una lista di quattro interi, quindi rispettare 0 ≤ sinistra < destra ≤ 1000 e 0 ≤ alto < basso ≤ 1000. Le disuguaglianze strette vietano larghezza o altezza nulle. Il controllo type(x) is not int rifiuta in particolare un booleano al posto di una coordinata. Gli errori distinguono il tipo errato (box_type) da una geometria fuori contratto (box_bounds).
La funzione usa answer.strip() per rilevare una stringa vuota, ma restituisce l’oggetto originale: non ripulisce sistematicamente la risposta. Non converte neppure un importo, non verifica una valuta e non sostituisce le coordinate fuori pagina con il loro valore limite.
valid=True significa quindi « conforme al contratto controllato qui », non « corretto nel documento ». Un importo sbagliato accompagnato da un rettangolo ben formato può essere accettato. Analogamente, un’astensione può essere strutturalmente valida mentre la pagina contiene la risposta. Spetta alla valutazione della correttezza distinguere questi casi.
Calcolare l’IoU con un piccolo spostamento
La funzione iou() calcola anzitutto larghezza e altezza dell’intersezione. I max(0, ...) evitano di creare un’area negativa quando i rettangoli non si toccano. L’unione è la somma delle due aree, meno la loro intersezione, per non contare due volte l’area comune.
Riprendiamo un esempio numerico illustrativo, non una misura Orion. La box di riferimento è [600, 700, 800, 750]. La previsione è spostata di 100 unità verso destra: [700, 700, 900, 750].
Ogni rettangolo ha un’area di 200 × 50 = 10 000. La loro intersezione misura ormai soltanto 100 × 50 = 5000. L’unione vale 10 000 + 10 000 − 5000 = 15 000. L’IoU è dunque 5000 / 15 000 = 1/3, cioè circa 0,3333.
Il testo potrebbe essere rimasto esattamente 120.00 in entrambe le risposte. Il calo dell’IoU non misura un cambiamento del testo: misura il deterioramento della localizzazione. L’esercizio finale provocherà proprio questa separazione sugli output del progetto.
La funzione iou() presuppone box utilizzabili per questo calcolo; non sostituisce validate_answer(). Quanto alle coordinate previste, non vengono mai corrette dopo la generazione usando il gold. Altrimenti misureremmo una risposta assistita dalla soluzione, non la previsione del modello.
Prerequisiti e comandi
Dovete saper leggere Python, usare un terminale e avviare Docker. Gli estratti precedenti spiegano i meccanismi; lo ZIP fornisce il progetto completo necessario per eseguirli.
Il profilo di riferimento usa Linux, Docker Engine, Compose, un driver NVIDIA e NVIDIA Container Toolkit, su una RTX 3090 da 24 GiB compatibile con BF16. Il percorso consiglia 48 GiB di RAM e 55 GiB di disco. Sono raccomandazioni di preparazione; il profilo CPU non è convalidato.
La VRAM è la memoria della scheda grafica, distinta dalla RAM della macchina. BF16 indica un formato numerico a 16 bit, tra i tipi numerici di PyTorch. La sua presenza nel profilo non significa che tutti i calcoli usino questo formato: abbiamo appena visto la correzione LoRA preparata esplicitamente in FP32.
Il driver permette il calcolo GPU sull’host. NVIDIA Container Toolkit fornisce l’integrazione con Docker. Vedere la scheda con nvidia-smi ne conferma la visibilità su Linux, non ancora il funzionamento del modello nel container. check_environment.py esegue questa seconda verifica. La documentazione ufficiale NVIDIA descrive l’installazione adatta al sistema; i controlli del progetto non lo modificano silenziosamente.
Decomprimete lo ZIP e collocate il terminale nella sua cartella radice. Tutti i comandi qui sotto partono da questa radice e vanno eseguiti nell’ordine indicato. Il servizio acquisition recupera gli asset del modello, tutorial prepara i dati, addestra e valuta, mentre inference produce le previsioni senza consultare le label.
Passo 1 — preparare
Verifichiamo l’ambiente, prepariamo il progetto, costruiamo i servizi e acquisiamo i file attesi prima di avviare i test.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
Ogni comando deve terminare con un codice di uscita zero, quindi senza errore segnalato. Questi controlli hanno scopi diversi: Compose verifica la configurazione, la build costruisce le immagini, l’acquisizione bloccata recupera gli asset previsti, poi il controllo dell’ambiente esegue il modello in Docker. Infine i test verificano i comportamenti del programma.
Una build riuscita non sostituisce né il controllo GPU né i test. E test riusciti non significano che tutte le risposte del modello saranno corrette: questa misura viene dopo.
Passo 2 — costruire la previsione
Prepariamo le pagine e le loro domande, osserviamo un lotto, poi produciamo un primo riferimento senza adattamento.
docker compose run --rm tutorial python -m pdfvqa.cli prepare --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfvqa.cli inspect-batch --config configs/minimum.yaml
docker compose run --rm inference python -m pdfvqa.cli baseline --config configs/minimum.yaml
prepare costruisce gli input e i target. inspect-batch permette di ispezionare ciò che riceve il modello e ciò che gli chiediamo di produrre. Per la domanda guida, individuate il costo approvato, poi verificate che il target indichi proprio questo campo e non l’altro costo.
baseline significa riferimento di confronto. Qui usa il modello congelato, senza l’adattamento Orion, ma con lo stesso contratto di output. Questa fase risponde a una domanda essenziale: che cosa sa già fare il modello prima del nostro addestramento?
Aprite gli output intermedi. L’ispezione serve a capire dati ed errori, non a riscrivere una risposta di riferimento affinché corrisponda a una previsione.
Passo 3 — misurare e controllare
Ora possiamo addestrare l’adattatore, controllare una ripresa dopo un’interruzione, quindi produrre e valutare le risposte adattate.
docker compose run --rm tutorial python -m pdfvqa.cli train --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfvqa.cli train-continuous --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfvqa.cli train-resume --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfvqa.cli verify-resume --config configs/minimum.yaml
docker compose run --rm inference python -m pdfvqa.cli predict --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfvqa.cli evaluate --config configs/minimum.yaml
train apprende i parametri LoRA e registra un checkpoint, uno stato che permette di conservare il lavoro svolto. I comandi train-continuous e train-resume confrontano un’esecuzione continua con un’esecuzione ripresa. verify-resume verifica che l’interruzione non abbia modificato l’esperienza.
Riprendere correttamente richiede più che ricaricare alcune matrici. Anche l’ottimizzatore, che ne guida gli aggiornamenti, possiede uno stato; i generatori casuali devono essere ripristinati. Il risultato di riferimento r001 indica una ripresa EXACT. Descrive il controllo di questo percorso, non promette identità numerica su qualsiasi hardware o dopo una modifica delle dipendenze.
predict esegue poi il modello adattato nel servizio di inferenza. evaluate unisce previsioni e annotazioni per calcolare le misure. Le label servono dunque a valutare dopo la previsione, non ad aiutare il modello nel momento in cui risponde.
Misure prima dei numeri
Leggere le metriche nel giusto ordine
Cominciamo dalla validità del JSON e del contratto. Il nome può far pensare alla sola decodifica JSON, ma il controllo presentato va oltre: chiavi esatte, tipi, coppia risposta/box e coordinate. Un rifiuto deve restare visibile; non bisogna salvare solo i frammenti che danno un’impressione di successo.
L’esattezza della risposta confronta il testo con il riferimento dopo la regola di normalizzazione prevista dal progetto. Non è una libera valutazione del significato. Non sostituite questa regola con una conversione dell’importo o una riformulazione scelta dopo aver visto i risultati.
L’IoU misura la sovrapposizione delle box per le domande con risposta possibile. Non si applica ai campi assenti: non esiste un rettangolo atteso da confrontare con un’astensione.
La correttezza congiunta richiede che i controlli di risposta, schema e localizzazione siano soddisfatti insieme. Un buon valore non compensa quindi una box errata. La soglia numerica di accettazione della localizzazione non è dettagliata in questa presentazione: mantenete la regola del valutatore dello ZIP, senza dedurla dalla media IoU né sostituirla con una soglia arbitraria.
Infine, la precisione dell’astensione risponde a « fra le astensioni emesse, quante riguardano davvero campi assenti? ». Il richiamo dell’astensione risponde a « fra i campi assenti, quanti hanno effettivamente portato a un’astensione? ».
Esempio didattico: su dieci campi assenti, un sistema si astiene correttamente otto volte, ma si astiene anche una volta mentre la risposta è presente. Il suo richiamo vale 8/10 = 0,8; la sua precisione vale 8/9, cioè circa 0,8889. Le due misure non raccontano lo stesso errore. Questo esempio non è il risultato del modello Orion.
Un sistema che risponde sempre può ignorare le assenze; un sistema che si astiene sempre può mancare tutti i valori presenti. Per questo conserviamo le due popolazioni e più misure.
Interpretare gli output passo dopo passo
Dopo predict, cercate la risposta JSON grezza, il suo stato di validazione, la box e la sovrimpressione, detta anche overlay. È il rettangolo disegnato sull’immagine per facilitare la vostra ispezione, non una convalida aggiuntiva del modello.
Per un output accettato, confrontate il testo, il campo richiesto e l’area incorniciata. Per un output rifiutato, conservate l’errore: json, schema, box_bounds o un altro motivo. Trasformare un risultato non valido in una frase plausibile farebbe perdere la diagnosi.
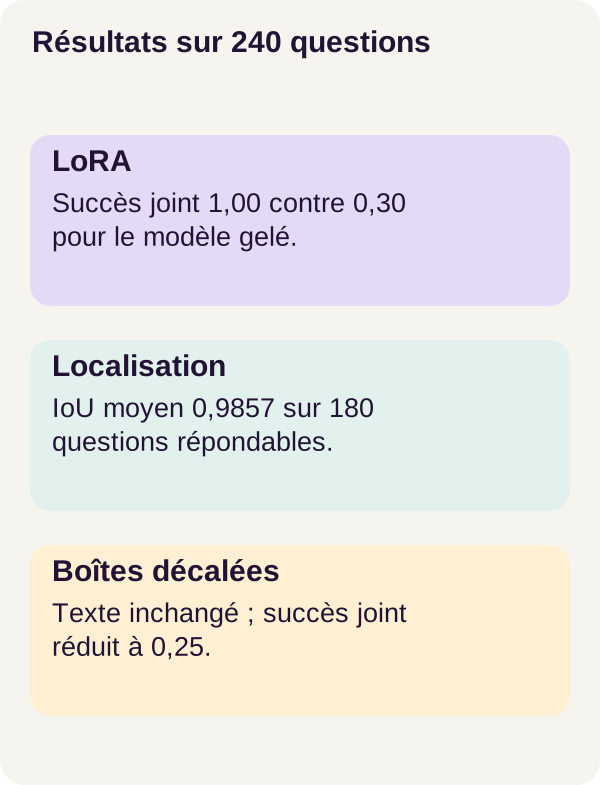
Ecco i risultati di riferimento r001, sulle 240 domande di test del corpus sintetico Orion:
Su mobile, scorrete orizzontalmente la tabella.
| Misura LoRA | Popolazione interessata | Risultato osservato |
|---|---|---|
| Esattezza della risposta | 240 domande | 1,0000 |
| Validità del JSON e del contratto | 240 domande | 1,0000 |
| Correttezza congiunta | 240 domande | 1,0000 |
| IoU medio | 180 domande con risposta possibile | 0,9857 |
| Precisione dell’astensione | Astensioni nel test | 1,0000 |
| Richiamo dell’astensione | 60 campi assenti | 1,0000 |
Il modello congelato raggiunge 0,3000 di correttezza congiunta, contro 1,0000 dopo l’adattamento LoRA. Sulle 240 domande, questo corrisponde a 72 successi congiunti contro 240, secondo il criterio di questo percorso.
Come leggere il contrasto tra correttezza congiunta perfetta e IoU di 0,9857? Tutte le risposte superano il criterio di localizzazione del valutatore, ma non tutti i rettangoli coincidono esattamente con il loro riferimento. Un successo secondo il criterio non è un’uguaglianza perfetta delle coordinate.
I risultati mostrano qui un guadagno dell’adattamento rispetto al modello congelato. Non prevedono le prestazioni su scrittura a mano, scansioni degradate o diciture dei clienti differenti. Non dimostrano neppure una superiorità rispetto a metodi che questo percorso non confronta.
Risoluzione dei problemi e passaggio a un prodotto
Il modello non è utilizzabile in Docker? Tornate al controllo dell’ambiente, all’accesso alla GPU e all’integrazione NVIDIA. Un problema di esecuzione non si diagnostica a partire da una metrica di risposta.
Il JSON viene rifiutato? Ispezionate il prompt, i limiti di generazione e la versione del modello. Una risposta interrotta troppo presto può essere incompleta. Una box fuori pagina resta non valida: non troncatevela per farle superare il controllo e non recuperate il valore nel riferimento.
Il testo è esatto ma la box è mal posizionata? Mostrate questo output come insufficientemente giustificato. L’interfaccia può aiutare a vedere l’errore; non deve mascherarlo sotto un punteggio globale.
Per un prodotto, ogni proposta dovrebbe restare legata a un PDF immutabile, a una pagina, a un’area, a una versione del modello e a un registro delle decisioni. Sono elementi da prevedere attorno al tutorial, non nuovi campi da aggiungere silenziosamente al contratto JSON testato.
Che cosa abbiamo imparato
LoRA apprende una correzione a basso rango in proiezioni mirate, senza modificare i pesi di base. La maschera di apprendimento conserva il contesto negli input, ma limita i target sui quali viene calcolata la perdita.
Una volta prodotta la risposta, Python ne verifica il contratto. La valutazione verifica poi altro: il testo giusto, l’area giusta e la giusta decisione di rispondere o astenersi. Nessuna di queste dimensioni sostituisce le altre.
Su Orion, l’adattamento migliora nettamente la correttezza congiunta rispetto al modello congelato. Per capire perché una risposta testualmente esatta resti insufficiente, ora sposteremo soltanto la sua giustificazione visiva.
Esercizio — spostare la prova senza cambiare il testo
Prima di avviare l’esercizio, scrivete la vostra ipotesi. Che cosa succede all’esattezza testuale, all’IoU e alla correttezza congiunta se ogni box viene spostata orizzontalmente di 100 unità normalizzate, senza cambiare le risposte? Che cosa deve accadere alle astensioni, che non possiedono una box?
Pensate al piccolo calcolo precedente: due rettangoli possono restare nella pagina pur sovrapponendosi molto meno. « Coordinate autorizzate » e « localizzazione corretta » non sono sinonimi.
Eseguite quindi l’esperimento fornito, senza modificare il codice convalidato:
docker compose run --rm tutorial python -m pdfvqa.cli exercise --config configs/exercise.yaml
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
Il primo comando esegue l’esercizio. Il successivo produce le figure, l’ultimo controlla i checkpoint attesi. Confrontate gli output con la vostra previsione prima di accontentarvi del punteggio finale.
Risultato osservato: tutti i 240 testi restano identici e l’esattezza testuale vale 1. L’IoU medio scende a 0,1692 e la correttezza congiunta a 0,25. Le 60 astensioni restano corrette e nessuna box è fuori limite.
Lo 0,25 diventa particolarmente significativo: le 60 astensioni rappresentano 60/240 = 0,25 del test. Bastano a spiegare tutti i successi congiunti rimanenti. Il testo non è cambiato; è la localizzazione delle risposte presenti a non superare più il controllo congiunto.
Non c’è contraddizione con il validatore. Un rettangolo spostato può conservare quattro interi, una larghezza positiva e coordinate tra 0 e 1000. Rimane ben formato pur mostrando l’area sbagliata.
Questa perturbazione degli output è distinta dalle due pagine aggiuntive dell’esercizio, in cui un campo ha davvero cambiato posizione. In un caso spostiamo una box dopo la previsione; nell’altro modifichiamo il documento che il modello deve leggere. Non presentate i numeri del primo esperimento come misura del secondo.
Scegliere un’azione dopo la valutazione
Una risposta insufficientemente giustificata deve essere presentata a un operatore con il PDF e la sua sovrimpressione, non inviata automaticamente a un sistema contabile. Un’astensione non deve essere sostituita dal valore approssimativo che sembra più vicino.
Occorre tuttavia distinguere una metrica di valutazione da un controllo disponibile in produzione. La correttezza congiunta e l’IoU con il gold richiedono un’annotazione nota. Su un nuovo PDF senza riferimento, il programma non dispone improvvisamente di questi punteggi per decidere da solo. Le regole di rifiuto, i controlli di business e la revisione umana devono quindi essere progettati e valutati separatamente.
Allo stesso modo, il contratto testato esprime l’astensione con due valori nulli; non contiene un campo che ne spieghi il motivo. Conservare un motivo verificato in un registro o in un’interfaccia è un lavoro di integrazione aggiuntivo, non un’informazione da inventare a partire da null.
Per adattare l’esperimento ai vostri moduli, separate i dati per famiglia e modello di documento. Tenete il test separato prima delle iterazioni, poi misurate distintamente risposta, schema, localizzazione e astensione. L’obiettivo non è soltanto ottenere un numero migliore, ma sapere quali errori può nascondere.
Output attesi ed errori utili
Dopo prepare, individuate le pagine, le domande e i target separati. Dopo baseline, conservate gli output del modello congelato per confrontare gli stessi casi. Dopo predict, esaminate valid, error, quindi answer e box nella risposta strutturata quando disponibile. Nell’estratto di validazione, questa risposta è archiviata in value, che vale None in caso di rifiuto.
evaluate precisa le popolazioni e distingue test ed esercizio. Questa distinzione evita di mescolare domande nuove con una perturbazione artificiale di previsioni esistenti.
Un risultato asymmetric_null segnala una risposta senza box o una box senza risposta. box_type segnala un problema di rappresentazione; box_bounds, un problema di limiti o di ordine delle coordinate. Questi errori sono output utili del programma. Farli sparire senza capirne la causa renderebbe il sistema meno osservabile, non più esatto.
Produzione, limiti e pulizia
Il tutorial fornisce un’esperienza su moduli fittizi. Per passare a documenti reali, costituite esempi autorizzati e rappresentativi, con risposte e aree verificate. Le variazioni di diciture, qualità dell’immagine e impaginazione devono essere valutate, non considerate implicitamente coperte.
Conservate la versione del modello, il documento, la pagina, le aree, le unità e le regole di rifiuto. Aggiungete diritti di accesso, monitoraggio e revisione umana per costi o decisioni contrattuali. Un’assenza, un’unità ambigua o una box non valida non devono mai essere trasformate in certezza dalla sola presentazione dell’interfaccia.
Prima della pulizia, salvate gli export utili. Lo script qui sotto riguarda solo outputs/:
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Il primo docker compose down arresta i servizi del progetto. Il container avviato poi esegue la pulizia mirata, quindi l’ultimo arresto termina il percorso. Questi comandi non richiedono una pulizia Docker globale.
Per approfondire il metodo, la documentazione ufficiale di PEFT e LoRA presenta gli adattatori su modelli preaddestrati. L’articolo fondativo di LoRA dettaglia l’idea di una correzione a basso rango. Questi riferimenti completano la spiegazione; l’implementazione presentata qui resta la classe LoRALinear dello ZIP, non una riscrittura con un’altra libreria.
Le documentazioni collegate in questo articolo servono a comprendere i meccanismi. Per riprodurre r001, mantenete i comandi, la configurazione e le dipendenze del progetto fornito: un esempio di documentazione non è un invito a modificare l’ambiente di riferimento.
Che cosa abbiamo imparato: un valore diventa controllabile quando resta collegato alla sua pagina, a un’area e a regole di validazione esplicite. L’ultima fase non consiste nel credere al riquadro mostrato, ma nel verificare ciò che indica.