





Imaginez un écran de back-office qui affiche plusieurs fiches pour ce qui semble être le même document. Les titres se ressemblent, les références ne sont pas toujours renseignées avec la même fiabilité, et certaines fiches correspondent à des versions différentes. Vous aimeriez proposer un regroupement pour faciliter la navigation. Mais certainement pas supprimer une version utile ou réunir deux documents distincts parce qu'ils partagent quelques mots.
C'est le problème que nous allons explorer avec quatre fiches fictives. A-17 et B-92 décrivent le document logique VC-204 ; D-40 en est la version 2. C-11 décrit VC-205, avec un titre presque identique. Le regroupement attendu conserve A-17, B-92 et D-40 ensemble, tout en laissant C-11 à part.
Le mot logique est important : il désigne ici l'identité documentaire à laquelle plusieurs fiches et versions se rapportent. Il ne signifie pas que leurs fichiers sont identiques octet par octet. Rapprocher les fiches n'est pas fusionner leurs fichiers. Dans ce tutoriel, chaque fichier et chaque version restent conservés ; le programme produit une proposition, sans mettre à jour la GED, la gestion électronique des documents.
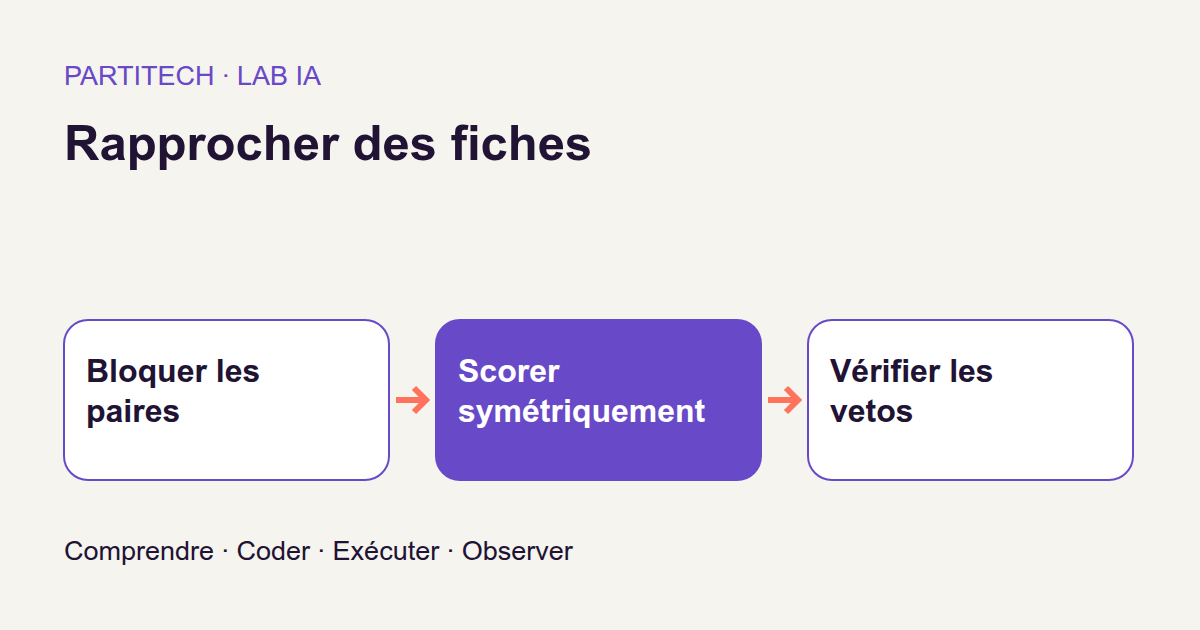
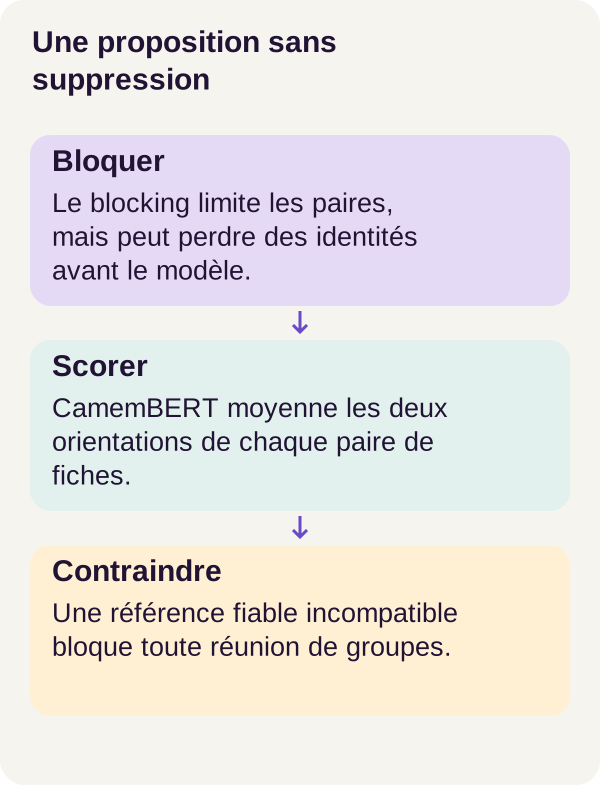
Nous allons construire la chaîne suivante : fiches → paires candidates → scores CamemBERT → décisions au seuil → groupes proposés et contrôlés. Un premier filtre réduit le nombre de comparaisons. Un modèle apprend ensuite à examiner deux fiches ensemble. Enfin, du code vérifie qu'un regroupement ne contourne pas un conflit administratif fiable.
L'intérêt du parcours est de comprendre où chacun intervient, puis de mesurer ce qu'il apporte. Un excellent classifieur ne retrouve pas automatiquement les candidats que le filtre a oubliés. Et quelques mauvaises paires peuvent suffire à former un groupe beaucoup trop large.
Mesurer les étapes séparément
Le blocking : choisir les comparaisons, pas encore les réponses
Comparer toutes les fiches deux à deux paraît simple. Mais pour n fiches, il faut examiner n × (n - 1) / 2 paires distinctes : on ne compare pas une fiche à elle-même et on ne compte pas deux fois A/B et B/A.
Avec seulement 648 fiches, cela donne déjà 209 628 paires. Le blocking est une présélection : il conserve un ensemble plus petit de paires qui méritent un examen approfondi. Pour un développeur web, pensez à une première sélection de candidats avant un traitement coûteux, plutôt qu'à une décision définitive d'identité.
Exemple pédagogique, distinct des règles du ZIP : si l'on ne comparait que des fiches portant exactement la même référence, une référence absente ou mal saisie pourrait empêcher deux fiches du même document de se rencontrer. Le modèle placé après ce filtre n'aurait alors pas l'occasion de les reconnaître. La documentation du Python Record Linkage Toolkit sur l'indexation présente ce principe de réduction des paires ; elle ne décrit pas les règles particulières de notre projet.
Dans le parcours r001, le regroupement contraint peut demander des scores supplémentaires pour vérifier une union envisagée. Nous distinguerons donc les candidats du premier filtre et les comparaisons de contrôle ajoutées pendant le regroupement. Ces dernières ne constituent pas une nouvelle recherche exhaustive parmi toutes les fiches.
Un modèle qui lit les deux fiches ensemble
CamemBERT est un modèle de langue préentraîné sur du français. Un tokenizer découpe le texte en unités appelées tokens, parfois plus petites qu'un mot. Le modèle transforme ces unités en embeddings : des vecteurs, autrement dit des listes de nombres, qui représentent le texte en tenant compte de son contexte. La documentation officielle de CamemBERT décrit notamment son utilisation pour classer du texte et des paires de séquences.
Ici, nous utilisons un cross-encodeur : les deux fiches sont présentées ensemble au modèle, qui produit un score pour leur paire. Le texte de la première peut ainsi être mis en relation avec celui de la seconde pendant le calcul. Ce n'est pas la même opération que calculer un vecteur indépendant par fiche, le stocker, puis comparer ces vecteurs.
L'avantage recherché est un examen conjoint des champs. La contrepartie est le coût : une nouvelle paire demande un nouveau calcul du modèle. La documentation Sentence Transformers sur les cross-encodeurs explique cette distinction. Elle sert ici à comprendre l'architecture, pas à ajouter une bibliothèque ou un autre modèle au parcours.
L'apprentissage est supervisé : une cible vaut 1 lorsque les deux fiches décrivent le même document logique, 0 sinon. Une paire positive ne signifie donc pas nécessairement « deux copies identiques du même fichier ». La version 2 d'un document peut appartenir au même groupe que sa version précédente.
Le corpus synthétique contient 4 320 fiches pour 1 440 documents logiques, dont 648 fiches dans le test. Les identités de référence, souvent appelées gold, permettent de savoir quelles paires et quels groupes sont attendus. Elles servent à apprendre ou à évaluer selon la partition, jamais à fournir directement la réponse pendant l'inférence.
Précision et rappel : de quelles paires parle-t-on ?
Un vrai positif est une paire proposée comme identique qui l'est réellement dans la référence. Un faux positif réunit à tort deux documents distincts. Un faux négatif est une paire positive attendue que le système ne retrouve pas.
La précision répond à « parmi les rapprochements proposés, combien sont justes ? ». Le rappel répond à « parmi les rapprochements attendus, combien avons-nous retrouvés ? ». Le F1 combine les deux par une moyenne harmonique : 2 × précision × rappel / (précision + rappel).
Nous allons employer trois mesures complémentaires :
| Mesure | Calcul | Question posée |
|---|---|---|
| Rappel du blocking | Positives candidates / toutes les positives attendues | Le premier filtre conserve-t-il les bonnes comparaisons ? |
| Rappel candidat du classifieur | Vrais positifs / positives parmi les candidats | Le modèle reconnaît-il les bonnes paires qu'il reçoit ? |
| Rappel de bout en bout des paires | Vrais positifs / toutes les positives attendues | Que retrouve la chaîne de présélection et de classification ? |
Exemple pédagogique : dix paires positives sont attendues, le filtre en garde sept et le modèle reconnaît ces sept sans erreur. Son rappel candidat vaut 7/7 = 1, mais le rappel de bout en bout vaut 7/10 = 0,7. Il n'y a aucune contradiction : les dénominateurs sont différents.
Plus généralement, pour cette chaîne de paires, le rappel de bout en bout est le produit du rappel du blocking et du rappel candidat. Améliorer seulement le classifieur ne supprime donc pas la limite imposée par la présélection.
B-cubed : regarder les compagnons de chaque fiche
Après les paires viennent les groupes, ou clusters. Le score B-cubed regarde, pour chaque fiche, son groupe proposé et son groupe de référence. Les membres communs sont les compagnons correctement conservés ensemble, fiche elle-même comprise.
La précision locale divise ce nombre de membres communs par la taille du groupe proposé. Elle baisse si nous y ajoutons des intrus. Le rappel local le divise par la taille du groupe attendu. Il baisse si nous laissons de côté des membres du même document.
Exemple pédagogique : une fiche devrait être avec deux autres, soit un groupe attendu de trois membres. Le groupe proposé contient deux membres corrects et un intrus. Pour cette fiche, précision et rappel B-cubed valent tous deux 2/3. Le calcul est répété pour chaque fiche, puis les précisions et rappels sont moyennés. Nous calculerons le F1 de ces deux moyennes : cette convention retrouve les valeurs publiées dans le parcours, comme le montrera l'exemple à quatre fiches.
Une stratégie qui laisse tout le monde seul évite les groupes trop larges, mais manque les rapprochements attendus. Inversement, un seul immense groupe retrouve tous les compagnons attendus, en leur ajoutant beaucoup d'intrus. C'est pourquoi précision et rappel doivent être lus ensemble.
Enfin, une cannot-link est un veto explicite : dans ce projet, deux références fiables, non vides et différentes ne doivent pas appartenir au même groupe. Une fiche seule forme un singleton ; elle n'est pas supprimée. Nous mesurerons séparément la qualité des groupes, le nombre de paires interdites qu'ils contiennent et la conservation des versions.
Préparer le lecteur GPU
Ce qu'il faut avant de commencer
Vous devez savoir lire du Python, utiliser un terminal et lancer Docker. Les bases de PyTorch, de la classification supervisée et des graphes sont utiles ; nous allons expliquer les opérations qui apparaissent dans les extraits. Un tenseur est ici un tableau numérique, et un graphe un ensemble de fiches reliées par des rapprochements proposés.
Le profil de référence est Linux avec une RTX 3090 de 24 Gio, 24 Gio de RAM et 30 Gio de disque de travail, auxquels s'ajoute le stockage Docker. La mémoire de la carte graphique et la RAM de la machine sont deux ressources distinctes. Ces indications ne garantissent ni une durée ni la capacité de toute autre configuration. Les résultats présentés viennent du parcours GPU r001 ; ils ne constituent pas une validation CPU.
Décompressez le ZIP du cours, disponible en fin d'article, et ouvrez un terminal à sa racine. Toutes les commandes suivantes se lancent depuis ce répertoire, dans l'ordre indiqué. Les versions et réglages à reproduire sont ceux de l'archive.
Un GPU visible sur l'hôte ne suffit pas : Docker doit pouvoir y accéder. NVIDIA Container Toolkit fournit l'intégration nécessaire. Si elle manque, le diagnostic du projet indique l'action attendue sans installer silencieusement quoi que ce soit. GPU_DEVICE=1 permet de sélectionner une autre carte avant le parcours.
Contrôler, construire et acquérir les actifs
Commençons par les contrôles préalables, la préparation et la construction des services.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial learning inference
Le préflight contrôle Docker, Compose, RAM, disque et GPU. docker compose config --quiet réussit sans afficher de contenu lorsque la configuration est valide. Chaque étape doit se terminer sans erreur avant la suivante.
L'acquisition récupère ensuite les six actifs CamemBERT prévus par le projet.
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
Leur taille et leur empreinte SHA-256 sont vérifiées avant un remplacement atomique : les fichiers validés prennent la place prévue sans publier une copie partielle comme si elle était complète. L'empreinte contrôle l'identité des octets attendus, pas la pertinence des futures prédictions. Aucun cache privé n'est distribué dans l'archive.
Vérifions maintenant l'environnement depuis le conteneur, puis les tests du projet.
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
Le contrôle d'environnement effectue réellement un calcul depuis Docker. Les tests examinent notamment les conflits, la symétrie et la conservation des versions. Ils vérifient des comportements du programme ; ils ne prouvent pas que chaque rapprochement métier sera correct. Vérifiez que votre exécution se termine sans échec et conservez son compte rendu.
Générer des fiches, des candidats et un score symétrique
Séparer les entrées des réponses attendues
La préparation place les fiches et leurs fichiers fictifs dans data/generated/input/. Les identités gold restent dans labels/. Le conteneur learning ne monte que les paires d'apprentissage et de validation ; inference ne monte aucune annotation.
L'idée est proche d'un exercice dont le corrigé reste fermé pendant que l'on répond. Le modèle doit utiliser les champs observables, pas lire l'identité gold de la paire qu'il doit classer.
docker compose run --rm tutorial python -m ged_rapprochement_fiches.cli prepare --config configs/minimum.yaml
docker compose run --rm tutorial python -m ged_rapprochement_fiches.cli baseline --config configs/minimum.yaml
docker compose run --rm inference python -m ged_rapprochement_fiches.cli inspect-mechanism --config configs/minimum.yaml
prepare fabrique les données. baseline produit des méthodes de référence simples auxquelles comparer le modèle. Parmi elles, la référence exacte utilise un signal d'égalité ; Jaccard mesure un recouvrement lexical. Le principe de Jaccard est « éléments communs / éléments présents dans au moins un des deux ensembles ». Les règles exactes de préparation des ensembles restent celles du ZIP.
inspect-mechanism montre les champs sérialisés et la symétrie. Sérialiser signifie transformer les champs d'une fiche en une entrée textuelle organisée. Le projet transmet la référence, sa fiabilité, le titre, l'affaire, le texte et la version. Le champ de fiabilité n'est pas superflu : lire une référence et savoir qu'elle est digne de confiance sont deux informations différentes.
Observez cette représentation avant d'entraîner. Une inspection pédagogique rend le calcul lisible ; elle ne doit pas être présentée comme un score agrégé sur le test.
Entraîner, interrompre et reprendre
L'entraînement ajuste les paramètres appris à partir des paires annotées. L'inférence, elle, utilise les paramètres obtenus pour attribuer des scores à de nouvelles paires.
docker compose run --rm learning python -m ged_rapprochement_fiches.cli train --config configs/minimum.yaml --mode interrupt
docker compose run --rm learning python -m ged_rapprochement_fiches.cli train --config configs/minimum.yaml --mode continuous
docker compose run --rm learning python -m ged_rapprochement_fiches.cli train --config configs/minimum.yaml --mode resume
docker compose run --rm learning python -m ged_rapprochement_fiches.cli verify-resume --config configs/minimum.yaml
Le parcours distingue une exécution interrompue, une exécution continue et une reprise. Un checkpoint est un état sauvegardé permettant de poursuivre un calcul ; une reprise n'est pas un nouvel entraînement arbitraire sur les mêmes fichiers. verify-resume contrôle la cohérence du parcours repris avec le parcours continu. Ce contrôle de reproduction ne remplace pas l'évaluation sur des fiches inconnues.
Pour examiner le budget d'entraînement, l'optimiseur et les détails de restauration, consultez configs/minimum.yaml et le code livré. Conservez ces réglages pendant la reproduction de référence, avant d'expérimenter dans une copie séparée.
Du logit à la décision
Le modèle produit un logit, un score brut qui peut être positif, négatif ou nul. La sigmoïde transforme ce score en une valeur entre 0 et 1 : sigmoïde(z) = 1 / (1 + exp(-z)).
Pendant l'apprentissage, la perte, ou loss, mesure l'écart entre la prédiction et la cible. Pour comprendre l'entropie croisée binaire sans pondération, retenez deux cas : si la cible vaut 1, l'erreur est -log(p) ; si elle vaut 0, c'est -log(1-p). Donner une forte confiance au mauvais résultat coûte donc cher.
Exemple numérique pédagogique : pour une paire réellement positive, p = 0,9 donne une perte d'environ 0,1054, contre 2,3026 avec p = 0,1. L'apprentissage utilise ce signal pour ajuster les paramètres ; il n'écrit pas une règle textuelle à partir de chaque exemple.
La documentation de BCEWithLogitsLoss, également disponible dans la référence PyTorch 2.8, précise que cette opération combine sigmoïde et perte binaire de manière numériquement stable. Elle reçoit des logits : il ne faut pas lui appliquer une première sigmoïde « pour aider ».
Une sortie entre 0 et 1 reste un score probabiliste du modèle. Sa valeur ne prouve pas qu'une proportion identique de décisions sera correcte sur des documents réels.
Pourquoi calculer A/B et B/A ?
L'identité recherchée est symétrique : si A et B représentent le même document, B et A aussi. Pourtant, un modèle qui lit une séquence ordonnée peut donner deux logits différents selon l'ordre des fiches.
Le projet encode donc les deux orientations, puis moyenne leurs logits. Voici la fonction exacte :
def symmetric_logits(model, encoded_pairs, tokenizer):
    if not encoded_pairs:
        raise ValueError("Empty pair batch")
    oriented = [row["orientations"][side] for side in [0, 1] for row in encoded_pairs]
    batch = {
        k: v.cuda()
        for k, v in tokenizer.pad(oriented, padding=True, return_tensors="pt").items()
    }
    raw = model(**batch).squeeze(-1)
    count = len(encoded_pairs)
    return (raw[:count] + raw[count:]) / 2, raw[:count], raw[count:]
Commençons par oriented. La boucle parcourt d'abord side=0 pour toutes les paires, puis side=1 pour toutes les paires. Avec les paires A/B et C/D, l'ordre est A/B, C/D, B/A, D/C. Il n'est pas A/B, B/A, C/D, D/C. Cette organisation explique les deux tranches du retour.
tokenizer.pad(..., padding=True, return_tensors="pt") complète les séquences du lot à une longueur commune et produit des tenseurs PyTorch. Le padding est du remplissage technique, pas du contenu documentaire ; le masque d'attention permet de le distinguer des positions utiles. Le contrat du tokenizer détaille ces entrées. Chaque tenseur est ensuite transféré sur le GPU avec .cuda().
Le modèle du projet fournit un score par orientation. squeeze(-1) retire la dernière dimension de taille 1 : une sortie de forme [2B, 1] devient [2B], où B est le nombre de paires. Il ne faut pas confondre B paires avec 2B orientations.
Enfin, raw[:count] contient les logits directs et raw[count:] leurs inverses. Leur moyenne, terme à terme, redonne un score par paire. Les deux séries brutes sont également retournées pour l'inspection. Un lot vide provoque une erreur explicite.
Moyenne de logits et moyenne de probabilités ne sont pas interchangeables
Exemple illustratif, sans lien avec une sortie CamemBERT mesurée : supposons que les logits d'une paire soient 4 dans un sens et -2 dans l'autre. Leur moyenne vaut 1 ; sa sigmoïde vaut environ 0,7311.
Si nous appliquions d'abord les deux sigmoïdes, nous obtiendrions environ 0,9820 et 0,1192. Leur moyenne serait 0,5506, pas 0,7311. La différence vient de la transformation non linéaire. Pour reproduire le projet, il faut donc conserver la moyenne des logits, et non lui substituer une moyenne de probabilités.
Le score final est symétrique parce qu'échanger les deux logits ne change pas leur moyenne. Dans la preuve r001, l'erreur absolue de symétrie est nulle pour A-17/B-92. Cela vérifie une propriété du calcul, pas l'identité de toutes les fiches.
Cette propriété suppose aussi de comparer les mêmes évaluations des deux orientations. L'extrait ne passe pas lui-même le modèle en mode évaluation. En PyTorch, eval() agit notamment sur les modules dont le comportement diffère à l'entraînement, comme le dropout, qui désactive aléatoirement certaines valeurs pendant l'apprentissage. Le contexte d'appel reste donc important pour une comparaison reproductible.
Surtout, symétrie n'est pas transitivité. Des scores élevés pour A/B et B/C ne garantissent pas un score élevé pour A/C. C'est précisément ce que le regroupement doit traiter.
Calibrer, grouper et vérifier le veto
Choisir un seuil avant de regarder le test
Après l'entraînement, l'inférence produit les scores sans lire les labels. La calibration utilise ensuite la validation pour choisir le seuil, qui vaut 0,5 dans le parcours r001. Le test sert à mesurer la règle ainsi fixée, pas à choisir après coup la valeur qui rend le résultat le plus flatteur.
Ici, calibrer désigne le choix d'un seuil de décision. Cela ne suffit pas à démontrer une calibration probabiliste : un score de 0,9 ne devient pas, par cette seule opération, une garantie de 90 % de décisions correctes.
docker compose run --rm inference python -m ged_rapprochement_fiches.cli predict --config configs/minimum.yaml
docker compose run --rm learning python -m ged_rapprochement_fiches.cli calibrate --config configs/minimum.yaml
docker compose run --rm inference python -m ged_rapprochement_fiches.cli cluster --config configs/minimum.yaml
docker compose run --rm tutorial python -m ged_rapprochement_fiches.cli evaluate --config configs/minimum.yaml
predict produit les scores ; calibrate fixe la décision sur validation ; cluster construit les groupes ; evaluate confronte les propositions aux références. Conservez les étapes séparées pour pouvoir localiser une erreur : mauvais candidat, mauvais score ou mauvaise réunion de groupes.
Le piège des composantes connexes
La variante naïve représente chaque fiche par un nœud. Une paire acceptée devient une arête, un lien non orienté entre deux nœuds. Une composante connexe rassemble les fiches entre lesquelles on peut circuler en suivant ces liens, éventuellement par plusieurs intermédiaires. La documentation NetworkX donne cette définition ; elle ne signifie pas que cette bibliothèque est nécessaire au code du cours.
Exemple pédagogique : avec les liens A—B et B—C, les trois fiches appartiennent à la même composante, même sans lien A—C. Si B a été rapprochée à tort de C, la seule existence du chemin suffit à faire entrer C dans le groupe de A.
Le problème n'est donc pas que l'algorithme de composantes connexes calcule mal. Il applique exactement la règle qu'on lui a donnée. C'est cette règle qui peut être trop permissive pour l'identité documentaire.
Vérifier toutes les relations entre les groupes
La variante contrainte pose une question plus exigeante : peut-on réunir ces deux groupes sans créer de relation interdite ou insuffisamment justifiée entre leurs membres ?
Prenons deux groupes {A, B} et {C, D}. Vérifier seulement le lien B/C qui a suggéré la fusion ne suffit pas. Les paires croisées sont A/C, A/D, B/C et B/D : quatre vérifications. Plus généralement, réunir des groupes de m et n membres demande d'examiner m × n paires croisées.
Le garde-fou du projet est le suivant. Les fonctions auxiliaires, dont pair et cannot_link, font partie du code complet du ZIP.
def can_merge_clusters(left, right, records, get_score, threshold):
    crossed = sorted(pair(a, b) for a, b in product(left, right))
    # Trusted administrative conflicts veto the entire merge, before neural work.
    for a, b in crossed:
        if cannot_link(records[a], records[b]):
            return False, {"reason": "CANNOT_LINK", "pair": [a, b]}
    for a, b in crossed:
        value = get_score(a, b)
        if value is None:
            return False, {"reason": "REVIEW_UNSCORED", "pair": [a, b]}
        if value < threshold:
            return False, {
                "reason": "BELOW_THRESHOLD",
                "pair": [a, b],
                "probability": value,
            }
    return True, {"reason": "ALL_CROSS_PAIRS_PASSED", "cross_pairs": len(crossed)}
La première ligne construit toutes les paires croisées avec product(left, right), puis les met dans un ordre stable. Elle ne se limite ni aux représentants des groupes ni au lien qui a déclenché la proposition.
La première boucle cherche un veto administratif. Si cannot_link trouve deux références fiables incompatibles, l'union entière est refusée avec CANNOT_LINK. Comme cette boucle précède tous les appels à get_score, aucun score neuronal n'est demandé par cette fonction pour cette tentative, même si le conflit apparaît sur la dernière paire examinée.
Une référence manquante ou dont la fiabilité n'est pas confirmée ne déclenche pas ce veto à elle seule. Mais l'absence de veto n'est pas une preuve d'identité : il reste à passer les contrôles de score.
La seconde boucle exige un score pour chaque paire croisée. get_score(a, b) fournit la valeur disponible ; le parcours peut faire calculer des scores additionnels pour ces vérifications. Si la valeur reste None, la fonction renvoie REVIEW_UNSCORED. Elle ne transforme pas « non examiné » en « probablement identique ».
Si un score est strictement inférieur au seuil, l'union est refusée avec BELOW_THRESHOLD. Une valeur exactement égale au seuil passe ce contrôle, puisque la condition est value < threshold, et non value <= threshold.
Enfin, ALL_CROSS_PAIRS_PASSED signifie que toutes les vérifications croisées ont réussi. Ce n'est pas encore une modification de la GED : la fonction retourne un booléen et un diagnostic. Elle ne supprime aucun fichier et ne fusionne elle-même aucune donnée.
Ce que le contrôle garantit, et ce qu'il suppose
Petit test mental : trois des quatre paires croisées ont un score de 0,9, mais la quatrième reste non scorée. L'union doit être refusée, même si une moyenne des scores connus semblerait excellente. Même résultat avec une quatrième valeur de 0,4 et un seuil de 0,5. Ces nombres illustrent la règle ; ce ne sont pas des scores mesurés du modèle.
En partant de groupes déjà valides, vérifier toutes les nouvelles relations croisées permet de préserver leurs contraintes lors d'une union. Cela n'établit toutefois pas que chaque groupe correspond au bon document : des paires différentes peuvent toutes recevoir des scores élevés à tort, sans référence fiable pour les contredire.
L'extrait n'est pas non plus un validateur complet de ses entrées. Il suppose notamment des groupes non vides, des identifiants présents dans records et des scores numériques finis. Il ne vérifie pas lui-même ces propriétés. Par exemple, comparer NaN au seuil avec < ne déclenche pas le refus attendu pour un score trop faible. Cela décrit une limite de cette fonction isolée, pas le résultat d'un audit des contrôles amont du projet.
Enfin, vérifier une union locale ne recherche pas nécessairement la meilleure partition globale. Dans un exemple abstrait où A/B et B/C passent mais A/C échoue, réunir A/B en premier ou B/C en premier peut conduire à deux partitions différentes. Le tri des paires à l'intérieur de cette fonction stabilise leur inspection ; il ne prouve pas une indépendance de tout le regroupement à l'ordre des unions proposées.
Lire le test : la première perte arrive avant le modèle
Retrouver les comptes derrière les scores
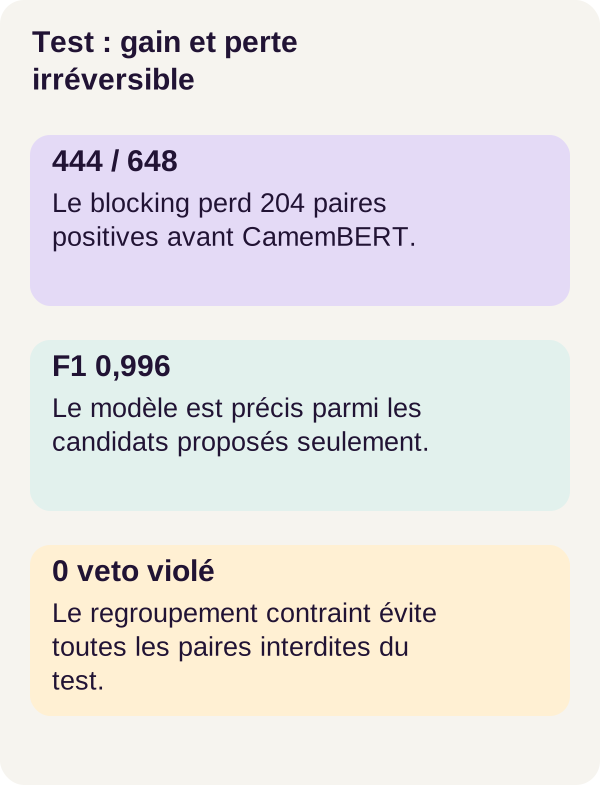
Sur les 648 fiches de test, le blocking conserve 918 paires parmi 209 628 possibles, soit environ 0,44 % des comparaisons initiales. C'est une forte réduction de travail pour le classifieur, mais elle a un coût en rappel.
Parmi les 648 paires positives attendues, seules 444 arrivent dans les candidats. Il en manque donc 204. Le rappel du blocking vaut 444 / 648 = 0,685185.
Sur ces 918 candidats, CamemBERT obtient 444 vrais positifs, 4 faux positifs et 0 faux négatif. Son rappel candidat vaut donc 1. Mais ce zéro faux négatif ne concerne que les paires reçues, pas celles que la présélection a écartées.
| Mesure des paires CamemBERT | Calcul sur les comptes publiés | Résultat |
|---|---|---|
| Précision | 444 / (444 + 4) |
0,991071 |
| Rappel candidat | 444 / (444 + 0) |
1,00 |
| F1 candidat | 2 × 444 / (2 × 444 + 4 + 0) |
0,995516 |
| Rappel de bout en bout | 444 / (444 + 204) |
0,685185 |
| F1 de bout en bout | 2 × 444 / (2 × 444 + 4 + 204) |
0,810219 |
Le changement de dénominateur explique tout l'écart : le modèle reconnaît les positives qu'on lui présente, mais la chaîne initiale de paires en a déjà perdu près d'un tiers. Ces 204 omissions ne se corrigent pas en entraînant plus longtemps le même classifieur sur une liste de candidats inchangée.
Les deux méthodes de référence donnent un F1 de bout en bout de 0,568502 pour Jaccard et 0,708373 pour la référence exacte. CamemBERT améliore donc cette mesure dans le protocole fourni, sans supprimer la perte du blocking.
Les éventuels scores additionnels du regroupement sont comptés à l'étape suivante. Il ne faut pas les intégrer rétroactivement aux 918 candidats pour annoncer un autre rappel initial : les deux mesures ne portent pas sur la même opération.
Conserver les versions ne suffit pas à former les bons groupes
Le regroupement naïf conserve les 648 versions, mais ses groupes contiennent 16 paires interdites et sur-fusionnent 6 documents logiques. Son B-cubed F1 vaut 0,908720. Un faux lien de paire peut donc avoir des conséquences au-delà de ses deux extrémités, en reliant des groupes entiers.
Le regroupement contraint conserve lui aussi les 648 versions, produit 295 groupes, et ne contient aucune paire interdite ni aucun document sur-fusionné dans ce test. Sa précision B-cubed vaut 1,00, son rappel 0,842593 et son F1 0,914573.
Pourquoi le rappel reste-t-il inférieur à 1 si la précision est parfaite ? Parce que les groupes proposés ne mélangent plus les identités, mais certains restent incomplets : des fiches d'un même document demeurent séparées. À l'inverse, le fait de conserver toutes les versions signifie seulement qu'aucune n'a disparu des sorties, pas que chacune est avec tous les bons compagnons.
On retrouve le F1 contraint avec 2 × 1 × 0,842593 / (1 + 0,842593), soit environ 0,914573. Le rappel B-cubed n'est pas le rappel des paires : il moyenne les compagnons retrouvés autour de chaque fiche, et ne doit pas être confondu avec 0,685185.
Le coût et les limites restent visibles
Le contrôle demande 51 paires supplémentaires sur le test, pour un budget prévu de 20 000. Ces calculs servent à vérifier les unions envisagées ; ils n'équivalent pas à relancer une recherche exhaustive de toutes les paires manquantes. La fragmentation des groupes reste visible dans le rappel B-cubed.
La durée observée du regroupement inclut l'inférence de ces paires supplémentaires. Les éléments présentés ne donnent pas de durée chiffrée à reprendre ici, et ce parcours ne justifie aucune extrapolation de débit. Doubler la taille de la GED ne signifie pas nécessairement doubler ce coût : le nombre de candidats et la taille des groupes interviennent aussi.
Les résultats portent sur un corpus synthétique, avec des références et formulations fortement structurées, une graine et une machine. La graine fixe les tirages pseudo-aléatoires de l'expérience ; une seule exécution ainsi définie ne mesure pas la variabilité entre plusieurs entraînements. Aucune validation métier ni étude de lecteurs humains n'est fournie.
Le résultat à retenir est donc double : le modèle améliore les décisions de paires dans ce protocole ; le veto empêche les sur-fusions observées, sans rendre tous les groupes complets.
Exercice : prédire une fusion transitive trompeuse
Votre prédiction avant la commande
Reprenons les quatre fiches du début. A-17, B-92 et D-40 concernent VC-204, D-40 étant sa version 2. C-11 concerne VC-205. Le modèle donne pourtant des scores élevés à toutes les paires, y compris A-17/C-11.
Avant d'exécuter, prédisez le nombre de groupes qu'obtiendra une composante connexe naïve. Puis imaginez que le veto soit vérifié sur toutes les paires croisées : peut-on ajouter C-11 à un groupe contenant déjà A-17 simplement parce que C-11 ressemble à B-92 ? Enfin, que doit devenir le fichier de la version 2 ?
Écrivez vos réponses, puis lancez l'exercice :
docker compose run --rm tutorial python -m ged_rapprochement_fiches.cli exercise --config configs/minimum.yaml
La commande crée ces quatre fiches et calcule leurs scores réels avec le modèle. Les nombres pédagogiques utilisés plus haut pour expliquer les logits et les contrôles ne sont pas les scores de cette exécution. De même, les éventuels contre-exemples mathématiques signalés comme illustratifs dans les figures ne doivent pas être confondus avec les sorties CamemBERT.
Ce que montre la correction r001
La variante naïve réunit A-17, B-92, C-11 et D-40 dans un seul groupe. Elle garde les quatre versions, mais compte 2 paires interdites et 2 documents logiques sur-fusionnés, avec un B-cubed F1 de 0,769231.
La variante contrainte forme deux groupes : {A-17, B-92, D-40} et {C-11}. Elle conserve les quatre versions, ne compte aucune paire interdite et obtient B-cubed F1 = 1,00.
Le veto mis en évidence est A-17/C-11, dont les références fiables sont incompatibles. B-92 porte bien VC-204, mais sa fiabilité n'est pas confirmée. Elle ne doit pas devenir un intermédiaire permettant de faire entrer C-11 dans le groupe de A-17. C'est toute la différence entre vérifier le dernier lien ajouté et vérifier l'union des groupes.
Refaire B-cubed à la main
Pour comprendre le F1 naïf, oublions un instant le réseau et regardons seulement les ensembles. Les groupes de référence sont {A-17, B-92, D-40} et {C-11} ; le groupe proposé contient tout le monde.
Pour chacune des trois fiches de VC-204, les trois bons membres sont présents parmi quatre : précision locale 3/4, rappel local 3/3 = 1. Pour C-11, un seul membre sur quatre est correct : précision locale 1/4, rappel local 1/1 = 1.
La précision moyenne vaut donc (3/4 + 3/4 + 3/4 + 1/4) / 4 = 0,625. Le rappel moyen vaut 1. Le F1 calculé à partir de ces deux moyennes est 2 × 0,625 × 1 / (0,625 + 1) = 0,769231 après arrondi, ce qui retrouve la valeur publiée.
Le rappel parfait du groupe naïf n'est pas une réussite suffisante : tous les bons compagnons sont présents, mais les intrus aussi. Avec les deux groupes corrects, précision et rappel locaux valent 1 pour chaque fiche.
Une variante à prédire sans modifier le parcours de référence
Pour vérifier votre compréhension, imaginez que la fiabilité de la référence de C-11 ne soit plus confirmée, sans changer les scores élevés. Le veto fondé sur deux références fiables pourrait-il encore bloquer à lui seul le rapprochement A-17/C-11 ? Non : son hypothèse de départ ne serait plus satisfaite. Les contrôles de score resteraient nécessaires, mais ne constitueraient toujours pas une preuve d'identité.
Il s'agit d'une variante de raisonnement, non exécutée dans les résultats publiés. Elle montre pourquoi la définition de « fiable » doit venir d'une politique métier, pas de la confiance du modèle dans son propre score.
Dans l'exercice fourni, comme dans le parcours principal, la sortie reste PROPOSITION_A_CONFIRMER. Aucun original n'est supprimé. Un groupe suggéré est un résultat à examiner, pas une autorisation d'effacer un doublon présumé.
Figures, jalons et nettoyage
Inspecter avant d'effacer
Lisez outputs/evaluation.json, outputs/groups.json, outputs/grouping.json et outputs/exercise.json. Passez du score global à un groupe précis : retrouvez ses membres, les versions conservées et les raisons qui ont empêché certaines unions.
Produisez ensuite les figures et contrôlez les jalons du cours :
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
Ces jalons vérifient le matériel pédagogique attendu. Ils complètent l'évaluation, sans transformer une proposition en validation administrative.
Conservez les sorties utiles avant la suite. Le nettoyage respecte cet ordre exact :
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Le premier down précède volontairement le lancement du nettoyage ; le second termine le parcours. clean --outputs-only affiche puis supprime uniquement outputs/, sans toucher aux fiches, aux fichiers, au corpus ni aux checkpoints. Il ne faut donc pas le lancer avant d'avoir lu ou copié les résultats que vous souhaitez garder.
En cas de problème, remonter à l'étape concernée
Si le contrôle GPU échoue, reprenez le diagnostic de l'environnement Docker : la présence de la carte dans Linux ne remplace pas le calcul conteneurisé. Si l'acquisition échoue, vérifiez le téléchargement, les tailles et les empreintes attendues plutôt que de substituer un modèle trouvé ailleurs.
Si le rappel est faible, cherchez d'abord si les bonnes paires figurent dans les candidats. Si une union est refusée, lisez sa raison : CANNOT_LINK, REVIEW_UNSCORED et BELOW_THRESHOLD correspondent à trois situations différentes. Augmenter un score ne résout pas un conflit administratif fiable ; inventer un score ne résout pas une paire non examinée.
Du tutoriel à une GED réelle
Avant une adaptation, définissez avec les équipes métier ce qu'est un même document logique, ce qui distingue une version d'un document voisin et quelles références sont réellement fiables. Le veto dépend de ces choix : une information erronée déclarée fiable peut empêcher un rapprochement utile.
Mesurez le rappel du blocking sur des données autorisées et annotées. Examinez séparément les références absentes, les titres répétitifs et les variations de formulation, au lieu de vous contenter du F1 des seuls candidats. Ce sont des pistes d'évaluation pour une application réelle, pas de nouvelles populations déjà validées par ce tutoriel.
Versionnez les propositions et conservez leurs membres, scores, règles et raisons de refus. Orientez les cas non scorés ou ambigus vers une revue, et séparez cette revue de toute action sur les fichiers. Les droits documentaires et les règles de conservation doivent continuer à s'appliquer ; appartenir à un groupe proposé ne donne pas de nouveaux droits.
Le mécanisme appris tient en trois distinctions : présélectionner n'est pas reconnaître, reconnaître une paire n'est pas valider un groupe, proposer un groupe n'est pas fusionner ses fichiers. Le veto bloque une incompatibilité définie à l'avance ; son absence ne certifie pas l'identité d'un document.
Téléchargez le cours : ZIP r001.
Les documentations liées dans l'article approfondissent les concepts. Les extraits, commandes et résultats du parcours restent ceux de la révision r001. Les petits calculs explicitement pédagogiques expliquent ces mécanismes sans constituer de nouvelles mesures du modèle.