





Immaginate una schermata di back office che mostra più schede per quello che sembra essere lo stesso documento. I titoli si somigliano, i riferimenti non sono sempre compilati con la stessa affidabilità e alcune schede corrispondono a versioni diverse. Vorreste proporre un raggruppamento per rendere più semplice la navigazione. Ma certamente non cancellare una versione utile né riunire due documenti distinti perché condividono alcune parole.
È il problema che esploreremo con quattro schede fittizie. A-17 e B-92 descrivono il documento logico VC-204; D-40 ne è la versione 2. C-11 descrive VC-205, con un titolo quasi identico. Il raggruppamento previsto mantiene insieme A-17, B-92 e D-40, lasciando C-11 separata.
La parola logico è importante: qui indica l'identità documentale a cui si riferiscono più schede e versioni. Non significa che i loro file siano identici byte per byte. Raggruppare le schede non significa fondere i loro file. In questo tutorial, ogni file e ogni versione restano conservati; il programma produce una proposta, senza aggiornare la GED, la gestione elettronica dei documenti.
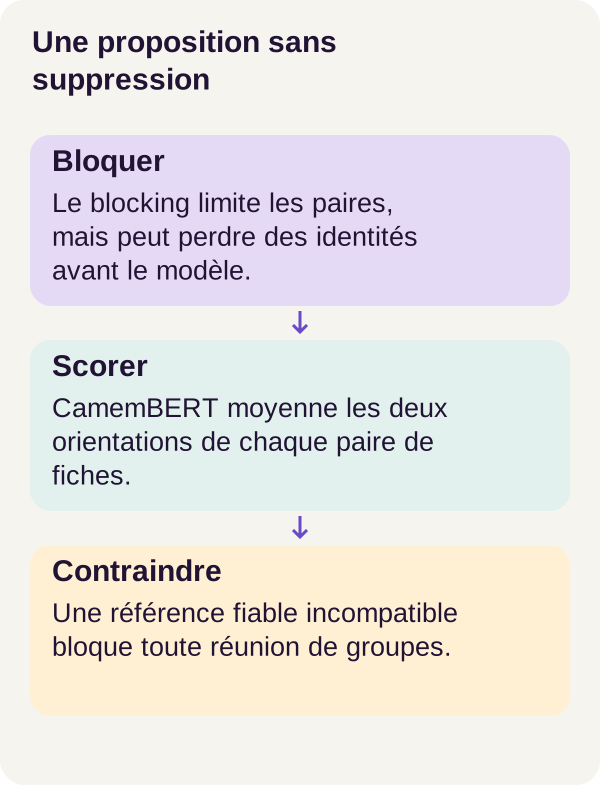
Costruiremo la seguente catena: schede → coppie candidate → punteggi CamemBERT → decisioni alla soglia → gruppi proposti e controllati. Un primo filtro riduce il numero di confronti. Un modello impara poi a esaminare insieme due schede. Infine, del codice verifica che un raggruppamento non aggiri un conflitto amministrativo affidabile.
Lo scopo del percorso è capire dove interviene ogni elemento, quindi misurare ciò che apporta. Un classificatore eccellente non ritrova automaticamente i candidati dimenticati dal filtro. E alcune coppie errate possono bastare a formare un gruppo decisamente troppo ampio.
Misurare separatamente le fasi
Il blocking: scegliere i confronti, non ancora le risposte
Confrontare tutte le schede a due a due sembra semplice. Ma per n schede bisogna esaminare n × (n - 1) / 2 coppie distinte: non si confronta una scheda con sé stessa e non si contano due volte A/B e B/A.
Con sole 648 schede, questo porta già a 209 628 coppie. Il blocking è una preselezione: conserva un insieme più piccolo di coppie che meritano un esame approfondito. Per uno sviluppatore web, pensatelo come una prima selezione di candidati prima di un trattamento costoso, non come una decisione definitiva di identità.
Esempio didattico, distinto dalle regole dello ZIP: se confrontassimo soltanto le schede con esattamente lo stesso riferimento, un riferimento assente o inserito male potrebbe impedire a due schede dello stesso documento di incontrarsi. Il modello posto dopo questo filtro non avrebbe allora l'occasione di riconoscerle. La documentazione del Python Record Linkage Toolkit sull'indicizzazione presenta questo principio di riduzione delle coppie; non descrive le regole specifiche del nostro progetto.
Nel percorso r001, il raggruppamento vincolato può richiedere punteggi aggiuntivi per verificare un'unione proposta. Distingueremo quindi i candidati del primo filtro e i confronti di controllo aggiunti durante il raggruppamento. Questi ultimi non costituiscono una nuova ricerca esaustiva tra tutte le schede.
Un modello che legge insieme le due schede
CamemBERT è un modello linguistico preaddestrato sul francese. Un tokenizer suddivide il testo in unità chiamate token, talvolta più piccole di una parola. Il modello trasforma queste unità in embedding: vettori, cioè elenchi di numeri, che rappresentano il testo tenendo conto del suo contesto. La documentazione ufficiale di CamemBERT descrive in particolare il suo impiego per classificare testi e coppie di sequenze.
Qui utilizziamo un cross-encoder: le due schede vengono presentate insieme al modello, che produce un punteggio per la loro coppia. Il testo della prima può così essere messo in relazione con quello della seconda durante il calcolo. Non è la stessa operazione che calcolare un vettore indipendente per scheda, memorizzarlo e poi confrontare questi vettori.
Il vantaggio cercato è un esame congiunto dei campi. Il rovescio della medaglia è il costo: una nuova coppia richiede un nuovo calcolo del modello. La documentazione Sentence Transformers sui cross-encoder spiega questa distinzione. Serve qui a comprendere l'architettura, non ad aggiungere una libreria o un altro modello al percorso.
L'apprendimento è supervisionato: un obiettivo vale 1 quando le due schede descrivono lo stesso documento logico, 0 altrimenti. Una coppia positiva non significa quindi necessariamente «due copie identiche dello stesso file». La versione 2 di un documento può appartenere allo stesso gruppo della sua versione precedente.
Il corpus sintetico contiene 4 320 schede per 1 440 documenti logici, di cui 648 schede nel test. Le identità di riferimento, spesso chiamate gold, permettono di sapere quali coppie e gruppi sono attesi. Servono per apprendere o valutare secondo la partizione, mai per fornire direttamente la risposta durante l'inferenza.
Precisione e richiamo: di quali coppie parliamo?
Un vero positivo è una coppia proposta come identica che lo è davvero nel riferimento. Un falso positivo riunisce erroneamente due documenti distinti. Un falso negativo è una coppia positiva attesa che il sistema non ritrova.
La precisione risponde a «tra i raggruppamenti proposti, quanti sono corretti?». Il richiamo risponde a «tra i raggruppamenti attesi, quanti ne abbiamo ritrovati?». L'F1 combina entrambi con una media armonica: 2 × precisione × richiamo / (precisione + richiamo).
Useremo tre misure complementari:
| Misura | Calcolo | Domanda posta |
|---|---|---|
| Richiamo del blocking | Positive candidate / tutte le positive attese | Il primo filtro conserva i confronti giusti? |
| Richiamo candidato del classificatore | Veri positivi / positive tra i candidati | Il modello riconosce le coppie giuste che riceve? |
| Richiamo end-to-end delle coppie | Veri positivi / tutte le positive attese | Che cosa ritrova la catena di preselezione e classificazione? |
Esempio didattico: sono attese dieci coppie positive, il filtro ne conserva sette e il modello riconosce queste sette senza errore. Il suo richiamo candidato vale 7/7 = 1, ma il richiamo end-to-end vale 7/10 = 0,7. Non c'è alcuna contraddizione: i denominatori sono diversi.
Più in generale, per questa catena di coppie, il richiamo end-to-end è il prodotto del richiamo del blocking e del richiamo candidato. Migliorare soltanto il classificatore non elimina quindi il limite imposto dalla preselezione.
B-cubed: osservare i compagni di ogni scheda
Dopo le coppie arrivano i gruppi, o cluster. Il punteggio B-cubed osserva, per ogni scheda, il suo gruppo proposto e il suo gruppo di riferimento. I membri comuni sono i compagni correttamente mantenuti insieme, scheda stessa compresa.
La precisione locale divide questo numero di membri comuni per la dimensione del gruppo proposto. Diminuisce se vi aggiungiamo degli intrusi. Il richiamo locale lo divide per la dimensione del gruppo atteso. Diminuisce se lasciamo fuori membri dello stesso documento.
Esempio didattico: una scheda dovrebbe stare con altre due, quindi in un gruppo atteso di tre membri. Il gruppo proposto contiene due membri corretti e un intruso. Per questa scheda, precisione e richiamo B-cubed valgono entrambi 2/3. Il calcolo si ripete per ogni scheda, poi si fa la media di precisioni e richiami. Calcoleremo l'F1 di queste due medie: questa convenzione ritrova i valori pubblicati nel percorso, come mostrerà l'esempio a quattro schede.
Una strategia che lascia tutti da soli evita gruppi troppo ampi, ma perde i raggruppamenti attesi. Al contrario, un solo gruppo enorme ritrova tutti i compagni attesi aggiungendo però molti intrusi. Ecco perché precisione e richiamo devono essere letti insieme.
Infine, un cannot-link è un veto esplicito: in questo progetto, due riferimenti affidabili, non vuoti e diversi non devono appartenere allo stesso gruppo. Una scheda da sola forma un singleton; non viene eliminata. Misureremo separatamente la qualità dei gruppi, il numero di coppie vietate che contengono e la conservazione delle versioni.
Preparare il lettore GPU
Cosa serve prima di iniziare
Dovete saper leggere Python, usare un terminale e avviare Docker. Le basi di PyTorch, della classificazione supervisionata e dei grafi sono utili; spiegheremo le operazioni che compaiono negli estratti. Un tensore è qui una tabella numerica, e un grafo un insieme di schede collegate da raggruppamenti proposti.
Il profilo di riferimento è Linux con una RTX 3090 da 24 GiB, 24 GiB di RAM e 30 GiB di spazio di lavoro su disco, a cui si aggiunge lo spazio Docker. La memoria della scheda grafica e la RAM della macchina sono due risorse distinte. Queste indicazioni non garantiscono né una durata né la capacità di qualsiasi altra configurazione. I risultati presentati provengono dal percorso GPU r001; non costituiscono una convalida su CPU.
Decomprimete lo ZIP del corso, disponibile alla fine dell'articolo, e aprite un terminale nella sua radice. Tutti i comandi seguenti vanno eseguiti da questa directory, nell'ordine indicato. Le versioni e le impostazioni da riprodurre sono quelle dell'archivio.
Una GPU visibile sull'host non basta: Docker deve potervi accedere. NVIDIA Container Toolkit fornisce l'integrazione necessaria. Se manca, la diagnostica del progetto indica l'azione attesa senza installare nulla in silenzio. GPU_DEVICE=1 consente di selezionare un'altra scheda prima del percorso.
Controllare, costruire e acquisire le risorse
Iniziamo con i controlli preliminari, la preparazione e la costruzione dei servizi.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial learning inference
Il preflight controlla Docker, Compose, RAM, disco e GPU. docker compose config --quiet riesce senza visualizzare contenuto quando la configurazione è valida. Ogni fase deve terminare senza errori prima della successiva.
L'acquisizione recupera quindi le sei risorse CamemBERT previste dal progetto.
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
La loro dimensione e impronta SHA-256 vengono verificate prima di una sostituzione atomica: i file validati prendono il posto previsto senza pubblicare una copia parziale come se fosse completa. L'impronta controlla l'identità dei byte attesi, non la pertinenza delle future previsioni. Nessuna cache privata è distribuita nell'archivio.
Verifichiamo ora l'ambiente dal container, poi i test del progetto.
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
Il controllo dell'ambiente esegue davvero un calcolo da Docker. I test esaminano in particolare i conflitti, la simmetria e la conservazione delle versioni. Verificano comportamenti del programma; non dimostrano che ogni raggruppamento aziendale sarà corretto. Verificate che l'esecuzione termini senza fallimenti e conservatene il resoconto.
Generare schede, candidati e un punteggio simmetrico
Separare gli input dalle risposte attese
La preparazione colloca le schede e i loro file fittizi in data/generated/input/. Le identità gold restano in labels/. Il container learning monta soltanto le coppie di apprendimento e validazione; inference non monta alcuna annotazione.
L'idea è simile a un esercizio la cui soluzione resta chiusa mentre rispondete. Il modello deve usare i campi osservabili, non leggere l'identità gold della coppia che deve classificare.
docker compose run --rm tutorial python -m ged_rapprochement_fiches.cli prepare --config configs/minimum.yaml
docker compose run --rm tutorial python -m ged_rapprochement_fiches.cli baseline --config configs/minimum.yaml
docker compose run --rm inference python -m ged_rapprochement_fiches.cli inspect-mechanism --config configs/minimum.yaml
prepare genera i dati. baseline produce metodi di riferimento semplici con cui confrontare il modello. Tra questi, il riferimento esatto usa un segnale di uguaglianza; Jaccard misura una sovrapposizione lessicale. Il principio di Jaccard è «elementi comuni / elementi presenti in almeno uno dei due insiemi». Le regole esatte per preparare gli insiemi restano quelle dello ZIP.
inspect-mechanism mostra i campi serializzati e la simmetria. Serializzare significa trasformare i campi di una scheda in un input testuale organizzato. Il progetto trasmette il riferimento, la sua affidabilità, il titolo, la pratica, il testo e la versione. Il campo di affidabilità non è superfluo: leggere un riferimento e sapere che è degno di fiducia sono due informazioni diverse.
Osservate questa rappresentazione prima dell'addestramento. Un'ispezione didattica rende il calcolo leggibile; non deve essere presentata come un punteggio aggregato sul test.
Addestrare, interrompere e riprendere
L'addestramento regola i parametri appresi a partire da coppie annotate. L'inferenza, invece, usa i parametri ottenuti per assegnare punteggi a nuove coppie.
docker compose run --rm learning python -m ged_rapprochement_fiches.cli train --config configs/minimum.yaml --mode interrupt
docker compose run --rm learning python -m ged_rapprochement_fiches.cli train --config configs/minimum.yaml --mode continuous
docker compose run --rm learning python -m ged_rapprochement_fiches.cli train --config configs/minimum.yaml --mode resume
docker compose run --rm learning python -m ged_rapprochement_fiches.cli verify-resume --config configs/minimum.yaml
Il percorso distingue un'esecuzione interrotta, un'esecuzione continua e una ripresa. Un checkpoint è uno stato salvato che consente di proseguire un calcolo; una ripresa non è un nuovo addestramento arbitrario sugli stessi file. verify-resume controlla la coerenza del percorso ripreso con quello continuo. Questo controllo di riproduzione non sostituisce la valutazione su schede sconosciute.
Per esaminare il budget di addestramento, l'ottimizzatore e i dettagli del ripristino, consultate configs/minimum.yaml e il codice fornito. Conservate queste impostazioni durante la riproduzione di riferimento, prima di sperimentare in una copia separata.
Dal logit alla decisione
Il modello produce un logit, un punteggio grezzo che può essere positivo, negativo o nullo. La sigmoide trasforma questo punteggio in un valore tra 0 e 1: sigmoide(z) = 1 / (1 + exp(-z)).
Durante l'apprendimento, la perdita, o loss, misura la distanza tra la previsione e l'obiettivo. Per comprendere l'entropia incrociata binaria senza ponderazione, ricordate due casi: se l'obiettivo vale 1, l'errore è -log(p); se vale 0, è -log(1-p). Dare quindi un'elevata fiducia al risultato sbagliato costa caro.
Esempio numerico didattico: per una coppia realmente positiva, p = 0,9 dà una perdita di circa 0,1054, contro 2,3026 con p = 0,1. L'apprendimento usa questo segnale per regolare i parametri; non scrive una regola testuale a partire da ogni esempio.
La documentazione di BCEWithLogitsLoss, disponibile anche nella documentazione di riferimento PyTorch 2.8, precisa che questa operazione combina sigmoide e perdita binaria in modo numericamente stabile. Riceve logits: non bisogna applicarle prima una sigmoide «per aiutarla».
Un output tra 0 e 1 resta un punteggio probabilistico del modello. Il suo valore non dimostra che una proporzione identica di decisioni sarà corretta su documenti reali.
Perché calcolare A/B e B/A?
L'identità cercata è simmetrica: se A e B rappresentano lo stesso documento, anche B e A lo rappresentano. Eppure, un modello che legge una sequenza ordinata può produrre due logits diversi secondo l'ordine delle schede.
Il progetto codifica quindi i due orientamenti, poi ne fa la media dei logits. Ecco la funzione esatta:
def symmetric_logits(model, encoded_pairs, tokenizer):
    if not encoded_pairs:
        raise ValueError("Empty pair batch")
    oriented = [row["orientations"][side] for side in [0, 1] for row in encoded_pairs]
    batch = {
        k: v.cuda()
        for k, v in tokenizer.pad(oriented, padding=True, return_tensors="pt").items()
    }
    raw = model(**batch).squeeze(-1)
    count = len(encoded_pairs)
    return (raw[:count] + raw[count:]) / 2, raw[:count], raw[count:]
Cominciamo da oriented. Il ciclo percorre prima side=0 per tutte le coppie, poi side=1 per tutte le coppie. Con le coppie A/B e C/D, l'ordine è A/B, C/D, B/A, D/C. Non è A/B, B/A, C/D, D/C. Questa organizzazione spiega le due sezioni del valore restituito.
tokenizer.pad(..., padding=True, return_tensors="pt") completa le sequenze del lotto a una lunghezza comune e produce tensori PyTorch. Il padding è riempimento tecnico, non contenuto documentale; la maschera di attenzione permette di distinguerlo dalle posizioni utili. Il contratto del tokenizer dettaglia questi input. Ogni tensore viene poi trasferito sulla GPU con .cuda().
Il modello del progetto fornisce un punteggio per orientamento. squeeze(-1) rimuove l'ultima dimensione di dimensione 1: un output di forma [2B, 1] diventa [2B], dove B è il numero di coppie. Non bisogna confondere B coppie con 2B orientamenti.
Infine, raw[:count] contiene i logits diretti e raw[count:] quelli inversi. La loro media, termine per termine, restituisce un punteggio per coppia. Le due serie grezze sono anch'esse restituite per l'ispezione. Un lotto vuoto genera un errore esplicito.
Media dei logits e media delle probabilità non sono intercambiabili
Esempio illustrativo, senza legame con un output CamemBERT misurato: supponiamo che i logits di una coppia siano 4 in un senso e -2 nell'altro. La loro media vale 1; la sua sigmoide vale circa 0,7311.
Se applicassimo prima le due sigmoidi, otterremmo circa 0,9820 e 0,1192. La loro media sarebbe 0,5506, non 0,7311. La differenza deriva dalla trasformazione non lineare. Per riprodurre il progetto, bisogna quindi conservare la media dei logits, non sostituirla con una media delle probabilità.
Il punteggio finale è simmetrico perché scambiare i due logits non ne cambia la media. Nella prova r001, l'errore assoluto di simmetria è nullo per A-17/B-92. Ciò verifica una proprietà del calcolo, non l'identità di tutte le schede.
Questa proprietà presuppone anche di confrontare le stesse valutazioni dei due orientamenti. L'estratto non mette da solo il modello in modalità valutazione. In PyTorch, eval() agisce in particolare sui moduli il cui comportamento differisce durante l'addestramento, come il dropout, che disattiva casualmente alcuni valori durante l'apprendimento. Il contesto della chiamata resta quindi importante per un confronto riproducibile.
Soprattutto, simmetria non significa transitività. Punteggi alti per A/B e B/C non garantiscono un punteggio alto per A/C. È precisamente ciò che il raggruppamento deve gestire.
Calibrare, raggruppare e verificare il veto
Scegliere una soglia prima di guardare il test
Dopo l'addestramento, l'inferenza produce i punteggi senza leggere le etichette. La calibrazione usa poi la validazione per scegliere la soglia, che vale 0,5 nel percorso r001. Il test serve a misurare questa regola già fissata, non a scegliere a posteriori il valore che rende il risultato più lusinghiero.
Qui, calibrare indica la scelta di una soglia decisionale. Questo non basta a dimostrare una calibrazione probabilistica: un punteggio di 0,9 non diventa, con questa sola operazione, una garanzia del 90% di decisioni corrette.
docker compose run --rm inference python -m ged_rapprochement_fiches.cli predict --config configs/minimum.yaml
docker compose run --rm learning python -m ged_rapprochement_fiches.cli calibrate --config configs/minimum.yaml
docker compose run --rm inference python -m ged_rapprochement_fiches.cli cluster --config configs/minimum.yaml
docker compose run --rm tutorial python -m ged_rapprochement_fiches.cli evaluate --config configs/minimum.yaml
predict produce i punteggi; calibrate fissa la decisione sulla validazione; cluster costruisce i gruppi; evaluate confronta le proposte con i riferimenti. Mantenete le fasi separate per poter localizzare un errore: candidato errato, punteggio errato o unione errata di gruppi.
La trappola delle componenti connesse
La variante ingenua rappresenta ogni scheda con un nodo. Una coppia accettata diventa un arco, un collegamento non orientato tra due nodi. Una componente connessa riunisce le schede tra cui è possibile spostarsi seguendo questi collegamenti, anche attraverso più intermediari. La documentazione NetworkX fornisce questa definizione; non significa che questa libreria sia necessaria al codice del corso.
Esempio didattico: con i collegamenti A—B e B—C, le tre schede appartengono alla stessa componente, anche senza collegamento A—C. Se B è stata avvicinata erroneamente a C, la sola esistenza del percorso basta per far entrare C nel gruppo di A.
Il problema non è quindi che l'algoritmo delle componenti connesse calcoli male. Applica esattamente la regola che gli è stata data. È questa regola a poter essere troppo permissiva per l'identità documentale.
Verificare tutte le relazioni tra i gruppi
La variante vincolata pone una domanda più esigente: possiamo riunire questi due gruppi senza creare una relazione vietata o insufficientemente giustificata tra i loro membri?
Prendiamo due gruppi {A, B} e {C, D}. Verificare soltanto il collegamento B/C che ha suggerito la fusione non basta. Le coppie incrociate sono A/C, A/D, B/C e B/D: quattro verifiche. Più in generale, riunire gruppi di m e n membri richiede di esaminare m × n coppie incrociate.
La protezione del progetto è la seguente. Le funzioni ausiliarie, tra cui pair e cannot_link, fanno parte del codice completo dello ZIP.
def can_merge_clusters(left, right, records, get_score, threshold):
    crossed = sorted(pair(a, b) for a, b in product(left, right))
    # Trusted administrative conflicts veto the entire merge, before neural work.
    for a, b in crossed:
        if cannot_link(records[a], records[b]):
            return False, {"reason": "CANNOT_LINK", "pair": [a, b]}
    for a, b in crossed:
        value = get_score(a, b)
        if value is None:
            return False, {"reason": "REVIEW_UNSCORED", "pair": [a, b]}
        if value < threshold:
            return False, {
                "reason": "BELOW_THRESHOLD",
                "pair": [a, b],
                "probability": value,
            }
    return True, {"reason": "ALL_CROSS_PAIRS_PASSED", "cross_pairs": len(crossed)}
La prima riga costruisce tutte le coppie incrociate con product(left, right), poi le ordina in modo stabile. Non si limita né ai rappresentanti dei gruppi né al collegamento che ha attivato la proposta.
Il primo ciclo cerca un veto amministrativo. Se cannot_link trova due riferimenti affidabili incompatibili, l'intera unione viene rifiutata con CANNOT_LINK. Poiché questo ciclo precede tutte le chiamate a get_score, questa funzione non richiede alcun punteggio neurale per questo tentativo, anche se il conflitto appare sull'ultima coppia esaminata.
Un riferimento mancante o la cui affidabilità non è confermata non attiva da solo questo veto. Ma l'assenza di veto non è una prova di identità: restano da superare i controlli del punteggio.
Il secondo ciclo esige un punteggio per ogni coppia incrociata. get_score(a, b) fornisce il valore disponibile; il percorso può far calcolare punteggi aggiuntivi per queste verifiche. Se il valore resta None, la funzione restituisce REVIEW_UNSCORED. Non trasforma «non esaminato» in «probabilmente identico».
Se un punteggio è strettamente inferiore alla soglia, l'unione viene rifiutata con BELOW_THRESHOLD. Un valore esattamente uguale alla soglia supera questo controllo, poiché la condizione è value < threshold, non value <= threshold.
Infine, ALL_CROSS_PAIRS_PASSED significa che tutte le verifiche incrociate hanno avuto successo. Non è ancora una modifica della GED: la funzione restituisce un booleano e una diagnosi. Non elimina alcun file né fonde direttamente alcun dato.
Cosa garantisce il controllo e cosa presuppone
Piccolo test mentale: tre delle quattro coppie incrociate hanno un punteggio di 0,9, ma la quarta resta senza punteggio. L'unione deve essere rifiutata, anche se una media dei punteggi noti sembrerebbe eccellente. Stesso risultato con un quarto valore di 0,4 e una soglia di 0,5. Questi numeri illustrano la regola; non sono punteggi misurati dal modello.
Partendo da gruppi già validi, verificare tutte le nuove relazioni incrociate permette di preservarne i vincoli durante un'unione. Ciò non stabilisce tuttavia che ogni gruppo corrisponda al documento giusto: coppie diverse possono tutte ricevere per errore punteggi alti, senza un riferimento affidabile che le contraddica.
L'estratto non è nemmeno un validatore completo dei propri input. Presuppone in particolare gruppi non vuoti, identificativi presenti in records e punteggi numerici finiti. Non verifica da solo queste proprietà. Per esempio, confrontare NaN con la soglia tramite < non attiva il rifiuto previsto per un punteggio troppo basso. Ciò descrive un limite di questa funzione isolata, non il risultato di un audit dei controlli a monte del progetto.
Infine, verificare un'unione locale non cerca necessariamente la migliore partizione globale. In un esempio astratto in cui A/B e B/C passano ma A/C fallisce, riunire prima A/B o B/C può portare a due partizioni diverse. L'ordinamento delle coppie all'interno di questa funzione ne stabilizza l'ispezione; non dimostra l'indipendenza dell'intero raggruppamento dall'ordine delle unioni proposte.
Leggere il test: la prima perdita avviene prima del modello
Ritrovare i conteggi dietro i punteggi
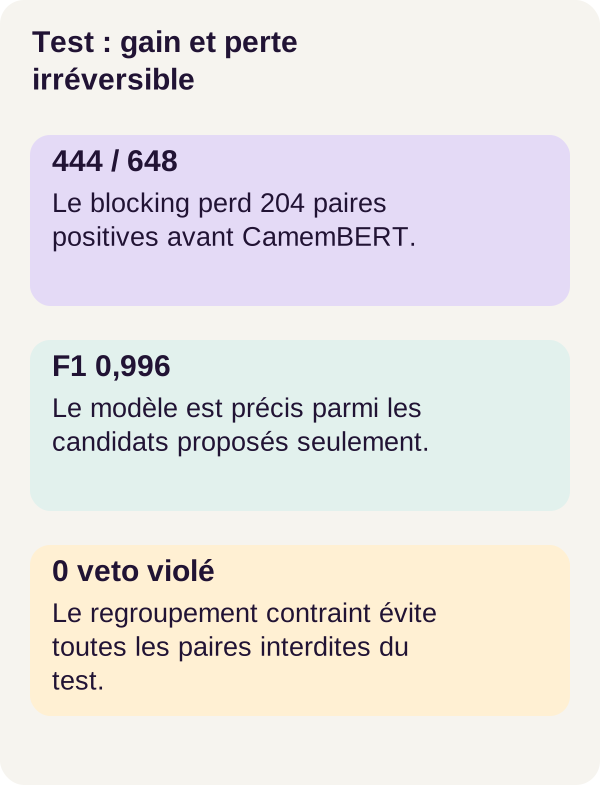
Sulle 648 schede di test, il blocking conserva 918 coppie tra 209 628 possibili, cioè circa lo 0,44% dei confronti iniziali. È una forte riduzione del lavoro per il classificatore, ma ha un costo in richiamo.
Tra le 648 coppie positive attese, solo 444 arrivano tra i candidati. Ne mancano quindi 204. Il richiamo del blocking vale 444 / 648 = 0,685185.
Su questi 918 candidati, CamemBERT ottiene 444 veri positivi, 4 falsi positivi e 0 falsi negativi. Il suo richiamo candidato vale quindi 1. Ma questi zero falsi negativi riguardano solo le coppie ricevute, non quelle scartate dalla preselezione.
| Misura delle coppie CamemBERT | Calcolo sui conteggi pubblicati | Risultato |
|---|---|---|
| Precisione | 444 / (444 + 4) |
0,991071 |
| Richiamo candidato | 444 / (444 + 0) |
1,00 |
| F1 candidato | 2 × 444 / (2 × 444 + 4 + 0) |
0,995516 |
| Richiamo end-to-end | 444 / (444 + 204) |
0,685185 |
| F1 end-to-end | 2 × 444 / (2 × 444 + 4 + 204) |
0,810219 |
Il cambiamento di denominatore spiega l'intera differenza: il modello riconosce le positive che gli vengono presentate, ma la catena iniziale di coppie ne ha già perso quasi un terzo. Queste 204 omissioni non si correggono addestrando più a lungo lo stesso classificatore su un elenco di candidati invariato.
I due metodi di riferimento danno un F1 end-to-end di 0,568502 per Jaccard e 0,708373 per il riferimento esatto. CamemBERT migliora dunque questa misura nel protocollo fornito, senza eliminare la perdita del blocking.
Gli eventuali punteggi aggiuntivi del raggruppamento sono conteggiati nella fase successiva. Non vanno integrati retroattivamente nei 918 candidati per annunciare un diverso richiamo iniziale: le due misure non riguardano la stessa operazione.
Conservare le versioni non basta a formare i gruppi giusti
Il raggruppamento ingenuo conserva le 648 versioni, ma i suoi gruppi contengono 16 coppie vietate e fondono eccessivamente 6 documenti logici. Il suo F1 B-cubed vale 0,908720. Un falso collegamento di coppia può quindi avere conseguenze oltre le sue due estremità, collegando gruppi interi.
Anche il raggruppamento vincolato conserva le 648 versioni, produce 295 gruppi e non contiene alcuna coppia vietata né alcun documento fuso eccessivamente in questo test. La sua precisione B-cubed vale 1,00, il richiamo 0,842593 e l'F1 0,914573.
Perché il richiamo resta inferiore a 1 se la precisione è perfetta? Perché i gruppi proposti non mescolano più le identità, ma alcuni restano incompleti: schede dello stesso documento rimangono separate. Al contrario, conservare tutte le versioni significa solo che nessuna è scomparsa dagli output, non che ognuna sia con tutti i compagni giusti.
Si ritrova l'F1 vincolato con 2 × 1 × 0,842593 / (1 + 0,842593), cioè circa 0,914573. Il richiamo B-cubed non è il richiamo delle coppie: fa la media dei compagni ritrovati attorno a ogni scheda e non va confuso con 0,685185.
Il costo e i limiti restano visibili
Il controllo richiede 51 coppie aggiuntive nel test, per un budget previsto di 20 000. Questi calcoli servono a verificare le unioni proposte; non equivalgono a rilanciare una ricerca esaustiva di tutte le coppie mancanti. La frammentazione dei gruppi resta visibile nel richiamo B-cubed.
La durata osservata del raggruppamento include l'inferenza di queste coppie aggiuntive. Gli elementi presentati non forniscono una durata numerica da riprendere qui e questo percorso non giustifica alcuna estrapolazione di portata. Raddoppiare la dimensione della GED non significa necessariamente raddoppiare questo costo: intervengono anche il numero di candidati e la dimensione dei gruppi.
I risultati riguardano un corpus sintetico, con riferimenti e formulazioni fortemente strutturati, un seme e una macchina. Il seme fissa i sorteggi pseudo-casuali dell'esperimento; una sola esecuzione così definita non misura la variabilità tra più addestramenti. Non è fornita alcuna validazione aziendale né studio su lettori umani.
Il risultato da ricordare è quindi duplice: il modello migliora le decisioni sulle coppie in questo protocollo; il veto impedisce le fusioni eccessive osservate, senza rendere completi tutti i gruppi.
Esercizio: prevedere una fusione transitiva ingannevole
La vostra previsione prima del comando
Riprendiamo le quattro schede iniziali. A-17, B-92 e D-40 riguardano VC-204, e D-40 è la sua versione 2. C-11 riguarda VC-205. Il modello assegna tuttavia punteggi alti a tutte le coppie, compresa A-17/C-11.
Prima di eseguire, prevedete il numero di gruppi che otterrà una componente connessa ingenua. Poi immaginate che il veto sia verificato su tutte le coppie incrociate: si può aggiungere C-11 a un gruppo che contiene già A-17 solo perché C-11 assomiglia a B-92? Infine, che cosa deve accadere al file della versione 2?
Scrivete le vostre risposte, poi avviate l'esercizio:
docker compose run --rm tutorial python -m ged_rapprochement_fiches.cli exercise --config configs/minimum.yaml
Il comando crea queste quattro schede e calcola i loro punteggi reali con il modello. I numeri didattici usati sopra per spiegare logits e controlli non sono i punteggi di questa esecuzione. Allo stesso modo, gli eventuali controesempi matematici indicati come illustrativi nelle figure non vanno confusi con gli output di CamemBERT.
Cosa mostra la correzione r001
La variante ingenua riunisce A-17, B-92, C-11 e D-40 in un unico gruppo. Mantiene le quattro versioni, ma conta 2 coppie vietate e 2 documenti logici fusi eccessivamente, con un F1 B-cubed di 0,769231.
La variante vincolata forma due gruppi: {A-17, B-92, D-40} e {C-11}. Conserva le quattro versioni, non conta alcuna coppia vietata e ottiene F1 B-cubed = 1,00.
Il veto messo in evidenza è A-17/C-11, i cui riferimenti affidabili sono incompatibili. B-92 porta effettivamente VC-204, ma la sua affidabilità non è confermata. Non deve diventare un intermediario che permetta a C-11 di entrare nel gruppo di A-17. Questa è tutta la differenza tra verificare l'ultimo collegamento aggiunto e verificare l'unione dei gruppi.
Rifare B-cubed a mano
Per comprendere l'F1 ingenuo, dimentichiamo per un attimo la rete e guardiamo solo gli insiemi. I gruppi di riferimento sono {A-17, B-92, D-40} e {C-11}; il gruppo proposto contiene tutti.
Per ciascuna delle tre schede di VC-204, i tre membri corretti sono presenti tra quattro: precisione locale 3/4, richiamo locale 3/3 = 1. Per C-11, un solo membro su quattro è corretto: precisione locale 1/4, richiamo locale 1/1 = 1.
La precisione media vale quindi (3/4 + 3/4 + 3/4 + 1/4) / 4 = 0,625. Il richiamo medio vale 1. L'F1 calcolato da queste due medie è 2 × 0,625 × 1 / (0,625 + 1) = 0,769231 dopo l'arrotondamento, ritrovando il valore pubblicato.
Il richiamo perfetto del gruppo ingenuo non è un risultato sufficiente: tutti i compagni corretti sono presenti, ma anche gli intrusi. Con i due gruppi corretti, precisione e richiamo locali valgono 1 per ogni scheda.
Una variante da prevedere senza modificare il percorso di riferimento
Per verificare la vostra comprensione, immaginate che l'affidabilità del riferimento di C-11 non sia più confermata, senza cambiare i punteggi alti. Il veto basato su due riferimenti affidabili potrebbe ancora bloccare da solo il raggruppamento A-17/C-11? No: la sua ipotesi iniziale non sarebbe più soddisfatta. I controlli dei punteggi resterebbero necessari, ma non costituirebbero comunque una prova di identità.
Si tratta di una variante di ragionamento, non eseguita nei risultati pubblicati. Mostra perché la definizione di «affidabile» deve derivare da una politica aziendale, non dalla fiducia del modello nel proprio punteggio.
Nell'esercizio fornito, come nel percorso principale, l'output resta PROPOSITION_A_CONFIRMER. Nessun originale viene eliminato. Un gruppo suggerito è un risultato da esaminare, non un'autorizzazione a cancellare un presunto duplicato.
Figure, traguardi e pulizia
Ispezionare prima di cancellare
Leggete outputs/evaluation.json, outputs/groups.json, outputs/grouping.json e outputs/exercise.json. Passate dal punteggio globale a un gruppo preciso: ritrovate i suoi membri, le versioni conservate e le ragioni che hanno impedito alcune unioni.
Generate quindi le figure e controllate i traguardi del corso:
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
Questi traguardi verificano il materiale didattico atteso. Completano la valutazione, senza trasformare una proposta in una convalida amministrativa.
Conservate gli output utili prima di proseguire. La pulizia rispetta questo ordine esatto:
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Il primo down precede intenzionalmente l'avvio della pulizia; il secondo termina il percorso. clean --outputs-only mostra e poi elimina soltanto outputs/, senza toccare schede, file, corpus o checkpoint. Non va quindi avviato prima di aver letto o copiato i risultati che desiderate conservare.
In caso di problema, risalire alla fase interessata
Se il controllo GPU fallisce, riprendete la diagnosi dell'ambiente Docker: la presenza della scheda in Linux non sostituisce il calcolo containerizzato. Se l'acquisizione fallisce, verificate il download, le dimensioni e le impronte previste invece di sostituire un modello trovato altrove.
Se il richiamo è basso, cercate prima se le coppie giuste figurano tra i candidati. Se un'unione viene rifiutata, leggetene la ragione: CANNOT_LINK, REVIEW_UNSCORED e BELOW_THRESHOLD corrispondono a tre situazioni diverse. Aumentare un punteggio non risolve un conflitto amministrativo affidabile; inventare un punteggio non risolve una coppia non esaminata.
Dal tutorial a una GED reale
Prima di un adattamento, definite con i team aziendali cosa sia uno stesso documento logico, cosa distingua una versione da un documento vicino e quali riferimenti siano davvero affidabili. Il veto dipende da queste scelte: un'informazione errata dichiarata affidabile può impedire un raggruppamento utile.
Misurate il richiamo del blocking su dati autorizzati e annotati. Esaminate separatamente i riferimenti assenti, i titoli ripetitivi e le variazioni di formulazione, invece di limitarvi all'F1 dei soli candidati. Sono piste di valutazione per un'applicazione reale, non nuove popolazioni già validate da questo tutorial.
Versionate le proposte e conservatene membri, punteggi, regole e ragioni di rifiuto. Inviate i casi senza punteggio o ambigui a una revisione, e separate questa revisione da ogni azione sui file. I diritti documentali e le regole di conservazione devono continuare ad applicarsi; appartenere a un gruppo proposto non conferisce nuovi diritti.
Il meccanismo appreso si fonda su tre distinzioni: preselezionare non è riconoscere, riconoscere una coppia non è validare un gruppo, proporre un gruppo non è fondere i suoi file. Il veto blocca un'incompatibilità definita in anticipo; la sua assenza non certifica l'identità di un documento.
Scaricate il corso: ZIP r001.
Le documentazioni collegate nell'articolo approfondiscono i concetti. Gli estratti, i comandi e i risultati del percorso restano quelli della revisione r001. I piccoli calcoli esplicitamente didattici spiegano questi meccanismi senza costituire nuove misure del modello.