





Imagine una pantalla de back office que muestra varias fichas de lo que parece ser el mismo documento. Los títulos se parecen, las referencias no siempre se consignan con la misma fiabilidad y algunas fichas corresponden a versiones distintas. Le gustaría proponer una agrupación para facilitar la navegación. Pero, desde luego, no eliminar una versión útil ni reunir dos documentos diferentes porque comparten algunas palabras.
Este es el problema que exploraremos con cuatro fichas ficticias. A-17 y B-92 describen el documento lógico VC-204; D-40 es su versión 2. C-11 describe VC-205, con un título casi idéntico. La agrupación esperada mantiene juntos A-17, B-92 y D-40, y deja C-11 aparte.
La palabra lógico es importante: aquí designa la identidad documental a la que se refieren varias fichas y versiones. No significa que sus archivos sean idénticos byte a byte. Acercar las fichas no es fusionar sus archivos. En este tutorial se conservan todos los archivos y todas las versiones; el programa produce una propuesta sin actualizar la GED, la gestión electrónica de documentos.
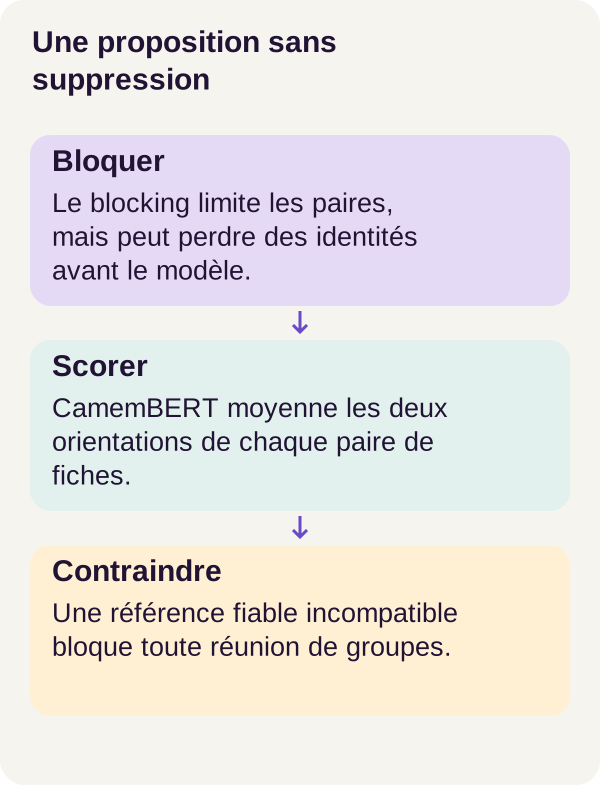
Construiremos la siguiente cadena: fichas → pares candidatos → puntuaciones CamemBERT → decisiones por umbral → grupos propuestos y controlados. Un primer filtro reduce el número de comparaciones. Después, un modelo aprende a examinar dos fichas a la vez. Por último, el código comprueba que una agrupación no eluda un conflicto administrativo fiable.
El interés del recorrido es entender dónde interviene cada elemento y medir qué aporta. Un clasificador excelente no recupera automáticamente los candidatos que el filtro olvidó. Y unos pocos pares erróneos pueden bastar para formar un grupo demasiado grande.
Medir las etapas por separado
El blocking: elegir las comparaciones, todavía no las respuestas
Comparar todas las fichas de dos en dos parece sencillo. Pero, para n fichas, hay que examinar n × (n - 1) / 2 pares distintos: no se compara una ficha consigo misma ni se cuentan dos veces A/B y B/A.
Con solo 648 fichas, ya son 209 628 pares. El blocking es una preselección: conserva un conjunto menor de pares que merecen un examen detallado. Para un desarrollador web, piense en una primera selección de candidatos antes de un tratamiento costoso, no en una decisión definitiva de identidad.
Ejemplo pedagógico, distinto de las reglas del ZIP: si solo comparáramos fichas con exactamente la misma referencia, una referencia ausente o mal introducida podría impedir que dos fichas del mismo documento se encontraran. El modelo situado después de este filtro no tendría entonces ocasión de reconocerlas. La documentación del Python Record Linkage Toolkit sobre indexación presenta este principio de reducción de pares; no describe las reglas particulares de nuestro proyecto.
En el recorrido r001, la agrupación con restricciones puede solicitar puntuaciones adicionales para comprobar una unión prevista. Por tanto, distinguiremos los candidatos del primer filtro y las comparaciones de control añadidas durante la agrupación. Estas últimas no constituyen una nueva búsqueda exhaustiva entre todas las fichas.
Un modelo que lee las dos fichas a la vez
CamemBERT es un modelo de lenguaje preentrenado en francés. Un tokenizer divide el texto en unidades llamadas tokens, a veces más pequeñas que una palabra. El modelo transforma esas unidades en embeddings: vectores, es decir, listas de números que representan el texto teniendo en cuenta su contexto. La documentación oficial de CamemBERT describe, entre otros usos, la clasificación de texto y de pares de secuencias.
Aquí usamos un codificador cruzado: las dos fichas se presentan juntas al modelo, que produce una puntuación para su par. Así, el texto de la primera puede relacionarse con el de la segunda durante el cálculo. No es lo mismo que calcular un vector independiente por ficha, almacenarlo y comparar después esos vectores.
La ventaja buscada es un examen conjunto de los campos. La contrapartida es el coste: cada nuevo par requiere un nuevo cálculo del modelo. La documentación de Sentence Transformers sobre codificadores cruzados explica esta diferencia. Aquí sirve para comprender la arquitectura, no para añadir una biblioteca u otro modelo al recorrido.
El aprendizaje es supervisado: un objetivo vale 1 cuando las dos fichas describen el mismo documento lógico, y 0 en caso contrario. Por tanto, un par positivo no significa necesariamente «dos copias idénticas del mismo archivo». La versión 2 de un documento puede pertenecer al mismo grupo que su versión anterior.
El corpus sintético contiene 4 320 fichas para 1 440 documentos lógicos, incluidas 648 fichas en la prueba. Las identidades de referencia, a menudo llamadas gold, permiten saber qué pares y grupos se esperan. Sirven para aprender o evaluar según la partición, nunca para proporcionar directamente la respuesta durante la inferencia.
Precisión y recall: ¿de qué pares hablamos?
Un verdadero positivo es un par propuesto como idéntico que realmente lo es en la referencia. Un falso positivo reúne por error dos documentos distintos. Un falso negativo es un par positivo esperado que el sistema no encuentra.
La precisión responde a «entre los acercamientos propuestos, ¿cuántos son correctos?». El recall responde a «entre los acercamientos esperados, ¿cuántos hemos recuperado?». El F1 combina ambos mediante una media armónica: 2 × precisión × recall / (precisión + recall).
Usaremos tres medidas complementarias:
| Medida | Cálculo | Pregunta planteada |
|---|---|---|
| Recall del blocking | Positivos candidatos / todos los positivos esperados | ¿El primer filtro conserva las buenas comparaciones? |
| Recall candidato del clasificador | Verdaderos positivos / positivos entre los candidatos | ¿El modelo reconoce los buenos pares que recibe? |
| Recall de extremo a extremo de los pares | Verdaderos positivos / todos los positivos esperados | ¿Qué recupera la cadena de preselección y clasificación? |
Ejemplo pedagógico: se esperan diez pares positivos, el filtro conserva siete y el modelo reconoce esos siete sin error. Su recall candidato vale 7/7 = 1, pero el recall de extremo a extremo vale 7/10 = 0,7. No hay contradicción: los denominadores son distintos.
En términos más generales, para esta cadena de pares, el recall de extremo a extremo es el producto del recall del blocking y del recall candidato. Mejorar solo el clasificador no elimina, por tanto, el límite impuesto por la preselección.
B-cubed: observar los compañeros de cada ficha
Después de los pares vienen los grupos, o clusters. La puntuación B-cubed observa, para cada ficha, su grupo propuesto y su grupo de referencia. Los miembros comunes son los compañeros correctamente mantenidos juntos, incluida la propia ficha.
La precisión local divide ese número de miembros comunes por el tamaño del grupo propuesto. Baja si añadimos intrusos. El recall local lo divide por el tamaño del grupo esperado. Baja si dejamos fuera miembros del mismo documento.
Ejemplo pedagógico: una ficha debería estar con otras dos, es decir, en un grupo esperado de tres miembros. El grupo propuesto contiene dos miembros correctos y un intruso. Para esa ficha, la precisión y el recall B-cubed valen ambos 2/3. El cálculo se repite para cada ficha y luego se promedian las precisiones y los recalls. Calcularemos el F1 de esas dos medias: esta convención reproduce los valores publicados en el recorrido, como mostrará el ejemplo de cuatro fichas.
Una estrategia que deja a todo el mundo solo evita los grupos demasiado grandes, pero no encuentra los acercamientos esperados. A la inversa, un único grupo enorme encuentra todos los compañeros esperados, añadiéndoles muchos intrusos. Por eso la precisión y el recall deben leerse juntos.
Por último, un cannot-link es un veto explícito: en este proyecto, dos referencias fiables, no vacías y distintas no deben pertenecer al mismo grupo. Una ficha sola forma un singleton; no se elimina. Mediremos por separado la calidad de los grupos, el número de pares prohibidos que contienen y la conservación de las versiones.
Preparar al lector para la GPU
Lo necesario antes de empezar
Debe saber leer Python, usar un terminal y ejecutar Docker. Las bases de PyTorch, de la clasificación supervisada y de los grafos son útiles; explicaremos las operaciones que aparecen en los extractos. Un tensor es aquí una tabla numérica y un grafo un conjunto de fichas unidas por acercamientos propuestos.
El perfil de referencia es Linux con una RTX 3090 de 24 GiB, 24 GiB de RAM y 30 GiB de disco de trabajo, además del almacenamiento de Docker. La memoria de la tarjeta gráfica y la RAM de la máquina son dos recursos distintos. Estas indicaciones no garantizan ni una duración ni la capacidad de cualquier otra configuración. Los resultados presentados proceden del recorrido GPU r001; no constituyen una validación en CPU.
Descomprima el ZIP del curso, disponible al final del artículo, y abra un terminal en su raíz. Todos los comandos siguientes se ejecutan desde ese directorio, en el orden indicado. Las versiones y ajustes que hay que reproducir son los del archivo.
No basta con que una GPU sea visible en el host: Docker debe poder acceder a ella. NVIDIA Container Toolkit proporciona la integración necesaria. Si falta, el diagnóstico del proyecto indica la acción esperada sin instalar silenciosamente nada. GPU_DEVICE=1 permite seleccionar otra tarjeta antes del recorrido.
Controlar, construir y adquirir los recursos
Empecemos por las comprobaciones previas, la preparación y la construcción de los servicios.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial learning inference
El preflight controla Docker, Compose, RAM, disco y GPU. docker compose config --quiet termina correctamente sin mostrar contenido cuando la configuración es válida. Cada etapa debe terminar sin error antes de la siguiente.
La adquisición recupera después los seis recursos CamemBERT previstos por el proyecto.
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
Su tamaño y su huella SHA-256 se comprueban antes de una sustitución atómica: los archivos validados ocupan la ubicación prevista sin publicar una copia parcial como si estuviera completa. La huella controla la identidad de los bytes esperados, no la pertinencia de predicciones futuras. No se distribuye ninguna caché privada en el archivo.
Comprobemos ahora el entorno desde el contenedor y después las pruebas del proyecto.
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
La comprobación del entorno realiza realmente un cálculo desde Docker. Las pruebas examinan en particular los conflictos, la simetría y la conservación de versiones. Verifican comportamientos del programa; no demuestran que cada acercamiento de negocio sea correcto. Compruebe que su ejecución termina sin fallo y conserve su informe.
Generar fichas, candidatos y una puntuación simétrica
Separar las entradas de las respuestas esperadas
La preparación coloca las fichas y sus archivos ficticios en data/generated/input/. Las identidades gold permanecen en labels/. El contenedor learning solo monta los pares de aprendizaje y validación; inference no monta ninguna anotación.
La idea se parece a un ejercicio cuyo solucionario permanece cerrado mientras se responde. El modelo debe usar los campos observables, no leer la identidad gold del par que debe clasificar.
docker compose run --rm tutorial python -m ged_rapprochement_fiches.cli prepare --config configs/minimum.yaml
docker compose run --rm tutorial python -m ged_rapprochement_fiches.cli baseline --config configs/minimum.yaml
docker compose run --rm inference python -m ged_rapprochement_fiches.cli inspect-mechanism --config configs/minimum.yaml
prepare fabrica los datos. baseline produce métodos de referencia simples con los que comparar el modelo. Entre ellos, la referencia exacta utiliza una señal de igualdad; Jaccard mide un solapamiento léxico. El principio de Jaccard es «elementos comunes / elementos presentes en al menos uno de los dos conjuntos». Las reglas exactas de preparación de los conjuntos siguen siendo las del ZIP.
inspect-mechanism muestra los campos serializados y la simetría. Serializar significa transformar los campos de una ficha en una entrada textual organizada. El proyecto transmite la referencia, su fiabilidad, el título, el asunto, el texto y la versión. El campo de fiabilidad no es superfluo: leer una referencia y saber que es digna de confianza son dos informaciones diferentes.
Observe esta representación antes de entrenar. Una inspección pedagógica hace legible el cálculo; no debe presentarse como una puntuación agregada de la prueba.
Entrenar, interrumpir y reanudar
El entrenamiento ajusta los parámetros aprendidos a partir de pares anotados. La inferencia, en cambio, utiliza los parámetros obtenidos para asignar puntuaciones a nuevos pares.
docker compose run --rm learning python -m ged_rapprochement_fiches.cli train --config configs/minimum.yaml --mode interrupt
docker compose run --rm learning python -m ged_rapprochement_fiches.cli train --config configs/minimum.yaml --mode continuous
docker compose run --rm learning python -m ged_rapprochement_fiches.cli train --config configs/minimum.yaml --mode resume
docker compose run --rm learning python -m ged_rapprochement_fiches.cli verify-resume --config configs/minimum.yaml
El recorrido distingue una ejecución interrumpida, una ejecución continua y una reanudación. Un checkpoint es un estado guardado que permite continuar un cálculo; una reanudación no es un nuevo entrenamiento arbitrario sobre los mismos archivos. verify-resume comprueba la coherencia del recorrido reanudado con el recorrido continuo. Esta comprobación de reproducción no sustituye la evaluación con fichas desconocidas.
Para examinar el presupuesto de entrenamiento, el optimizador y los detalles de restauración, consulte configs/minimum.yaml y el código entregado. Conserve estos ajustes durante la reproducción de referencia antes de experimentar en una copia separada.
Del logit a la decisión
El modelo produce un logit, una puntuación bruta que puede ser positiva, negativa o nula. La sigmoide transforma esa puntuación en un valor entre 0 y 1: sigmoïde(z) = 1 / (1 + exp(-z)).
Durante el aprendizaje, la pérdida, o loss, mide la diferencia entre la predicción y el objetivo. Para entender la entropía cruzada binaria sin ponderación, recuerde dos casos: si el objetivo vale 1, el error es -log(p); si vale 0, es -log(1-p). Dar mucha confianza al resultado equivocado tiene por tanto un coste elevado.
Ejemplo numérico pedagógico: para un par realmente positivo, p = 0,9 da una pérdida de aproximadamente 0,1054, frente a 2,3026 con p = 0,1. El aprendizaje utiliza esta señal para ajustar los parámetros; no escribe una regla textual a partir de cada ejemplo.
La documentación de BCEWithLogitsLoss, también disponible en la referencia de PyTorch 2.8, precisa que esta operación combina sigmoide y pérdida binaria de forma numéricamente estable. Recibe logits: no hay que aplicarle antes una sigmoide «para ayudarla».
Una salida entre 0 y 1 sigue siendo una puntuación probabilística del modelo. Su valor no demuestra que una proporción idéntica de decisiones vaya a ser correcta sobre documentos reales.
¿Por qué calcular A/B y B/A?
La identidad buscada es simétrica: si A y B representan el mismo documento, B y A también. Sin embargo, un modelo que lee una secuencia ordenada puede dar dos logits distintos según el orden de las fichas.
Por ello, el proyecto codifica las dos orientaciones y después promedia sus logits. Esta es la función exacta:
def symmetric_logits(model, encoded_pairs, tokenizer):
    if not encoded_pairs:
        raise ValueError("Empty pair batch")
    oriented = [row["orientations"][side] for side in [0, 1] for row in encoded_pairs]
    batch = {
        k: v.cuda()
        for k, v in tokenizer.pad(oriented, padding=True, return_tensors="pt").items()
    }
    raw = model(**batch).squeeze(-1)
    count = len(encoded_pairs)
    return (raw[:count] + raw[count:]) / 2, raw[:count], raw[count:]
Empecemos por oriented. El bucle recorre primero side=0 para todos los pares y después side=1 para todos los pares. Con los pares A/B y C/D, el orden es A/B, C/D, B/A, D/C. No es A/B, B/A, C/D, D/C. Esta organización explica los dos segmentos del retorno.
tokenizer.pad(..., padding=True, return_tensors="pt") completa las secuencias del lote hasta una longitud común y produce tensores PyTorch. El padding es relleno técnico, no contenido documental; la máscara de atención permite distinguirlo de las posiciones útiles. El contrato del tokenizer detalla estas entradas. Después, cada tensor se transfiere a la GPU con .cuda().
El modelo del proyecto proporciona una puntuación por orientación. squeeze(-1) elimina la última dimensión de tamaño 1: una salida con forma [2B, 1] pasa a ser [2B], donde B es el número de pares. No hay que confundir B pares con 2B orientaciones.
Por último, raw[:count] contiene los logits directos y raw[count:] sus inversos. Su media, término a término, devuelve una puntuación por par. Las dos series brutas también se devuelven para la inspección. Un lote vacío provoca un error explícito.
La media de logits y la media de probabilidades no son intercambiables
Ejemplo ilustrativo, sin relación con una salida medida de CamemBERT: supongamos que los logits de un par son 4 en un sentido y -2 en el otro. Su media vale 1; su sigmoide vale aproximadamente 0,7311.
Si aplicáramos primero las dos sigmoides, obtendríamos aproximadamente 0,9820 y 0,1192. Su media sería 0,5506, no 0,7311. La diferencia procede de la transformación no lineal. Por tanto, para reproducir el proyecto hay que conservar la media de los logits, no sustituirla por una media de probabilidades.
La puntuación final es simétrica porque intercambiar los dos logits no cambia su media. En la prueba r001, el error absoluto de simetría es nulo para A-17/B-92. Esto verifica una propiedad del cálculo, no la identidad de todas las fichas.
Esta propiedad también supone comparar las mismas evaluaciones de las dos orientaciones. El extracto no pone por sí mismo el modelo en modo evaluación. En PyTorch, eval() actúa, entre otros, sobre módulos cuyo comportamiento difiere durante el entrenamiento, como el dropout, que desactiva aleatoriamente algunos valores durante el aprendizaje. Por eso el contexto de llamada sigue siendo importante para una comparación reproducible.
Sobre todo, la simetría no es transitividad. Puntuaciones elevadas para A/B y B/C no garantizan una puntuación elevada para A/C. Esto es precisamente lo que debe tratar la agrupación.
Calibrar, agrupar y comprobar el veto
Elegir un umbral antes de mirar la prueba
Tras el entrenamiento, la inferencia produce las puntuaciones sin leer las etiquetas. La calibración utiliza después la validación para elegir el umbral, que vale 0,5 en el recorrido r001. La prueba sirve para medir la regla así fijada, no para elegir a posteriori el valor que haga el resultado más halagador.
Aquí, calibrar designa la elección de un umbral de decisión. Esto no basta para demostrar una calibración probabilística: una puntuación de 0,9 no se convierte, solo por esta operación, en una garantía del 90 % de decisiones correctas.
docker compose run --rm inference python -m ged_rapprochement_fiches.cli predict --config configs/minimum.yaml
docker compose run --rm learning python -m ged_rapprochement_fiches.cli calibrate --config configs/minimum.yaml
docker compose run --rm inference python -m ged_rapprochement_fiches.cli cluster --config configs/minimum.yaml
docker compose run --rm tutorial python -m ged_rapprochement_fiches.cli evaluate --config configs/minimum.yaml
predict produce las puntuaciones; calibrate fija la decisión en validación; cluster construye los grupos; evaluate confronta las propuestas con las referencias. Mantenga las etapas separadas para poder localizar un error: mal candidato, mala puntuación o mala unión de grupos.
La trampa de las componentes conexas
La variante ingenua representa cada ficha mediante un nodo. Un par aceptado se convierte en una arista, un enlace no dirigido entre dos nodos. Una componente conexa reúne las fichas entre las que se puede circular siguiendo esos enlaces, posiblemente a través de varios intermediarios. La documentación de NetworkX ofrece esta definición; no significa que esta biblioteca sea necesaria para el código del curso.
Ejemplo pedagógico: con los enlaces A—B y B—C, las tres fichas pertenecen a la misma componente, incluso sin enlace A—C. Si B se ha acercado por error a C, la sola existencia del camino basta para incorporar C al grupo de A.
El problema no es, por tanto, que el algoritmo de componentes conexas calcule mal. Aplica exactamente la regla que se le dio. Esa regla es la que puede resultar demasiado permisiva para la identidad documental.
Comprobar todas las relaciones entre los grupos
La variante con restricciones plantea una pregunta más exigente: ¿podemos reunir estos dos grupos sin crear entre sus miembros una relación prohibida o insuficientemente justificada?
Tomemos dos grupos {A, B} y {C, D}. No basta con comprobar solo el enlace B/C que sugirió la fusión. Los pares cruzados son A/C, A/D, B/C y B/D: cuatro comprobaciones. En general, reunir grupos de m y n miembros exige examinar m × n pares cruzados.
La salvaguarda del proyecto es la siguiente. Las funciones auxiliares, incluidas pair y cannot_link, forman parte del código completo del ZIP.
def can_merge_clusters(left, right, records, get_score, threshold):
    crossed = sorted(pair(a, b) for a, b in product(left, right))
    # Trusted administrative conflicts veto the entire merge, before neural work.
    for a, b in crossed:
        if cannot_link(records[a], records[b]):
            return False, {"reason": "CANNOT_LINK", "pair": [a, b]}
    for a, b in crossed:
        value = get_score(a, b)
        if value is None:
            return False, {"reason": "REVIEW_UNSCORED", "pair": [a, b]}
        if value < threshold:
            return False, {
                "reason": "BELOW_THRESHOLD",
                "pair": [a, b],
                "probability": value,
            }
    return True, {"reason": "ALL_CROSS_PAIRS_PASSED", "cross_pairs": len(crossed)}
La primera línea construye todos los pares cruzados con product(left, right) y después los coloca en un orden estable. No se limita ni a los representantes de los grupos ni al enlace que desencadenó la propuesta.
El primer bucle busca un veto administrativo. Si cannot_link encuentra dos referencias fiables incompatibles, se rechaza toda la unión con CANNOT_LINK. Como este bucle precede a todas las llamadas a get_score, esta función no solicita ninguna puntuación neuronal para este intento, aunque el conflicto aparezca en el último par examinado.
Una referencia ausente o cuya fiabilidad no esté confirmada no activa por sí sola este veto. Pero la ausencia de veto no es una prueba de identidad: aún deben superarse los controles de puntuación.
El segundo bucle exige una puntuación para cada par cruzado. get_score(a, b) proporciona el valor disponible; el recorrido puede hacer que se calculen puntuaciones adicionales para estas comprobaciones. Si el valor sigue siendo None, la función devuelve REVIEW_UNSCORED. No transforma «no examinado» en «probablemente idéntico».
Si una puntuación es estrictamente inferior al umbral, la unión se rechaza con BELOW_THRESHOLD. Un valor exactamente igual al umbral supera este control, pues la condición es value < threshold y no value <= threshold.
Por último, ALL_CROSS_PAIRS_PASSED significa que todas las comprobaciones cruzadas han tenido éxito. Aún no es una modificación de la GED: la función devuelve un booleano y un diagnóstico. No elimina ningún archivo ni fusiona por sí misma ningún dato.
Lo que garantiza el control y lo que supone
Pequeña prueba mental: tres de los cuatro pares cruzados tienen una puntuación de 0,9, pero el cuarto sigue sin puntuarse. La unión debe rechazarse, aunque una media de las puntuaciones conocidas pareciera excelente. El resultado es el mismo con un cuarto valor de 0,4 y un umbral de 0,5. Estos números ilustran la regla; no son puntuaciones medidas del modelo.
Partiendo de grupos ya válidos, comprobar todas las nuevas relaciones cruzadas permite preservar sus restricciones durante una unión. Sin embargo, esto no establece que cada grupo corresponda al documento correcto: pares diferentes pueden recibir todos puntuaciones altas por error, sin una referencia fiable que los contradiga.
El extracto tampoco es un validador completo de sus entradas. Supone, en particular, grupos no vacíos, identificadores presentes en records y puntuaciones numéricas finitas. No comprueba por sí mismo estas propiedades. Por ejemplo, comparar NaN con el umbral mediante < no activa el rechazo esperado para una puntuación demasiado baja. Esto describe un límite de esta función aislada, no el resultado de una auditoría de los controles previos del proyecto.
Por último, comprobar una unión local no busca necesariamente la mejor partición global. En un ejemplo abstracto en el que A/B y B/C pasan pero A/C falla, reunir primero A/B o B/C puede conducir a dos particiones diferentes. La ordenación de los pares dentro de esta función estabiliza su inspección; no demuestra que toda la agrupación sea independiente del orden de las uniones propuestas.
Leer la prueba: la primera pérdida llega antes del modelo
Recuperar los recuentos detrás de las puntuaciones
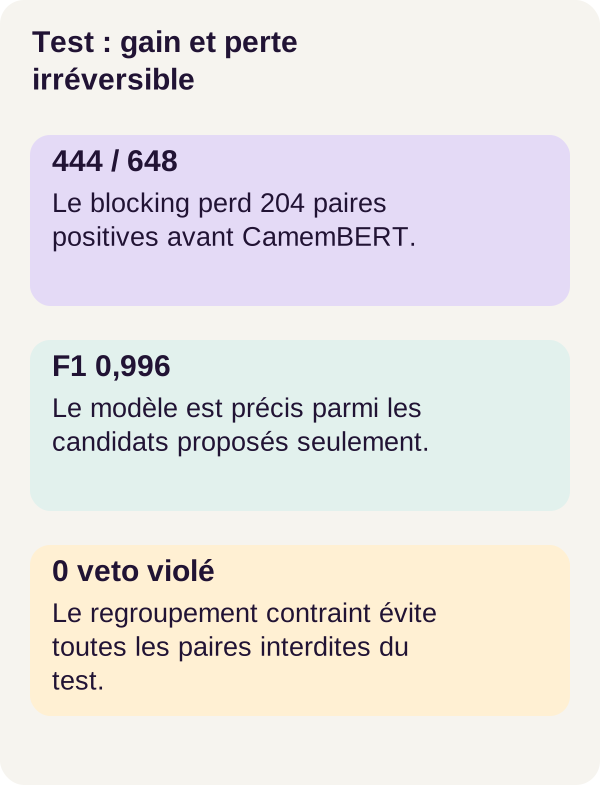
De las 648 fichas de prueba, el blocking conserva 918 pares entre 209 628 posibles, aproximadamente el 0,44 % de las comparaciones iniciales. Es una gran reducción de trabajo para el clasificador, pero tiene un coste en recall.
Entre los 648 pares positivos esperados, solo 444 llegan a los candidatos. Faltan, por tanto, 204. El recall del blocking vale 444 / 648 = 0,685185.
En estos 918 candidatos, CamemBERT obtiene 444 verdaderos positivos, 4 falsos positivos y 0 falsos negativos. Por tanto, su recall candidato vale 1. Pero esos cero falsos negativos solo se refieren a los pares recibidos, no a los que la preselección descartó.
| Medida de pares de CamemBERT | Cálculo sobre los recuentos publicados | Resultado |
|---|---|---|
| Precisión | 444 / (444 + 4) |
0,991071 |
| Recall candidato | 444 / (444 + 0) |
1,00 |
| F1 candidato | 2 × 444 / (2 × 444 + 4 + 0) |
0,995516 |
| Recall de extremo a extremo | 444 / (444 + 204) |
0,685185 |
| F1 de extremo a extremo | 2 × 444 / (2 × 444 + 4 + 204) |
0,810219 |
El cambio de denominador explica toda la diferencia: el modelo reconoce los positivos que se le presentan, pero la cadena inicial de pares ya ha perdido cerca de un tercio. Estas 204 omisiones no se corrigen entrenando más tiempo el mismo clasificador sobre una lista de candidatos sin cambios.
Los dos métodos de referencia dan un F1 de extremo a extremo de 0,568502 para Jaccard y 0,708373 para la referencia exacta. Por tanto, CamemBERT mejora esta medida en el protocolo proporcionado, sin eliminar la pérdida del blocking.
Las posibles puntuaciones adicionales de la agrupación se cuentan en la etapa siguiente. No hay que integrarlas retroactivamente en los 918 candidatos para anunciar otro recall inicial: las dos medidas no se refieren a la misma operación.
Conservar las versiones no basta para formar los grupos correctos
La agrupación ingenua conserva las 648 versiones, pero sus grupos contienen 16 pares prohibidos y sobrefusionan 6 documentos lógicos. Su F1 B-cubed vale 0,908720. Un enlace de par falso puede, por tanto, tener consecuencias más allá de sus dos extremos al conectar grupos enteros.
La agrupación con restricciones también conserva las 648 versiones, produce 295 grupos y no contiene ningún par prohibido ni documento sobrefusionado en esta prueba. Su precisión B-cubed vale 1,00, su recall 0,842593 y su F1 0,914573.
¿Por qué el recall sigue siendo inferior a 1 si la precisión es perfecta? Porque los grupos propuestos ya no mezclan las identidades, pero algunos permanecen incompletos: fichas de un mismo documento siguen separadas. A la inversa, conservar todas las versiones significa solo que ninguna ha desaparecido de las salidas, no que cada una esté con todos los compañeros correctos.
El F1 con restricciones se recupera con 2 × 1 × 0,842593 / (1 + 0,842593), aproximadamente 0,914573. El recall B-cubed no es el recall de pares: promedia los compañeros recuperados alrededor de cada ficha y no debe confundirse con 0,685185.
El coste y los límites siguen visibles
El control requiere 51 pares adicionales en la prueba, para un presupuesto previsto de 20 000. Estos cálculos sirven para comprobar las uniones previstas; no equivalen a relanzar una búsqueda exhaustiva de todos los pares que faltan. La fragmentación de los grupos sigue siendo visible en el recall B-cubed.
La duración observada de la agrupación incluye la inferencia de estos pares adicionales. Los elementos presentados no proporcionan una duración numérica que reproducir aquí, y este recorrido no justifica ninguna extrapolación de rendimiento. Duplicar el tamaño de la GED no implica necesariamente duplicar ese coste: también intervienen el número de candidatos y el tamaño de los grupos.
Los resultados se refieren a un corpus sintético, con referencias y formulaciones muy estructuradas, una semilla y una máquina. La semilla fija los sorteos seudoaleatorios del experimento; una sola ejecución así definida no mide la variabilidad entre varios entrenamientos. No se proporciona ninguna validación de negocio ni estudio con lectores humanos.
Por tanto, el resultado que conviene retener es doble: el modelo mejora las decisiones de pares en este protocolo; el veto evita las sobrefusiones observadas, sin completar todos los grupos.
Ejercicio: predecir una fusión transitiva engañosa
Su predicción antes del comando
Retomemos las cuatro fichas del comienzo. A-17, B-92 y D-40 se refieren a VC-204, y D-40 es su versión 2. C-11 se refiere a VC-205. Sin embargo, el modelo da puntuaciones altas a todos los pares, incluido A-17/C-11.
Antes de ejecutar, prediga el número de grupos que obtendrá una componente conexa ingenua. Después, imagine que el veto se comprueba en todos los pares cruzados: ¿puede añadirse C-11 a un grupo que ya contiene A-17 simplemente porque C-11 se parece a B-92? Por último, ¿qué debe ocurrir con el archivo de la versión 2?
Escriba sus respuestas y después ejecute el ejercicio:
docker compose run --rm tutorial python -m ged_rapprochement_fiches.cli exercise --config configs/minimum.yaml
El comando crea estas cuatro fichas y calcula sus puntuaciones reales con el modelo. Los números pedagógicos usados antes para explicar los logits y los controles no son las puntuaciones de esta ejecución. Del mismo modo, los posibles contraejemplos matemáticos señalados como ilustrativos en las figuras no deben confundirse con las salidas de CamemBERT.
Lo que muestra la corrección r001
La variante ingenua reúne A-17, B-92, C-11 y D-40 en un solo grupo. Conserva las cuatro versiones, pero cuenta 2 pares prohibidos y 2 documentos lógicos sobrefusionados, con un F1 B-cubed de 0,769231.
La variante con restricciones forma dos grupos: {A-17, B-92, D-40} y {C-11}. Conserva las cuatro versiones, no cuenta ningún par prohibido y obtiene B-cubed F1 = 1,00.
El veto destacado es A-17/C-11, cuyas referencias fiables son incompatibles. B-92 sí lleva VC-204, pero su fiabilidad no está confirmada. No debe convertirse en un intermediario que permita introducir C-11 en el grupo de A-17. Esta es toda la diferencia entre comprobar el último enlace añadido y comprobar la unión de los grupos.
Rehacer B-cubed a mano
Para entender el F1 ingenuo, olvidemos un instante la red y observemos solo los conjuntos. Los grupos de referencia son {A-17, B-92, D-40} y {C-11}; el grupo propuesto contiene a todos.
Para cada una de las tres fichas de VC-204, los tres buenos miembros están presentes entre cuatro: precisión local 3/4, recall local 3/3 = 1. Para C-11, solo un miembro de cuatro es correcto: precisión local 1/4, recall local 1/1 = 1.
La precisión media vale, por tanto, (3/4 + 3/4 + 3/4 + 1/4) / 4 = 0,625. El recall medio vale 1. El F1 calculado a partir de estas dos medias es 2 × 0,625 × 1 / (0,625 + 1) = 0,769231 tras redondear, lo que reproduce el valor publicado.
El recall perfecto del grupo ingenuo no es un éxito suficiente: todos los buenos compañeros están presentes, pero también los intrusos. Con los dos grupos correctos, la precisión y el recall locales valen 1 para cada ficha.
Una variante que predecir sin modificar el recorrido de referencia
Para comprobar su comprensión, imagine que la fiabilidad de la referencia de C-11 dejara de estar confirmada, sin cambiar las puntuaciones altas. ¿El veto basado en dos referencias fiables podría aún bloquear por sí solo el acercamiento A-17/C-11? No: su hipótesis inicial ya no se cumpliría. Los controles de puntuación seguirían siendo necesarios, pero tampoco constituirían una prueba de identidad.
Se trata de una variante de razonamiento, no ejecutada en los resultados publicados. Muestra por qué la definición de «fiable» debe proceder de una política de negocio, no de la confianza del modelo en su propia puntuación.
En el ejercicio proporcionado, igual que en el recorrido principal, la salida sigue siendo PROPOSITION_A_CONFIRMER. No se elimina ningún original. Un grupo sugerido es un resultado que debe examinarse, no una autorización para borrar un supuesto duplicado.
Figuras, hitos y limpieza
Inspeccionar antes de borrar
Lea outputs/evaluation.json, outputs/groups.json, outputs/grouping.json y outputs/exercise.json. Pase de la puntuación global a un grupo concreto: encuentre sus miembros, las versiones conservadas y los motivos que impidieron algunas uniones.
Produzca después las figuras y compruebe los hitos del curso:
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
Estos hitos comprueban el material pedagógico esperado. Complementan la evaluación sin transformar una propuesta en validación administrativa.
Conserve las salidas útiles antes de continuar. La limpieza respeta este orden exacto:
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
El primer down precede deliberadamente al inicio de la limpieza; el segundo termina el recorrido. clean --outputs-only muestra y elimina únicamente outputs/, sin tocar las fichas, los archivos, el corpus ni los checkpoints. Por tanto, no debe ejecutarlo antes de haber leído o copiado los resultados que desea conservar.
Si surge un problema, vuelva a la etapa correspondiente
Si falla el control de GPU, retome el diagnóstico del entorno Docker: la presencia de la tarjeta en Linux no sustituye el cálculo en contenedor. Si falla la adquisición, compruebe la descarga, los tamaños y las huellas esperadas en vez de sustituir el modelo por otro encontrado en cualquier lugar.
Si el recall es bajo, busque primero si los buenos pares figuran entre los candidatos. Si se rechaza una unión, lea su motivo: CANNOT_LINK, REVIEW_UNSCORED y BELOW_THRESHOLD corresponden a tres situaciones distintas. Aumentar una puntuación no resuelve un conflicto administrativo fiable; inventar una puntuación no resuelve un par no examinado.
Del tutorial a una GED real
Antes de una adaptación, defina con los equipos de negocio qué es un mismo documento lógico, qué distingue una versión de un documento cercano y qué referencias son realmente fiables. El veto depende de estas decisiones: una información errónea declarada fiable puede impedir un acercamiento útil.
Mida el recall del blocking con datos autorizados y anotados. Examine por separado las referencias ausentes, los títulos repetitivos y las variaciones de redacción, en lugar de conformarse con el F1 de los candidatos solamente. Son vías de evaluación para una aplicación real, no nuevas poblaciones ya validadas por este tutorial.
Versione las propuestas y conserve sus miembros, puntuaciones, reglas y motivos de rechazo. Dirija los casos sin puntuación o ambiguos a una revisión y separe esa revisión de cualquier acción sobre los archivos. Los derechos documentales y las reglas de conservación deben seguir aplicándose; pertenecer a un grupo propuesto no concede nuevos derechos.
El mecanismo aprendido se resume en tres distinciones: preseleccionar no es reconocer, reconocer un par no es validar un grupo, proponer un grupo no es fusionar sus archivos. El veto bloquea una incompatibilidad definida de antemano; su ausencia no certifica la identidad de un documento.
Descargue el curso: ZIP r001.
Las documentaciones enlazadas en el artículo profundizan en los conceptos. Los extractos, comandos y resultados del recorrido siguen siendo los de la revisión r001. Los pequeños cálculos indicados explícitamente como pedagógicos explican estos mecanismos sin constituir nuevas mediciones del modelo.