





Vous développez un outil de support. Pour ranger les demandes, votre application attend une catégorie, une priorité et un produit. Avec un formulaire classique, vous auriez prévu trois listes déroulantes, puis vérifié leurs valeurs côté serveur. Mais ici, l’utilisateur écrit un message libre : c’est au modèle de retrouver les trois informations.
Peut-on simplement lui demander « réponds en JSON » et transmettre sa réponse au reste de l’application ? Pas tout à fait. Le modèle peut ajouter une phrase, oublier une clé ou proposer une valeur que votre programme ne connaît pas. Et même lorsqu’il respecte parfaitement le format, il peut se tromper de catégorie.
Nous allons donc séparer deux problèmes : obtenir une réponse dans une forme autorisée, puis vérifier que cette réponse correspond au ticket. Pour le premier, nous allons intervenir pendant la génération, en limitant les prochains tokens que le modèle peut choisir. Pour le second, nous conserverons un contrôle indépendant.
Le projet s’exécute localement avec Python, Docker et un GPU NVIDIA. Il construit une expérience de classification, pas une interface web ni un service de support prêt à déployer. Il ne prend aucune décision métier : classer un ticket n’autorise pas à rembourser une commande ou à modifier un compte.
Le problème et la construction
Trois champs, un nombre limité de réponses
Le corpus contient 240 tickets fictifs en anglais : 48 servent au développement du prompt et 192 au test. Le prompt est l’ensemble des instructions et du texte soumis au modèle. Ici, le développement sert à fixer ces instructions ; ce n’est pas un entraînement des poids du modèle.
Chaque réponse doit associer les trois champs suivants :
| Champ | Ce qu’il représente | Valeurs autorisées |
|---|---|---|
category |
La famille de la demande | billing, delivery, technical, unknown |
priority |
Le niveau de priorité | low, normal, high |
product |
Le produit concerné | P01, P02, P03, unknown |
Nous conservons ces noms et valeurs en anglais : ils appartiennent au contrat du programme. Par exemple, technical et technique ne sont pas deux orthographes interchangeables pour le validateur.
Pour suivre le mécanisme, prenons un exemple pédagogique ajouté à l’explication, distinct des tickets du corpus et des sorties mesurées :
My P02 device will not start. This is urgent.
Pour cet exemple, nous fixons comme réponse de référence la catégorie technical, la priorité high et le produit P02 :
{"category":"technical","priority":"high","product":"P02"}
Cette référence est une annotation : une réponse attendue définie indépendamment de ce que produira le modèle. Dans une application réelle, décider ce qui mérite la priorité high demanderait une règle métier explicite.
Il existe quatre choix de catégorie, trois de priorité et quatre de produit. Le programme peut donc énumérer 4 × 3 × 4 = 48 combinaisons. Il écrit chacune dans un ordre stable, sans espaces variables : nous obtenons 48 chaînes canoniques, c’est-à-dire 48 représentations textuelles choisies comme référence de génération.
Les 48 réponses possibles et les 48 tickets de développement sont deux nombres distincts par leur rôle. Le premier vient du contrat ; le second, du découpage du corpus. Chaque ticket peut être classé dans l’une des mêmes 48 réponses.
Demander, contraindre, vérifier : trois opérations différentes
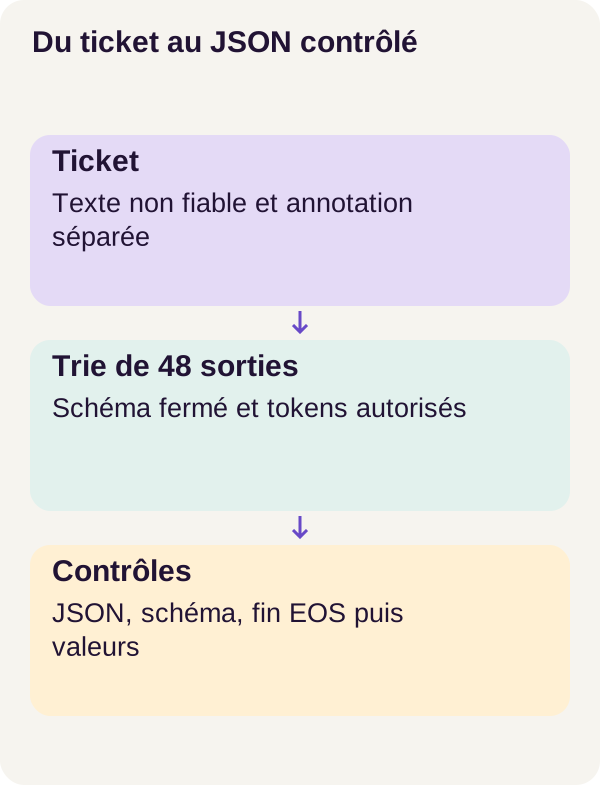
Une consigne demande au modèle de respecter le format. Une contrainte de décodage empêche de choisir un prochain token qui sortirait des chemins autorisés. Un validateur examine ensuite la réponse obtenue.
Nous ne réparons donc pas un JSON incomplet après coup. À chaque étape, le programme ne garde que les tokens qui prolongent une des 48 chaînes canoniques. Le signal de fin devient autorisé seulement lorsqu’une chaîne est complète.
Cette petite grammaire est volontairement plus étroite que JSON. Elle n’autorise ni texte libre supplémentaire, ni nouvelle clé, ni montant arbitraire. La syntaxe générale est décrite dans la RFC 8259 ; notre objectif est de construire un langage fini pour ce contrat précis, pas un parseur de tout JSON.
Concepts utiles avant de lancer le GPU
Le modèle propose le prochain morceau de texte
Un modèle de langage produit une suite de tokens, ou jetons. Ce ne sont pas nécessairement des caractères ni des mots complets : un token peut représenter une partie de mot ou des signes. Le tokenizer transforme le texte en identifiants numériques et permet de revenir au texte. La documentation de Transformers sur la tokenisation présente ces découpages.
À un instant donné, le modèle reçoit le texte déjà disponible et calcule un score pour chaque token du vocabulaire. Ce score s’appelle un logit. Dans notre parcours, choisir le plus grand score revient à choisir le prochain token ; l’opération argmax renvoie son indice.
Un logit n’est pas un pourcentage de confiance sur la bonne catégorie du ticket. Il intervient dans le choix du prochain morceau de texte, pas dans une validation métier.
Le trie décrit les continuations autorisées
Un trie est un arbre de préfixes. Un préfixe est simplement un début de séquence. Plusieurs réponses qui commencent de la même façon partagent un début de chemin, puis se séparent là où leurs tokens diffèrent.
Imaginez une autocomplétion qui n’autoriserait que les continuations d’un catalogue fermé. Après chaque choix, on avance dans le catalogue des chemins restants. Le trie ne lit pas le ticket et ne sait pas quelle catégorie est juste : il sait seulement quels tokens peuvent encore conduire à une réponse autorisée.
Si A(s) désigne les tokens autorisés après le préfixe s, nous gardons leurs logits et remplaçons tous les autres par moins l’infini, noté -inf. Ainsi, argmax choisit parmi les continuations admissibles, tant qu’au moins l’une possède un score fini. Nous suivrons un exemple numérique dans le code.
Terminer la génération est aussi une décision
EOS, pour end of sequence, est un token spécial qui indique la fin. Ce n’est pas l’accolade } du JSON. Le programme doit distinguer « l’objet est complet » et « la génération s’est terminée selon la règle prévue ».
Autoriser EOS dès le début laisserait le modèle s’arrêter sans rien écrire. Ici, EOS n’est proposé qu’à un nœud terminal du trie, c’est-à-dire après une séquence complète. Une limite de longueur peut toutefois interrompre l’exécution avant cette fin : nous mesurerons aussi ce cas.
Trois questions à poser à la réponse
Est-elle lisible ? Le parseur peut-il convertir le texte en une valeur JSON ? Est-elle conforme ? Retrouve-t-on les trois clés et leurs valeurs autorisées ? Est-elle exacte ? Les valeurs correspondent-elles à l’annotation du ticket ?
Pour notre exemple, remplacer P02 par P03 ne casse ni la syntaxe ni le contrat : P03 est un produit autorisé. La réponse devient pourtant fausse. C’est précisément cette différence que l’expérience va rendre visible.
Prérequis Docker et GPU
Vous devez savoir lire des fonctions Python, des listes et des dictionnaires, utiliser JSON, un terminal et les bases de Docker. Les notions de décodage sont expliquées dans le parcours ; aucune pratique préalable de l’entraînement n’est nécessaire.
L’environnement validé utilise Linux x86_64, Docker avec Compose, NVIDIA Container Toolkit et une RTX 3090 de 24 Gio. Prévoyez 16 Gio de RAM et 16 Gio de disque, hors couches Docker partagées. La mémoire vidéo, ou VRAM, appartient à la carte graphique ; elle ne remplace pas la RAM du poste. Aucune exécution CPU n’est présentée comme équivalente à ce parcours GPU.
Le modèle est Qwen2.5-0.5B-Instruct, à la révision publique fixe 7ae557604adf67be50417f59c2c2f167def9a775. « Instruct » désigne son adaptation au suivi d’instructions ; cela ne garantit pas qu’il les suivra sans erreur. Transformers le charge localement, sans code distant. La fiche du modèle à cette révision complète sa description.
Le modèle contient déjà des poids, les paramètres numériques acquis pendant son apprentissage. Ici, nous les utilisons pour calculer des sorties : c’est l’inférence. Construire le trie ou modifier les tokens autorisés n’entraîne pas ces poids.
Extrayez l’archive et ouvrez le terminal à sa racine. Toutes les commandes de l’article partent de ce même dossier. setup.sh prépare les répertoires et écrit seulement UID/GID dans .env : ces identifiants concernent les droits de l’utilisateur et du groupe sur les fichiers.
acquire télécharge les fichiers publics, les vérifie puis ne les place sous leur nom final qu’après validation, par renommage atomique. models/ conserve cette version locale, appelée snapshot ; outputs/ reçoit les mesures et artifacts/ les checkpoints du projet. Ne confondez pas ces fichiers de contrôle avec un nouvel entraînement.
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
Les cinq commandes ont des responsabilités différentes. config --quiet vérifie la configuration Compose. build construit les images nécessaires. acquire.py prépare les fichiers du modèle. Enfin, check_environment.py doit réussir avant l’inférence.
CUDA permet ici d’exécuter les calculs sur le GPU NVIDIA. Le fait que la carte soit visible sur Linux ne suffit pas à établir qu’elle est utilisable depuis Docker. Si CUDA ne s’initialise pas dans le conteneur, commencez par la documentation NVIDIA Container Toolkit, plutôt que de modifier le décodeur.
Les couches Docker déjà présentes peuvent raccourcir la construction des images. Ce temps de préparation n’est pas une mesure de décodage du modèle.
Vérifier le programme avant le moteur
Avant de demander au modèle de classer les tickets, vérifions les règles qui vont l’entourer. La suite publique couvre le schéma, le trie et les scénarios d’échec. Lancez-la après le contrôle GPU :
docker compose run --rm gpu python -m pytest -q
Une réussite signifie que les comportements testés du programme correspondent à ce qui est attendu. Elle ne signifie pas encore que le modèle comprendra les tickets. C’est la même distinction qu’entre tester le validateur d’un formulaire et vérifier la justesse des informations saisies.
Ne sautez pas cette étape pour obtenir plus vite un premier JSON : une sortie plausible ne permettrait pas de repérer une branche interdite acceptée par erreur.
Données et contrat de sortie
Construire les réponses possibles sans connaître la bonne
Pour contraindre le modèle, nous avons besoin de toutes les réponses autorisées, pas de la réponse attendue pour un ticket donné. La fonction suivante ne reçoit donc aucun ticket ni aucune annotation :
def enumerate_canonical_outputs():
    return [
        json.dumps(dict(zip(SCHEMA, values)), separators=(",", ":"))
        for values in itertools.product(*SCHEMA.values())
    ]
Dans cet extrait, SCHEMA est la correspondance entre les noms des champs et leurs listes de valeurs. Le nom ne signifie pas qu’il s’agit d’un document au format standard JSON Schema : le code parcourt ici un contrat énuméré.
SCHEMA.values() fournit les listes de choix. L’étoile dans itertools.product(*SCHEMA.values()) les transmet comme arguments séparés. Le produit cartésien fabrique toutes les combinaisons, comme trois boucles imbriquées : une catégorie, puis une priorité, puis un produit. La documentation de itertools.product détaille cette opération.
Pour une combinaison telle que ("technical", "high", "P02"), zip(SCHEMA, values) associe chaque nom à sa valeur. dict(...) construit l’objet ; json.dumps(...) le convertit en texte. Enfin, separators=(",", ":") impose l’écriture compacte, sans espaces entre les éléments.
Nous obtenons les 48 chaînes promises. Nous n’avons pas choisi celle qui convient au ticket. Construire, à l’inverse, un trie ne contenant que son annotation reviendrait à donner la réponse au décodeur. Ce serait une fuite de cible : la mesure n’évaluerait plus ce que le modèle sait retrouver.
Pourquoi figer la représentation ?
Ces deux écritures expriment le même objet :
{"category":"technical","priority":"high","product":"P02"}
{
  "product": "P02",
  "priority": "high",
  "category": "technical"
}
Pourtant, elles ne sont pas la même chaîne de texte. Notre trie n’essaie pas d’autoriser toutes les mises en forme équivalentes : il conserve une écriture canonique par combinaison. Cette décision simplifie les chemins de génération. Elle ne change pas les informations que l’objet représente.
Le corpus comprend aussi des formulations ambiguës, des accolades littérales et du texte non fiable qui tente de modifier l’instruction. Le prompt demande de considérer le ticket comme une donnée, jamais comme une commande. Cette consigne ne constitue pas, à elle seule, une protection complète : un texte malveillant peut encore tenter d’orienter le choix vers une mauvaise valeur pourtant autorisée.
Préparons maintenant les tickets, les objets canoniques et le verrou du prompt :
docker compose run --rm gpu python -m json_decode.cli prepare --config configs/minimum.yaml
À ce stade, nous fixons les éléments de l’expérience. Nous ne corrigeons pas une prédiction et nous n’apprenons pas les annotations au modèle.
Le mécanisme central : référence, trie et génération
Comparer deux voies sur les mêmes tickets
Nous commençons par la référence libre, ou baseline. C’est le comportement de comparaison : le même modèle reçoit le même prompt, mais sans restriction du vocabulaire par le trie.
docker compose run --rm gpu python -m json_decode.cli baseline --config configs/minimum.yaml
docker compose run --rm gpu python -m json_decode.cli inspect-trie --config configs/minimum.yaml
docker compose run --rm gpu python -m json_decode.cli generate --config configs/minimum.yaml
baseline exécute d’abord les 48 tickets de développement et gèle le prompt avant le test. Les erreurs restent enregistrées : nous ne retouchons pas les instructions après lecture des résultats de test pour embellir la comparaison.
inspect-trie rend visible le contrôle de tokenisation. generate exécute les deux modes et conserve les réponses brutes ainsi que les raisons d’arrêt. Les 192 tickets de test sont les mêmes dans les deux voies.
Passer des chaînes à un arbre de tokens
Avant de générer, le projet vérifie l’aller-retour entre texte et tokens afin de conserver les chaînes canoniques ciblées. Ce contrôle appartient à la préparation et à l’inspection : la classe ci-dessous ne contient pas de tokenizer. Elle reçoit des séquences d’identifiants déjà construites.
class TokenTrie:
    def __init__(self, sequences):
        self.children = [{}]
        self.terminal = set()
        for sequence in sequences:
            node = 0
            for token in sequence:
                if token not in self.children[node]:
                    self.children[node][token] = len(self.children)
                    self.children.append({})
                node = self.children[node][token]
            self.terminal.add(node)

    def allowed(self, node, eos_ids):
        return sorted(
            set(self.children[node])
            | (set(eos_ids) if node in self.terminal else set())
        )

    def advance(self, node, token):
        if token not in self.children[node]:
            raise ValueError("Token forbidden by trie")
        return self.children[node][token]
self.children est une liste de dictionnaires. Chaque position représente un nœud de l’arbre. Le premier dictionnaire, à l’indice 0, est la racine. Dans un dictionnaire, la clé est un identifiant de token et la valeur est l’indice du nœud suivant.
Pour chaque réponse, la boucle repart de la racine. Si une branche existe déjà, elle la suit ; sinon, elle crée un nœud. Les débuts communs ne sont donc pas dupliqués. À la fin de chaque séquence, l’indice courant est ajouté à self.terminal.
La méthode allowed() fournit les tokens possibles depuis un nœud. Elle ajoute les identifiants EOS uniquement si ce nœud est terminal. Le tri numérique stabilise la liste retournée : il ne classe pas les tokens selon les préférences du modèle.
Enfin, advance() suit un token ordinaire dans l’arbre et refuse une branche absente. EOS demande un traitement distinct dans la boucle de génération : c’est un signal d’arrêt, pas automatiquement une branche à parcourir avec advance().
Suivre un petit arbre à la main
Prenons deux séquences fictives, [10, 20, 30] et [10, 40, 30], avec 99 comme identifiant EOS. Ces nombres servent seulement à lire le mécanisme : ce ne sont ni des identifiants Qwen relevés, ni une tokenisation réelle de nos JSON.
| Préfixe déjà choisi | Prochains tokens autorisés | Pourquoi ? |
|---|---|---|
| Aucun | 10 |
Les deux séquences commencent ainsi. |
10 |
20 ou 40 |
Les deux chemins se séparent ici. |
10, 20 |
30 |
Un seul chemin reste compatible. |
10, 20, 30 |
99, donc EOS |
La séquence est complète. |
Après 10, 20, choisir 40 ne permettrait plus de finir une des deux séquences enregistrées : le programme le refuse. Autoriser 99 à cet endroit laisserait au contraire s’arrêter au milieu du chemin.
Le vrai trie applique exactement ce principe à des séquences plus longues issues des 48 JSON. Il ne déduit pas leur structure caractère par caractère à partir de cette illustration ; il utilise la tokenisation vérifiée du modèle.
Garder les scores utiles, bloquer les autres
Le trie connaît les tokens admissibles. Le modèle, lui, fournit ses logits. La fonction suivante rapproche les deux :
def select_token(logits, allowed):
    if not allowed:
        raise ValueError("Impossible grammar: no allowed token")
    index = torch.tensor(sorted(allowed), device=logits.device, dtype=torch.long)
    scores = logits[index]
    if (
        torch.isnan(scores).any()
        or torch.isposinf(scores).any()
        or not torch.isfinite(scores).any()
    ):
        raise ValueError("No usable finite allowed logits")
    masked = torch.full_like(logits, -torch.inf)
    masked[index] = scores
    return int(masked.argmax()), masked
index place la liste des identifiants autorisés sur le même périphérique que les logits. scores = logits[index] prélève leurs scores. torch.full_like crée un tableau de même forme rempli de -inf, puis masked[index] = scores rétablit uniquement les valeurs admissibles.
Voici un exemple numérique inventé, sur un vocabulaire réduit à quatre tokens :
| Identifiant du token | Logit proposé | Autorisé ? | Logit après masquage |
|---|---|---|---|
0 |
9 |
Non | -inf |
1 |
2 |
Oui | 2 |
2 |
5 |
Non | -inf |
3 |
-1 |
Oui | -1 |
Sans contrainte, le modèle choisirait le token 0. Avec la contrainte, argmax renvoie 1, l’identifiant du meilleur token encore autorisé. Il ne renvoie pas son score 2. La documentation PyTorch de argmax décrit ce comportement.
Pourquoi ne pas remplacer les scores interdits par zéro ? Parce que les scores autorisés peuvent être négatifs. Un zéro interdit pourrait alors gagner. -inf sert à exclure une possibilité, pas à lui attribuer une note simplement faible.
Que protègent les contrôles numériques ?
Une liste allowed vide indique une grammaire impossible à poursuivre. La fonction s’arrête explicitement au lieu de sélectionner un token arbitraire.
Elle examine ensuite les scores autorisés. NaN désigne une valeur numérique indéfinie ; +inf, l’infini positif. Leur présence provoque une erreur. L’absence de tout score fini provoque également une erreur.
La nuance est utile : un score autorisé égal à -inf reste accepté si au moins un autre score autorisé est fini. L’extrait ne refuse donc pas indistinctement toutes les valeurs non finies. Son objectif est de conserver au moins un choix exploitable sans laisser une anomalie numérique devenir une décision.
Les deux modes utilisent argmax. Le mode libre le fait sur tout le vocabulaire ; le mode contraint, après masquage. C’est un choix local, token après token, et non une comparaison globale des 48 réponses complètes. La contrainte ferme des chemins ; elle n’indique pas lequel décrit correctement le ticket.
Mesurer sans confondre forme et contenu
Les API de génération de Transformers exposent les paramètres et mécanismes de décodage. Leur documentation officielle replace ce travail dans un cadre plus large. Pour cette expérience, gardons cependant les commandes et le code de l’archive : les explications ne nécessitent pas de remplacer le moteur de génération.
Lire la fonction qui attribue les scores
row contient notamment le texte généré et la raison d’arrêt. label contient l’objet attendu pour ce ticket. Nous confrontons la réponse à cette référence seulement au moment de l’évaluation :
def parse_result(row, label):
    try:
        value = json.loads(row["text"])
        valid_json = True
    except (ValueError, TypeError):
        value = None
        valid_json = False
    valid_schema = validate_schema(value)
    complete = row["finish_reason"] == "eos"
    return {
        "json_valid": valid_json,
        "schema_valid": valid_schema,
        "completed": complete,
        "length": row["finish_reason"] == "length",
        "exact_tuple": complete and valid_schema and value == label,
        "fields": {
            k: bool(complete and valid_schema and value[k] == label[k]) for k in SCHEMA
        },
    }
Le premier bloc essaie de convertir row["text"] avec json.loads. S’il échoue, json_valid vaut False. Nous ne retirons pas une phrase introductive, ne supprimons pas un bloc Markdown et ne complétons pas une accolade pour sauver le résultat.
Le contrôle validate_schema(value) pose une deuxième question : l’objet respecte-t-il le contrat ? Son implémentation est dans le projet ; cet extrait montre son utilisation, pas l’ensemble de ses tests internes.
La variable complete dépend uniquement de finish_reason == "eos". Une raison length signifie que la limite de génération a été atteinte. Elle empêche le succès complet, même si le texte est déjà décodable.
Enfin, exact_tuple exige les trois conditions : une fin EOS, un objet conforme et l’égalité avec l’annotation. Le « triplet » désigne les trois valeurs métier ; la réponse manipulée reste ici un dictionnaire Python.
L’égalité value == label porte sur les objets décodés, pas sur l’identité octet par octet du texte brut. Les deux JSON présentés plus haut, dont l’ordre des clés et les espaces diffèrent, donnent donc le même objet pour cette comparaison. La génération canonique est plus étroite que ce critère d’égalité.
Le détail qui change la lecture des scores par champ
Observez le début de l’expression dans fields : complete and valid_schema. Un champ n’obtient un point que si la réponse entière est conforme et terminée par EOS.
Si la réponse contient deux bonnes valeurs et un produit autorisé mais erroné, ces deux champs peuvent être crédités. En revanche, si le produit vaut P99, hors contrat, les trois champs obtiennent zéro : le validateur refuse l’objet entier.
De même, trois valeurs exactes dans une génération arrêtée par length ne rapportent aucun point par champ dans ce protocole. Il s’agit de scores conditionnés par la conformité et la fin de génération, pas d’un relevé de tous les fragments corrects visibles dans le texte.
Comparer six réponses au même exemple
Reprenons notre annotation pédagogique technical / high / P02. Le tableau suivant décrit des cas construits pour comprendre la fonction, pas des sorties capturées du modèle.
Sur mobile, faites défiler le tableau horizontalement.
| Cas | Texte ou modification | Fin | JSON lisible | Schéma valide | Champs crédités | Triplet exact |
|---|---|---|---|---|---|---|
| A | L’objet attendu | eos |
Oui | Oui | 3 sur 3 | Oui |
| B | Même objet, mais product vaut P03 |
eos |
Oui | Oui | 2 sur 3 | Non |
| C | Même objet, mais product vaut P99 |
eos |
Oui | Non | 0 sur 3 | Non |
| D | L’objet attendu, sans autre changement | length |
Oui | Oui | 0 sur 3 | Non |
| E | Le texte Voici le résultat : suivi de l’objet |
eos |
Non | Non | 0 sur 3 | Non |
| F | L’objet attendu, avec clés réordonnées et indentation | eos |
Oui | Oui | 3 sur 3 | Oui |
Les cas A et D montrent pourquoi nous conservons la raison d’arrêt. Les cas B et C montrent la différence entre valeur autorisée mais fausse et valeur interdite. Le cas F rappelle qu’un objet exact n’a pas nécessairement une écriture canonique en mode libre.
Une précision sur le parseur utilisé
Dans cet extrait, json_valid signifie « accepté par json.loads avec ses réglages par défaut ». Python accepte notamment certaines constantes non finies et conserve la dernière valeur d’une clé répétée. La documentation du module json détaille ces comportements. Cet appel seul n’est donc pas un contrôle strict de toutes les particularités de la RFC.
Les 48 chaînes canoniques n’introduisent ni ces constantes ni des clés répétées. Pour une entrée plus générale, il faudrait définir et tester une politique explicite. Cela constituerait une évolution du projet, pas une raison de modifier silencieusement les réponses ou les scores de référence.
Mesures avant résultats
Conserver tous les tickets dans le calcul
Pour chaque mode, evaluate utilise les 192 tickets de test comme dénominateur. Il calcule le taux JSON valide, le taux de schéma valide, la proportion de fins EOS, l’exactitude du triplet et l’exactitude de chaque champ. Aucun ticket raté n’est retiré.
Par exemple, le taux « Produit juste » est le nombre de tickets pour lesquels fields["product"] vaut True, divisé par 192. Ce n’est ni une moyenne sur les seules réponses conformes, ni un pourcentage obtenu en demandant au modèle de se noter.
Pour vérifier que la règle est claire, prenons un mini-lot pédagogique de quatre réponses : les cas A, B, D et E du tableau précédent. Trois textes sont décodables et conformes : A, B et D. Trois fins sont EOS : A, B et E. Pourtant, seul A possède un triplet exact.
Nous obtenons donc 3/4 = 75 % de JSON décodable, 75 % de conformité, 75 % de fins EOS, mais 1/4 = 25 % de triplets exacts. La catégorie et la priorité sont créditées pour A et B, soit 2/4 = 50 % chacune ; le produit seulement pour A, soit 25 %.
Ce petit lot n’est pas une mesure de Qwen. Il montre pourquoi chaque indicateur répond à une question différente. Retirer E, qui ne se décode pas, changerait le dénominateur et embellirait artificiellement plusieurs taux.
Lancer l’évaluation et lire les mesures observées
docker compose run --rm gpu python -m json_decode.cli evaluate --config configs/minimum.yaml
Les valeurs qui suivent sont des mesures locales observées avec cette révision, ce modèle et ce corpus synthétique. Elles ne prévoient pas le taux de réussite sur les tickets de votre entreprise.
Sur mobile, faites défiler le tableau horizontalement.
| Mode, 192 tickets test | JSON valide | Schéma valide | Triplet exact | Catégorie juste | Priorité juste | Produit juste |
|---|---|---|---|---|---|---|
| Libre | 27,60 % | 2,08 % | 0 % | 0 % | 2,08 % | 2,08 % |
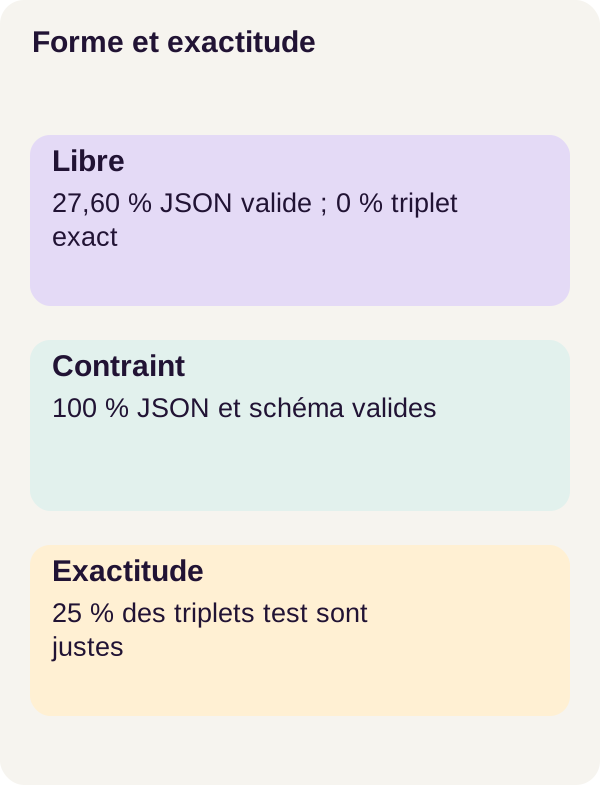
| Contraint | 100 % | 100 % | 25 % | 47,40 % | 64,06 % | 75 % |
Ce que le résultat établit — et ce qu’il n’établit pas
La première observation est nette : dans cette expérience, la voie contrainte produit 100 % de JSON valides et 100 % d’objets conformes. Toutes ses générations se terminent par EOS ; aucune n’atteint la limite maximale de longueur.
La seconde observation est tout aussi importante : seulement 48 des 192 triplets sont exacts, soit 25 %. Les 144 autres réponses contraintes respectent le format mais se trompent sur au moins une valeur. La contrainte a résolu le problème de forme sur ce lot, pas l’ensemble du problème de classification.
Le produit est juste dans 75 % des cas, la priorité dans 64,06 % et la catégorie dans 47,40 %. Ces taux ne s’additionnent pas pour donner un taux de tickets réussis : les champs doivent être justes ensemble, sur le même ticket. Le score du triplet mesure précisément cette exigence.
Les zéros du mode libre demandent davantage de prudence. Le score par champ exige déjà un objet conforme et une fin EOS. Un zéro de catégorie ne signifie donc pas que le mot attendu n’apparaît jamais dans les réponses brutes. Il signifie qu’aucune réponse ne remplit toutes les conditions pour créditer ce champ. Lire les sorties brutes reste nécessaire pour distinguer un problème de présentation d’une erreur de contenu.
Pourquoi le trie peut-il garantir ici une forme sans garantir une réponse juste ? Parce que ses chemins sont construits à partir des seules 48 chaînes autorisées. Cette propriété suppose que la génération suit le trie jusqu’à une fin autorisée. Une interruption ou une défaillance numérique doit rester un échec, pas une réponse réussie par principe.
Enfin, le tableau ne permet pas d’attribuer les erreurs à une cause unique, ni de conclure sur la vitesse d’un mode par rapport à l’autre. Il rapporte les observations de ce protocole, sans isoler l’effet de la taille du modèle, du prompt ou de chaque famille de tickets.
Vérifier les branches refusées
Une démonstration où tout semble bien se passer ne suffit pas. Il faut aussi vérifier les opérations qui doivent échouer : c’est le rôle des cas négatifs.
Le projet contrôle un langage impossible à poursuivre, des préfixes interdits et la règle d’autorisation d’EOS. Lancez ces contrôles après l’évaluation :
docker compose run --rm gpu python -m json_decode.cli negative-cases --config configs/minimum.yaml
Pour un développeur web, c’est l’équivalent d’un test qui envoie volontairement une valeur interdite à un formulaire. Le test réussit lorsque le refus attendu a bien lieu, pas lorsque la mauvaise entrée est acceptée.
Si une branche absente devient franchissable ou si EOS devient possible trop tôt, le mécanisme est cassé, même si quelques tickets produisent encore de beaux JSON. Une erreur attendue qui n’est plus détectée est une régression.
Ce que nous avons appris
Nous avons transformé un contrat de trois champs en un ensemble de réponses, puis en chemins de tokens. Le modèle propose les scores ; le trie indique les choix permis ; le sélecteur choisit parmi eux. Aucune de ces étapes ne consulte l’annotation du ticket pour fournir la bonne réponse.
À l’arrivée, les responsabilités restent séparées. Le parseur contrôle la lecture du texte. Le schéma contrôle les clés et valeurs admises. L’annotation permet de mesurer l’exactitude. La raison d’arrêt indique si la génération s’est terminée comme prévu.
Le résultat 100 % de conformité et 25 % de triplets exacts résume cette distinction : fermer les possibilités de réponse n’ajoute pas au modèle une connaissance du ticket. Nous disposons d’un mécanisme vérifiable de contrôle de forme, pas d’une preuve de justesse métier.
Exercice : émettre une hypothèse avant la commande
Imaginons maintenant une modification : EOS serait autorisé à tous les nœuds du trie, y compris à la racine.
Avant de lancer la commande, écrivez votre prédiction. Si les logits favorisent EOS, le modèle pourrait-il s’arrêter immédiatement ? Pourrait-il terminer après un préfixe JSON incomplet ? Le texte vide serait-il accepté par le parseur ?
Le module src/json_decode/exercise.py compare déjà les deux règles avec des logits contrôlés qui favorisent EOS. Vous n’avez pas à modifier le décodeur de référence. Nous testons volontairement une règle d’arrêt, sans lancer une nouvelle campagne destinée à améliorer les scores.
docker compose run --rm gpu python -m json_decode.cli exercise --config configs/exercise.yaml
Comparez unsafe_immediate_eos, safe_first_token et empty_json_valid à vos prédictions. Le premier permet d’observer la fin immédiate avec la règle dangereuse ; le deuxième montre le choix initial avec la règle protégée ; le troisième vérifie la lecture d’un texte vide.
L’identifiant de safe_first_token appartient à la tokenisation du projet : ne lui substituez pas le 10 de notre arbre fictif. Ce qui compte est qu’il constitue un début autorisé, plutôt qu’un arrêt prématuré.
Pour expliquer le résultat, distinguez autoriser une continuation et accepter un objet terminé. Un texte vide n’est pas un document JSON. Le texte "", qui contient deux guillemets, représente quant à lui une chaîne JSON vide, mais toujours pas l’objet à trois champs exigé ici. La syntaxe et le contrat restent deux contrôles différents.
Adapter le mécanisme et préparer la production
Quand ce trie fini reste pertinent
Ce mécanisme est facile à inspecter parce que le contrat est petit et fermé. Pour le modifier, faites évoluer ensemble la liste des valeurs, la sérialisation, les tests et le validateur indépendant. Conservez une séparation développement/test avant de modifier le prompt.
Le nombre de combinaisons peut toutefois grandir vite. À titre d’illustration, quatre catégories, trois priorités et 10 000 valeurs possibles de produit donneraient 4 × 3 × 10 000 = 120 000 réponses à énumérer. Les préfixes communs peuvent être partagés, mais chaque combinaison doit tout de même être prise en compte par cette construction.
Un champ de commentaire libre ne se décrit plus par les 48 sorties du tutoriel. Il faut alors une grammaire adaptée, des limites de complexité et de longueur, ainsi que des tests de tokenisation. Ce prolongement change le problème ; il ne consiste pas à retirer une garde jusqu’à ce que le programme accepte le nouveau champ.
Une valeur autorisée n’est pas une autorisation d’agir
unknown est prévu pour la catégorie et le produit, pas pour la priorité. Sa présence offre une valeur possible ; elle ne garantit pas que le modèle la choisira quand il hésite. Elle n’est pas non plus une mesure calibrée de son incertitude.
Pour de vrais tickets, il faut des données autorisées et versionnées, des annotations relues et des règles explicites pour traiter les ambiguïtés. Une politique de rejet et, lorsque l’action est sensible, une supervision ou validation humaine restent nécessaires.
L’application doit également prendre en charge l’authentification, le contrôle des droits, l’observabilité — journaux, erreurs et mesures utiles —, les essais de charge, la sauvegarde et l’audit des dépendances. Aucune de ces propriétés ne découle du tableau de scores. Une sortie structurée reste une entrée non fiable tant que le métier ne l’a pas validée.
Dépannage et nettoyage
Le contrôle d’environnement échoue. Arrêtez-vous à check_environment.py. Vérifiez le pilote, NVIDIA Container Toolkit et la carte exposée à Docker. Un problème d’accès GPU ne se corrige pas en modifiant les classes autorisées.
L’inspection du trie échoue. Ne passez pas à generate. Contrôlez d’abord la sérialisation canonique et l’aller-retour tokenisation/décodage. L’arbre doit décrire les chaînes prévues, pas une approximation ressemblante.
Les cas négatifs n’attrapent plus les refus. Examinez les préfixes interdits et la règle EOS avant de relire les scores du modèle. Une démo isolée qui produit du JSON ne répare pas cette régression.
Pour terminer le parcours, générez les figures, contrôlez les checkpoints, prévisualisez le nettoyage et arrêtez les services. Exécutez ces quatre commandes dans cet ordre, toujours depuis la racine du projet :
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
L’option --dry-run demande une prévisualisation : elle sert à examiner le nettoyage envisagé, pas à lancer une suppression. Ne la retirez pas sans avoir inspecté ce qui serait effacé. La dernière commande arrête les ressources Compose du projet ; aucune purge globale des autres projets Docker n’est nécessaire.
Sources primaires
Le format et le code Python. La RFC 8259 — format JSON décrit le langage général. La documentation Python du module json précise la sérialisation, le décodage et leurs particularités ; celle de itertools.product explique l’énumération des combinaisons.
Le modèle et le décodage. La fiche Qwen2.5-0.5B-Instruct à la révision utilisée, la présentation de la tokenisation dans Transformers, l’API de génération Transformers et la fonction torch.argmax approfondissent les composants étudiés.
L’environnement. Le guide d’installation NVIDIA Container Toolkit concerne l’accès GPU depuis les conteneurs.
Ces références complètent l’explication. Pour reproduire les mesures, conservez le code, la révision du modèle et les paramètres figés dans l’archive r1 : les pages de documentation courante ne constituent pas une nouvelle configuration validée du tutoriel.