





Está desarrollando una herramienta de soporte. Para organizar las solicitudes, su aplicación espera una categoría, una prioridad y un producto. Con un formulario convencional, habría previsto tres listas desplegables y comprobado sus valores en el servidor. Pero aquí el usuario escribe un mensaje libre: el modelo debe encontrar los tres datos.
¿Basta con pedirle «responde en JSON» y transmitir su respuesta al resto de la aplicación? No del todo. El modelo puede añadir una frase, olvidar una clave o proponer un valor que su programa no conoce. E incluso cuando respeta perfectamente el formato, puede equivocarse de categoría.
Por tanto, separaremos dos problemas: obtener una respuesta en una forma permitida y comprobar que esa respuesta corresponde al ticket. Para el primero, actuaremos durante la generación, limitando los siguientes tokens que el modelo puede elegir. Para el segundo, mantendremos una comprobación independiente.
Descargar el proyecto completo
El proyecto se ejecuta localmente con Python, Docker y una GPU NVIDIA. Construye un experimento de clasificación, no una interfaz web ni un servicio de soporte listo para desplegar. No toma ninguna decisión de negocio: clasificar un ticket no autoriza a reembolsar un pedido ni a modificar una cuenta.
El problema y la construcción
Tres campos, un número limitado de respuestas
El corpus contiene 240 tickets ficticios en inglés: 48 sirven para desarrollar el prompt y 192 para la prueba. El prompt reúne las instrucciones y el texto enviados al modelo. Aquí, el desarrollo sirve para fijar esas instrucciones; no es un entrenamiento de los pesos del modelo.
Cada respuesta debe asociar los tres campos siguientes:
| Campo | Qué representa | Valores permitidos |
|---|---|---|
category |
La familia de la solicitud | billing, delivery, technical, unknown |
priority |
El nivel de prioridad | low, normal, high |
product |
El producto afectado | P01, P02, P03, unknown |
Conservamos estos nombres y valores en inglés: pertenecen al contrato del programa. Por ejemplo, technical y technique no son dos grafías intercambiables para el validador.
Para seguir el mecanismo, tomemos un ejemplo didáctico añadido a la explicación, distinto de los tickets del corpus y de las salidas medidas:
My P02 device will not start. This is urgent.
Para este ejemplo, fijamos como respuesta de referencia la categoría technical, la prioridad high y el producto P02:
{"category":"technical","priority":"high","product":"P02"}
Esta referencia es una anotación: una respuesta esperada definida independientemente de lo que produzca el modelo. En una aplicación real, decidir qué merece la prioridad high requeriría una regla de negocio explícita.
Hay cuatro opciones de categoría, tres de prioridad y cuatro de producto. Por tanto, el programa puede enumerar 4 × 3 × 4 = 48 combinaciones. Escribe cada una en un orden estable, sin espacios variables: obtenemos 48 cadenas canónicas, es decir, 48 representaciones textuales elegidas como referencia de generación.
Las 48 respuestas posibles y los 48 tickets de desarrollo son dos números con funciones distintas. El primero proviene del contrato; el segundo, de la división del corpus. Cada ticket puede clasificarse en una de esas mismas 48 respuestas.
Pedir, restringir, comprobar: tres operaciones diferentes
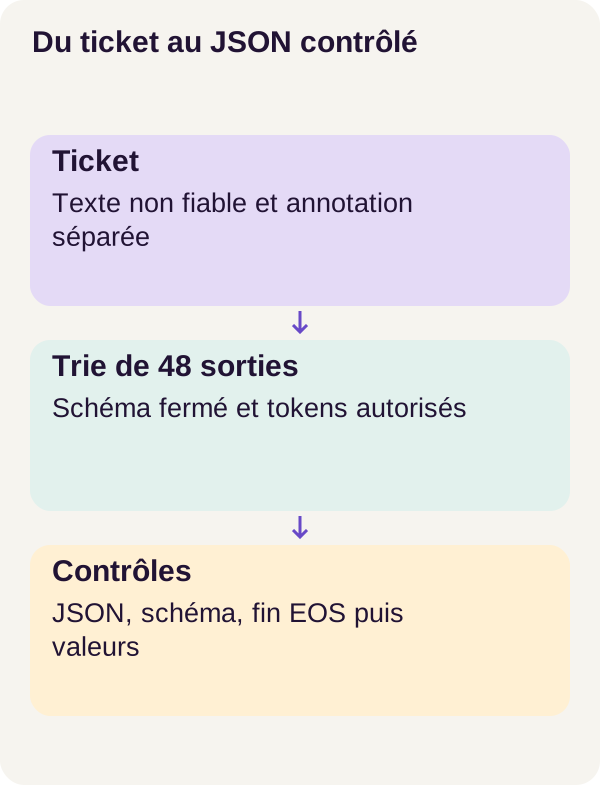
Una instrucción pide al modelo que respete el formato. Una restricción de decodificación impide elegir un token siguiente que salga de los caminos permitidos. Después, un validador examina la respuesta obtenida.
Por tanto, no reparamos después un JSON incompleto. En cada paso, el programa conserva solo los tokens que prolongan una de las 48 cadenas canónicas. La señal de finalización solo se permite cuando una cadena está completa.
Esta pequeña gramática es deliberadamente más estrecha que JSON. No permite texto libre adicional, una nueva clave ni una cantidad arbitraria. La sintaxis general se describe en la RFC 8259; nuestro objetivo es construir un lenguaje finito para este contrato concreto, no un analizador de todo JSON.
Conceptos útiles antes de iniciar la GPU
El modelo propone el siguiente fragmento de texto
Un modelo de lenguaje produce una secuencia de tokens, o unidades. No son necesariamente caracteres ni palabras completas: un token puede representar parte de una palabra o signos. El tokenizer transforma el texto en identificadores numéricos y permite volver al texto. La documentación de Transformers sobre tokenización presenta estas divisiones.
En un instante dado, el modelo recibe el texto ya disponible y calcula una puntuación para cada token del vocabulario. Esa puntuación se llama logit. En este recorrido, elegir la puntuación mayor equivale a elegir el token siguiente; la operación argmax devuelve su índice.
Un logit no es un porcentaje de confianza sobre la categoría correcta del ticket. Interviene en la elección del siguiente fragmento de texto, no en una validación de negocio.
El trie describe las continuaciones permitidas
Un trie es un árbol de prefijos. Un prefijo es simplemente el inicio de una secuencia. Varias respuestas que empiezan igual comparten el comienzo de un camino y se separan donde sus tokens difieren.
Imagine un autocompletado que solo autorizara las continuaciones de un catálogo cerrado. Tras cada elección, se avanza en el catálogo de caminos restantes. El trie no lee el ticket ni sabe qué categoría es correcta: solo sabe qué tokens aún pueden conducir a una respuesta permitida.
Si A(s) designa los tokens permitidos después del prefijo s, conservamos sus logits y sustituimos todos los demás por menos infinito, anotado -inf. Así, argmax elige entre las continuaciones admisibles, mientras al menos una tenga una puntuación finita. Seguiremos un ejemplo numérico en el código.
Terminar la generación también es una decisión
EOS, por end of sequence, es un token especial que indica el final. No es la llave } de JSON. El programa debe distinguir entre «el objeto está completo» y «la generación terminó según la regla prevista».
Permitir EOS desde el principio dejaría que el modelo se detuviera sin escribir nada. Aquí, EOS solo se propone en un nodo terminal del trie, es decir, tras una secuencia completa. Sin embargo, un límite de longitud puede interrumpir la ejecución antes de ese final: también mediremos este caso.
Tres preguntas que hacer a la respuesta
¿Es legible? ¿Puede el analizador convertir el texto en un valor JSON? ¿Es conforme? ¿Se encuentran las tres claves y sus valores permitidos? ¿Es exacta? ¿Los valores corresponden a la anotación del ticket?
En nuestro ejemplo, sustituir P02 por P03 no rompe ni la sintaxis ni el contrato: P03 es un producto permitido. Sin embargo, la respuesta pasa a ser incorrecta. Precisamente esta diferencia hará visible el experimento.
Requisitos previos de Docker y GPU
Debe saber leer funciones de Python, listas y diccionarios, usar JSON, un terminal y los fundamentos de Docker. Las nociones de decodificación se explican en el recorrido; no es necesaria experiencia previa de entrenamiento.
El entorno validado usa Linux x86_64, Docker con Compose, NVIDIA Container Toolkit y una RTX 3090 de 24 GiB. Prevea 16 GiB de RAM y 16 GiB de disco, sin contar las capas Docker compartidas. La memoria de vídeo, o VRAM, pertenece a la tarjeta gráfica; no sustituye la RAM del equipo. No se presenta ninguna ejecución en CPU como equivalente a este recorrido con GPU.
El modelo es Qwen2.5-0.5B-Instruct, en la revisión pública fija 7ae557604adf67be50417f59c2c2f167def9a775. «Instruct» designa su adaptación para seguir instrucciones; no garantiza que las siga sin errores. Transformers lo carga localmente, sin código remoto. La ficha del modelo en esa revisión completa su descripción.
El modelo ya contiene pesos, los parámetros numéricos adquiridos durante su entrenamiento. Aquí los usamos para calcular salidas: es la inferencia. Construir el trie o modificar los tokens permitidos no entrena esos pesos.
Extraiga el archivo y abra el terminal en su raíz. Todos los comandos del artículo parten de esa misma carpeta. setup.sh prepara los directorios y solo escribe UID/GID en .env: esos identificadores conciernen a los permisos del usuario y del grupo sobre los archivos.
acquire descarga los archivos públicos, los verifica y solo los coloca con su nombre final tras validarlos, mediante un renombrado atómico. models/ conserva esa versión local, llamada snapshot; outputs/ recibe las medidas y artifacts/ los checkpoints del proyecto. No confunda estos archivos de control con un nuevo entrenamiento.
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
Los cinco comandos tienen responsabilidades distintas. config --quiet verifica la configuración de Compose. build construye las imágenes necesarias. acquire.py prepara los archivos del modelo. Por último, check_environment.py debe completarse correctamente antes de la inferencia.
CUDA permite aquí ejecutar los cálculos en la GPU NVIDIA. Que la tarjeta sea visible en Linux no basta para demostrar que puede usarse desde Docker. Si CUDA no se inicializa en el contenedor, empiece por la documentación de NVIDIA Container Toolkit, en lugar de modificar el decodificador.
Las capas Docker ya presentes pueden acortar la construcción de las imágenes. Este tiempo de preparación no es una medida de la decodificación del modelo.
Comprobar el programa antes que el motor
Antes de pedir al modelo que clasifique los tickets, comprobemos las reglas que lo rodearán. La suite pública cubre el esquema, el trie y los escenarios de fallo. Ejecútela después de la comprobación de GPU:
docker compose run --rm gpu python -m pytest -q
Un resultado correcto significa que los comportamientos probados del programa corresponden a lo esperado. Aún no significa que el modelo comprenderá los tickets. Es la misma diferencia que hay entre probar el validador de un formulario y verificar la exactitud de la información introducida.
No se salte este paso para obtener antes un primer JSON: una salida plausible no permitiría detectar una rama prohibida aceptada por error.
Datos y contrato de salida
Construir las respuestas posibles sin conocer la correcta
Para restringir el modelo necesitamos todas las respuestas permitidas, no la respuesta esperada para un ticket concreto. Por ello, la función siguiente no recibe ningún ticket ni anotación:
def enumerate_canonical_outputs():
    return [
        json.dumps(dict(zip(SCHEMA, values)), separators=(",", ":"))
        for values in itertools.product(*SCHEMA.values())
    ]
En este fragmento, SCHEMA es la correspondencia entre los nombres de campos y sus listas de valores. El nombre no implica que sea un documento en el formato estándar JSON Schema: aquí el código recorre un contrato enumerado.
SCHEMA.values() proporciona las listas de opciones. El asterisco de itertools.product(*SCHEMA.values()) las transmite como argumentos separados. El producto cartesiano genera todas las combinaciones, como tres bucles anidados: una categoría, después una prioridad y después un producto. La documentación de itertools.product detalla esta operación.
Para una combinación como ("technical", "high", "P02"), zip(SCHEMA, values) asocia cada nombre a su valor. dict(...) construye el objeto; json.dumps(...) lo convierte en texto. Por último, separators=(",", ":") impone la escritura compacta, sin espacios entre los elementos.
Obtenemos las 48 cadenas prometidas. No hemos elegido la que corresponde al ticket. Construir, por el contrario, un trie que solo contuviera su anotación equivaldría a dar la respuesta al decodificador. Sería una fuga del objetivo: la medida dejaría de evaluar lo que el modelo sabe encontrar.
¿Por qué fijar la representación?
Estas dos escrituras expresan el mismo objeto:
{"category":"technical","priority":"high","product":"P02"}
{
  "product": "P02",
  "priority": "high",
  "category": "technical"
}
Sin embargo, no son la misma cadena de texto. Nuestro trie no intenta permitir todos los formatos equivalentes: conserva una escritura canónica por combinación. Esta decisión simplifica los caminos de generación. No cambia la información que representa el objeto.
El corpus incluye también formulaciones ambiguas, llaves literales y texto no fiable que intenta modificar la instrucción. El prompt pide considerar el ticket como un dato, nunca como un comando. Esta instrucción no constituye por sí sola una protección completa: un texto malicioso aún puede intentar orientar la elección hacia un valor incorrecto pero permitido.
Preparemos ahora los tickets, los objetos canónicos y el bloqueo del prompt:
docker compose run --rm gpu python -m json_decode.cli prepare --config configs/minimum.yaml
En este punto fijamos los elementos del experimento. No corregimos una predicción ni enseñamos las anotaciones al modelo.
El mecanismo central: referencia, trie y generación
Comparar dos vías con los mismos tickets
Comenzamos por la referencia libre, o baseline. Es el comportamiento de comparación: el mismo modelo recibe el mismo prompt, pero sin restricción del vocabulario por el trie.
docker compose run --rm gpu python -m json_decode.cli baseline --config configs/minimum.yaml
docker compose run --rm gpu python -m json_decode.cli inspect-trie --config configs/minimum.yaml
docker compose run --rm gpu python -m json_decode.cli generate --config configs/minimum.yaml
baseline ejecuta primero los 48 tickets de desarrollo y fija el prompt antes de la prueba. Los errores quedan registrados: no retocamos las instrucciones tras leer los resultados de prueba para embellecer la comparación.
inspect-trie hace visible el control de tokenización. generate ejecuta ambos modos y conserva las respuestas sin procesar y los motivos de parada. Los 192 tickets de prueba son los mismos en las dos vías.
Pasar de cadenas a un árbol de tokens
Antes de generar, el proyecto comprueba el recorrido de ida y vuelta entre texto y tokens para conservar las cadenas canónicas objetivo. Esta comprobación pertenece a la preparación y a la inspección: la clase siguiente no contiene un tokenizer. Recibe secuencias de identificadores ya construidas.
class TokenTrie:
    def __init__(self, sequences):
        self.children = [{}]
        self.terminal = set()
        for sequence in sequences:
            node = 0
            for token in sequence:
                if token not in self.children[node]:
                    self.children[node][token] = len(self.children)
                    self.children.append({})
                node = self.children[node][token]
            self.terminal.add(node)

    def allowed(self, node, eos_ids):
        return sorted(
            set(self.children[node])
            | (set(eos_ids) if node in self.terminal else set())
        )

    def advance(self, node, token):
        if token not in self.children[node]:
            raise ValueError("Token forbidden by trie")
        return self.children[node][token]
self.children es una lista de diccionarios. Cada posición representa un nodo del árbol. El primer diccionario, en el índice 0, es la raíz. En un diccionario, la clave es un identificador de token y el valor es el índice del nodo siguiente.
Para cada respuesta, el bucle vuelve a partir de la raíz. Si una rama ya existe, la sigue; si no, crea un nodo. Por tanto, los comienzos comunes no se duplican. Al final de cada secuencia, el índice actual se añade a self.terminal.
El método allowed() proporciona los tokens posibles desde un nodo. Añade los identificadores EOS solo si ese nodo es terminal. La ordenación numérica estabiliza la lista devuelta: no clasifica los tokens según las preferencias del modelo.
Por último, advance() sigue un token ordinario en el árbol y rechaza una rama ausente. EOS requiere un tratamiento distinto en el bucle de generación: es una señal de parada, no automáticamente una rama que recorrer con advance().
Seguir a mano un árbol pequeño
Tomemos dos secuencias ficticias, [10, 20, 30] y [10, 40, 30], con 99 como identificador EOS. Estos números solo sirven para leer el mecanismo: no son ni identificadores Qwen registrados ni una tokenización real de nuestros JSON.
| Prefijo ya elegido | Siguientes tokens permitidos | ¿Por qué? |
|---|---|---|
| Ninguno | 10 |
Las dos secuencias empiezan así. |
10 |
20 o 40 |
Los dos caminos se separan aquí. |
10, 20 |
30 |
Solo queda compatible un camino. |
10, 20, 30 |
99, por tanto EOS |
La secuencia está completa. |
Después de 10, 20, elegir 40 ya no permitiría terminar una de las dos secuencias registradas: el programa lo rechaza. Permitir 99 en ese punto, por el contrario, dejaría detenerse a mitad del camino.
El trie real aplica exactamente este principio a secuencias más largas procedentes de los 48 JSON. No deduce su estructura carácter a carácter a partir de esta ilustración; utiliza la tokenización verificada del modelo.
Conservar las puntuaciones útiles, bloquear las demás
El trie conoce los tokens admisibles. El modelo proporciona sus logits. La función siguiente reúne ambos:
def select_token(logits, allowed):
    if not allowed:
        raise ValueError("Impossible grammar: no allowed token")
    index = torch.tensor(sorted(allowed), device=logits.device, dtype=torch.long)
    scores = logits[index]
    if (
        torch.isnan(scores).any()
        or torch.isposinf(scores).any()
        or not torch.isfinite(scores).any()
    ):
        raise ValueError("No usable finite allowed logits")
    masked = torch.full_like(logits, -torch.inf)
    masked[index] = scores
    return int(masked.argmax()), masked
index coloca la lista de identificadores permitidos en el mismo dispositivo que los logits. scores = logits[index] extrae sus puntuaciones. torch.full_like crea una tabla de la misma forma llena de -inf; después, masked[index] = scores restablece únicamente los valores admisibles.
He aquí un ejemplo numérico inventado, con un vocabulario reducido a cuatro tokens:
| Identificador del token | Logit propuesto | ¿Permitido? | Logit tras el enmascaramiento |
|---|---|---|---|
0 |
9 |
No | -inf |
1 |
2 |
Sí | 2 |
2 |
5 |
No | -inf |
3 |
-1 |
Sí | -1 |
Sin restricción, el modelo elegiría el token 0. Con la restricción, argmax devuelve 1, el identificador del mejor token que sigue permitido. No devuelve su puntuación 2. La documentación de PyTorch de argmax describe este comportamiento.
¿Por qué no sustituir las puntuaciones prohibidas por cero? Porque las puntuaciones permitidas pueden ser negativas. Entonces un cero prohibido podría ganar. -inf sirve para excluir una posibilidad, no para asignarle una nota simplemente baja.
¿Qué protegen las comprobaciones numéricas?
Una lista allowed vacía indica una gramática imposible de continuar. La función se detiene explícitamente en vez de seleccionar un token arbitrario.
Después examina las puntuaciones permitidas. NaN designa un valor numérico indefinido; +inf, el infinito positivo. Su presencia provoca un error. La ausencia de cualquier puntuación finita también provoca un error.
El matiz es útil: una puntuación permitida igual a -inf sigue aceptada si al menos otra puntuación permitida es finita. Por tanto, el fragmento no rechaza indistintamente todos los valores no finitos. Su objetivo es conservar al menos una elección utilizable sin dejar que una anomalía numérica se convierta en una decisión.
Ambos modos usan argmax. El modo libre lo hace sobre todo el vocabulario; el modo restringido, después del enmascaramiento. Es una elección local, token a token, y no una comparación global de las 48 respuestas completas. La restricción cierra caminos; no indica cuál describe correctamente el ticket.
Medir sin confundir forma y contenido
Las API de generación de Transformers exponen los parámetros y mecanismos de decodificación. Su documentación oficial sitúa este trabajo en un marco más amplio. Para este experimento, mantengamos sin embargo los comandos y el código del archivo: las explicaciones no requieren reemplazar el motor de generación.
Leer la función que asigna las puntuaciones
row contiene, entre otros datos, el texto generado y el motivo de parada. label contiene el objeto esperado para este ticket. Solo confrontamos la respuesta con esta referencia en el momento de la evaluación:
def parse_result(row, label):
    try:
        value = json.loads(row["text"])
        valid_json = True
    except (ValueError, TypeError):
        value = None
        valid_json = False
    valid_schema = validate_schema(value)
    complete = row["finish_reason"] == "eos"
    return {
        "json_valid": valid_json,
        "schema_valid": valid_schema,
        "completed": complete,
        "length": row["finish_reason"] == "length",
        "exact_tuple": complete and valid_schema and value == label,
        "fields": {
            k: bool(complete and valid_schema and value[k] == label[k]) for k in SCHEMA
        },
    }
El primer bloque intenta convertir row["text"] con json.loads. Si falla, json_valid vale False. No retiramos una frase introductoria, no eliminamos un bloque Markdown ni completamos una llave para salvar el resultado.
La comprobación validate_schema(value) plantea una segunda pregunta: ¿el objeto respeta el contrato? Su implementación está en el proyecto; este fragmento muestra su uso, no todas sus pruebas internas.
La variable complete depende únicamente de finish_reason == "eos". Un motivo length significa que se alcanzó el límite de generación. Impide el éxito completo, aunque el texto ya pueda decodificarse.
Por último, exact_tuple exige las tres condiciones: un final EOS, un objeto conforme y la igualdad con la anotación. El «triplete» designa los tres valores de negocio; la respuesta manipulada sigue siendo aquí un diccionario de Python.
La igualdad value == label se aplica a los objetos decodificados, no a la identidad byte por byte del texto bruto. Los dos JSON presentados antes, cuyo orden de claves y espacios difieren, dan por tanto el mismo objeto para esta comparación. La generación canónica es más estrecha que este criterio de igualdad.
El detalle que cambia la lectura de las puntuaciones por campo
Observe el comienzo de la expresión en fields: complete and valid_schema. Un campo solo obtiene un punto si la respuesta completa es conforme y termina con EOS.
Si la respuesta contiene dos valores correctos y un producto permitido pero erróneo, esos dos campos pueden acreditarse. En cambio, si el producto vale P99, fuera de contrato, los tres campos obtienen cero: el validador rechaza el objeto entero.
Del mismo modo, tres valores exactos en una generación detenida por length no aportan ningún punto por campo en este protocolo. Son puntuaciones condicionadas por la conformidad y el final de generación, no un recuento de todos los fragmentos correctos visibles en el texto.
Comparar seis respuestas con el mismo ejemplo
Retomemos nuestra anotación didáctica technical / high / P02. La tabla siguiente describe casos construidos para entender la función, no salidas capturadas del modelo.
En móvil, desplace la tabla horizontalmente.
| Caso | Texto o modificación | Final | JSON legible | Esquema válido | Campos acreditados | Triplete exacto |
|---|---|---|---|---|---|---|
| A | El objeto esperado | eos |
Sí | Sí | 3 de 3 | Sí |
| B | Mismo objeto, pero product vale P03 |
eos |
Sí | Sí | 2 de 3 | No |
| C | Mismo objeto, pero product vale P99 |
eos |
Sí | No | 0 de 3 | No |
| D | El objeto esperado, sin otro cambio | length |
Sí | Sí | 0 de 3 | No |
| E | El texto Voici le résultat : seguido del objeto |
eos |
No | No | 0 de 3 | No |
| F | El objeto esperado, con claves reordenadas y sangría | eos |
Sí | Sí | 3 de 3 | Sí |
Los casos A y D muestran por qué conservamos el motivo de parada. Los casos B y C muestran la diferencia entre valor permitido pero incorrecto y valor prohibido. El caso F recuerda que un objeto exacto no necesariamente tiene una escritura canónica en modo libre.
Una precisión sobre el analizador utilizado
En este fragmento, json_valid significa «aceptado por json.loads con sus ajustes predeterminados». Python acepta, entre otras cosas, ciertas constantes no finitas y conserva el último valor de una clave repetida. La documentación del módulo json detalla estos comportamientos. Esta llamada por sí sola no es, por tanto, una comprobación estricta de todas las particularidades de la RFC.
Las 48 cadenas canónicas no introducen ni esas constantes ni claves repetidas. Para una entrada más general habría que definir y probar una política explícita. Eso constituiría una evolución del proyecto, no un motivo para modificar silenciosamente las respuestas o las puntuaciones de referencia.
Medidas antes de los resultados
Conservar todos los tickets en el cálculo
Para cada modo, evaluate usa los 192 tickets de prueba como denominador. Calcula la tasa de JSON válido, la tasa de esquema válido, la proporción de finales EOS, la exactitud del triplete y la exactitud de cada campo. No se elimina ningún ticket fallido.
Por ejemplo, la tasa «Producto correcto» es el número de tickets para los que fields["product"] vale True, dividido entre 192. No es ni una media sobre las únicas respuestas conformes ni un porcentaje obtenido pidiendo al modelo que se puntúe a sí mismo.
Para comprobar que la regla es clara, tomemos un minilote didáctico de cuatro respuestas: los casos A, B, D y E de la tabla anterior. Tres textos son decodificables y conformes: A, B y D. Tres finales son EOS: A, B y E. Sin embargo, solo A tiene un triplete exacto.
Obtenemos por tanto 3/4 = 75 % de JSON decodificable, 75 % de conformidad, 75 % de finales EOS, pero 1/4 = 25 % de tripletes exactos. La categoría y la prioridad se acreditan para A y B, es decir, 2/4 = 50 % cada una; el producto solo para A, es decir, 25 %.
Este pequeño lote no es una medición de Qwen. Muestra por qué cada indicador responde a una pregunta distinta. Retirar E, que no se decodifica, cambiaría el denominador y embellecería artificialmente varias tasas.
Ejecutar la evaluación y leer las medidas observadas
docker compose run --rm gpu python -m json_decode.cli evaluate --config configs/minimum.yaml
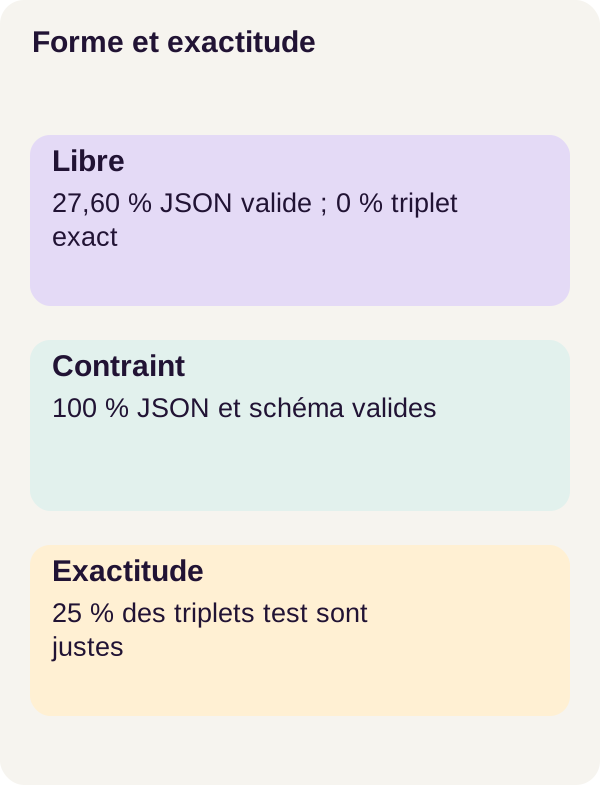
Los valores siguientes son medidas locales observadas con esta revisión, este modelo y este corpus sintético. No predicen la tasa de éxito en los tickets de su empresa.
En móvil, desplace la tabla horizontalmente.
| Modo, 192 tickets de prueba | JSON válido | Esquema válido | Triplete exacto | Categoría correcta | Prioridad correcta | Producto correcto |
|---|---|---|---|---|---|---|
| Libre | 27,60 % | 2,08 % | 0 % | 0 % | 2,08 % | 2,08 % |
| Restringido | 100 % | 100 % | 25 % | 47,40 % | 64,06 % | 75 % |
Lo que el resultado demuestra, y lo que no demuestra
La primera observación es clara: en este experimento, la vía restringida produce 100 % de JSON válidos y 100 % de objetos conformes. Todas sus generaciones terminan con EOS; ninguna alcanza el límite máximo de longitud.
La segunda observación es igual de importante: solo 48 de los 192 tripletes son exactos, es decir, el 25 %. Las otras 144 respuestas restringidas respetan el formato, pero se equivocan en al menos un valor. La restricción resolvió el problema de la forma en este lote, no todo el problema de clasificación.
El producto es correcto en el 75 % de los casos, la prioridad en el 64,06 % y la categoría en el 47,40 %. Estas tasas no se suman para obtener una tasa de tickets correctos: los campos deben ser correctos a la vez, en el mismo ticket. La puntuación del triplete mide precisamente esta exigencia.
Los ceros del modo libre exigen más prudencia. La puntuación por campo ya requiere un objeto conforme y un final EOS. Por tanto, un cero en categoría no significa que la palabra esperada nunca aparezca en las respuestas brutas. Significa que ninguna respuesta cumple todas las condiciones para acreditar ese campo. Seguir leyendo las salidas brutas es necesario para distinguir un problema de presentación de un error de contenido.
¿Por qué el trie puede garantizar aquí una forma sin garantizar una respuesta correcta? Porque sus caminos se construyen solo a partir de las 48 cadenas permitidas. Esta propiedad supone que la generación sigue el trie hasta un final permitido. Una interrupción o un fallo numérico debe seguir siendo un fallo, no una respuesta aprobada por principio.
Por último, la tabla no permite atribuir los errores a una causa única ni concluir sobre la velocidad de un modo frente al otro. Informa de las observaciones de este protocolo, sin aislar el efecto del tamaño del modelo, del prompt o de cada familia de tickets.
Comprobar las ramas rechazadas
Una demostración donde todo parece ir bien no basta. También hay que comprobar las operaciones que deben fallar: ese es el papel de los casos negativos.
El proyecto controla un lenguaje imposible de continuar, prefijos prohibidos y la regla de autorización de EOS. Ejecute estas comprobaciones después de la evaluación:
docker compose run --rm gpu python -m json_decode.cli negative-cases --config configs/minimum.yaml
Para un desarrollador web, es el equivalente de una prueba que envía deliberadamente un valor prohibido a un formulario. La prueba tiene éxito cuando se produce el rechazo esperado, no cuando se acepta la entrada incorrecta.
Si una rama ausente se vuelve transitable o si EOS pasa a ser posible demasiado pronto, el mecanismo está roto, aunque algunos tickets sigan produciendo JSON bonitos. Un error esperado que deja de detectarse es una regresión.
Lo que hemos aprendido
Hemos transformado un contrato de tres campos en un conjunto de respuestas y después en caminos de tokens. El modelo propone las puntuaciones; el trie indica las opciones permitidas; el selector elige entre ellas. Ninguna de estas etapas consulta la anotación del ticket para proporcionar la respuesta correcta.
Al final, las responsabilidades siguen separadas. El analizador controla la lectura del texto. El esquema controla las claves y valores admitidos. La anotación permite medir la exactitud. El motivo de parada indica si la generación terminó como estaba previsto.
El resultado de 100 % de conformidad y 25 % de tripletes exactos resume esta distinción: cerrar las posibilidades de respuesta no añade al modelo conocimiento sobre el ticket. Contamos con un mecanismo verificable de control de forma, no con una prueba de exactitud de negocio.
Ejercicio: plantear una hipótesis antes del comando
Imaginemos ahora una modificación: EOS se permitiría en todos los nodos del trie, incluida la raíz.
Antes de ejecutar el comando, escriba su predicción. Si los logits favorecen EOS, ¿podría el modelo detenerse inmediatamente? ¿Podría terminar tras un prefijo JSON incompleto? ¿Aceptaría el analizador el texto vacío?
El módulo src/json_decode/exercise.py ya compara las dos reglas con logits controlados que favorecen EOS. No tiene que modificar el decodificador de referencia. Probamos deliberadamente una regla de parada, sin ejecutar una nueva campaña destinada a mejorar las puntuaciones.
docker compose run --rm gpu python -m json_decode.cli exercise --config configs/exercise.yaml
Compare unsafe_immediate_eos, safe_first_token y empty_json_valid con sus predicciones. El primero permite observar el final inmediato con la regla peligrosa; el segundo muestra la elección inicial con la regla protegida; el tercero comprueba la lectura de un texto vacío.
El identificador de safe_first_token pertenece a la tokenización del proyecto: no lo sustituya por el 10 de nuestro árbol ficticio. Lo importante es que constituye un comienzo permitido, en vez de una parada prematura.
Para explicar el resultado, distinga entre permitir una continuación y aceptar un objeto terminado. Un texto vacío no es un documento JSON. El texto "", que contiene dos comillas, representa en cambio una cadena JSON vacía, pero tampoco el objeto de tres campos exigido aquí. La sintaxis y el contrato siguen siendo dos controles distintos.
Adaptar el mecanismo y preparar la producción
Cuándo sigue siendo pertinente este trie finito
Este mecanismo es fácil de inspeccionar porque el contrato es pequeño y cerrado. Para modificarlo, haga evolucionar conjuntamente la lista de valores, la serialización, las pruebas y el validador independiente. Conserve una separación entre desarrollo y prueba antes de modificar el prompt.
No obstante, el número de combinaciones puede crecer rápidamente. A título ilustrativo, cuatro categorías, tres prioridades y 10 000 valores posibles de producto darían 4 × 3 × 10 000 = 120 000 respuestas que enumerar. Los prefijos comunes pueden compartirse, pero esta construcción debe tener en cuenta cada combinación.
Un campo de comentario libre ya no se describe mediante las 48 salidas del tutorial. Entonces se necesita una gramática adaptada, límites de complejidad y longitud, y pruebas de tokenización. Esta extensión cambia el problema; no consiste en retirar una protección hasta que el programa acepte el nuevo campo.
Un valor permitido no es una autorización para actuar
unknown está previsto para la categoría y el producto, no para la prioridad. Su presencia ofrece un valor posible; no garantiza que el modelo lo elija cuando duda. Tampoco es una medida calibrada de su incertidumbre.
Para tickets reales se necesitan datos autorizados y versionados, anotaciones revisadas y reglas explícitas para tratar las ambigüedades. Siguen siendo necesarias una política de rechazo y, cuando la acción es sensible, supervisión o validación humana.
La aplicación también debe gestionar la autenticación, el control de derechos, la observabilidad —registros, errores y medidas útiles—, las pruebas de carga, la copia de seguridad y la auditoría de dependencias. Ninguna de estas propiedades se deriva de la tabla de puntuaciones. Una salida estructurada sigue siendo una entrada no fiable mientras el negocio no la haya validado.
Solución de problemas y limpieza
La comprobación de entorno falla. Deténgase en check_environment.py. Compruebe el controlador, NVIDIA Container Toolkit y la tarjeta expuesta a Docker. Un problema de acceso a la GPU no se corrige modificando las clases permitidas.
La inspección del trie falla. No pase a generate. Compruebe primero la serialización canónica y el recorrido de tokenización/decodificación. El árbol debe describir las cadenas previstas, no una aproximación que se les parezca.
Los casos negativos ya no detectan los rechazos. Examine los prefijos prohibidos y la regla EOS antes de volver a leer las puntuaciones del modelo. Una demostración aislada que produce JSON no corrige esta regresión.
Para terminar el recorrido, genere las figuras, compruebe los checkpoints, previsualice la limpieza y detenga los servicios. Ejecute estos cuatro comandos en este orden, siempre desde la raíz del proyecto:
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
La opción --dry-run solicita una previsualización: sirve para examinar la limpieza prevista, no para iniciar una eliminación. No la retire sin haber inspeccionado lo que se borraría. El último comando detiene los recursos Compose del proyecto; no es necesaria ninguna purga global de otros proyectos Docker.
Fuentes primarias
El formato y el código Python. La RFC 8259 — formato JSON describe el lenguaje general. La documentación Python del módulo json precisa la serialización, la decodificación y sus particularidades; la de itertools.product explica la enumeración de combinaciones.
El modelo y la decodificación. La ficha de Qwen2.5-0.5B-Instruct en la revisión utilizada, la presentación de la tokenización en Transformers, la API de generación de Transformers y la función torch.argmax profundizan en los componentes estudiados.
El entorno. La guía de instalación de NVIDIA Container Toolkit trata sobre el acceso a la GPU desde contenedores.
Estas referencias completan la explicación. Para reproducir las medidas, conserve el código, la revisión del modelo y los parámetros fijados en el archivo r1: las páginas de documentación actuales no constituyen una nueva configuración validada del tutorial.