





State sviluppando uno strumento di assistenza. Per ordinare le richieste, la vostra applicazione attende una categoria, una priorità e un prodotto. Con un modulo classico avreste previsto tre menu a tendina, poi verificato i valori lato server. Qui però l'utente scrive un messaggio libero: spetta al modello ritrovare le tre informazioni.
Possiamo limitarci a chiedergli «rispondi in JSON» e trasmettere la risposta al resto dell'applicazione? Non proprio. Il modello può aggiungere una frase, dimenticare una chiave o proporre un valore che il programma non conosce. E anche quando rispetta perfettamente il formato, può sbagliare categoria.
Separiamo quindi due problemi: ottenere una risposta in una forma autorizzata, poi verificare che corrisponda al ticket. Per il primo interverremo durante la generazione, limitando i prossimi token che il modello può scegliere. Per il secondo conserveremo un controllo indipendente.
Scaricare il progetto completo
Il progetto viene eseguito localmente con Python, Docker e una GPU NVIDIA. Costruisce un esperimento di classificazione, non un'interfaccia web né un servizio di assistenza pronto al rilascio. Non prende alcuna decisione di business: classificare un ticket non autorizza un rimborso o la modifica di un account.
Il problema e la costruzione
Tre campi, un numero limitato di risposte
Il corpus contiene 240 ticket fittizi in inglese: 48 servono allo sviluppo del prompt e 192 al test. Il prompt è l'insieme delle istruzioni e del testo inviati al modello. Qui lo sviluppo serve a fissare tali istruzioni; non è un addestramento dei pesi del modello.
Ogni risposta deve associare i tre campi seguenti:
| Campo | Cosa rappresenta | Valori autorizzati |
|---|---|---|
category |
La famiglia della richiesta | billing, delivery, technical, unknown |
priority |
Il livello di priorità | low, normal, high |
product |
Il prodotto interessato | P01, P02, P03, unknown |
Conserviamo questi nomi e valori in inglese: appartengono al contratto del programma. Per esempio, technical e technique non sono due grafie intercambiabili per il validatore.
Per seguire il meccanismo, prendiamo un esempio didattico aggiunto alla spiegazione, distinto dai ticket del corpus e dagli output misurati:
My P02 device will not start. This is urgent.
Per questo esempio fissiamo come risposta di riferimento la categoria technical, la priorità high e il prodotto P02:
{"category":"technical","priority":"high","product":"P02"}
Questo riferimento è un'annotazione: una risposta attesa definita indipendentemente da ciò che produrrà il modello. In un'applicazione reale, stabilire cosa merita la priorità high richiederebbe una regola di business esplicita.
Esistono quattro scelte di categoria, tre di priorità e quattro di prodotto. Il programma può quindi enumerare 4 × 3 × 4 = 48 combinazioni. Le scrive ciascuna in un ordine stabile, senza spazi variabili: otteniamo 48 stringhe canoniche, ossia 48 rappresentazioni testuali scelte come riferimento per la generazione.
Le 48 risposte possibili e i 48 ticket di sviluppo sono due numeri distinti per funzione. Il primo deriva dal contratto; il secondo dalla suddivisione del corpus. Ogni ticket può essere classificato in una delle stesse 48 risposte.
Chiedere, vincolare, verificare: tre operazioni diverse
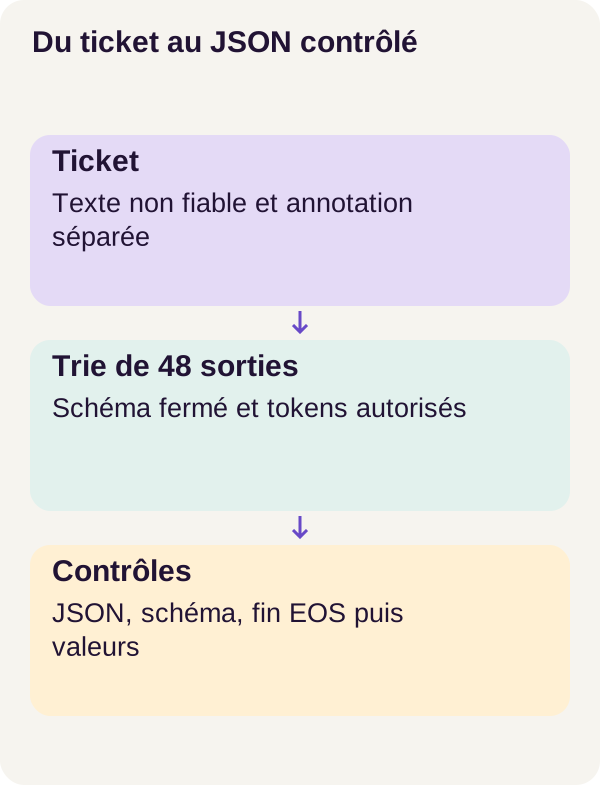
Un'istruzione chiede al modello di rispettare il formato. Un vincolo di decodifica gli impedisce di scegliere un token successivo che uscirebbe dai percorsi autorizzati. Un validatore esamina poi la risposta ottenuta.
Non ripariamo quindi un JSON incompleto a posteriori. A ogni passaggio il programma conserva soltanto i token che prolungano una delle 48 stringhe canoniche. Il segnale di fine diventa autorizzato solo quando una stringa è completa.
Questa piccola grammatica è volutamente più ristretta di JSON. Non autorizza testo libero aggiuntivo, una nuova chiave o un importo arbitrario. La sintassi generale è descritta nella RFC 8259; il nostro obiettivo è costruire un linguaggio finito per questo contratto preciso, non un parser per tutto JSON.
Concetti utili prima di avviare la GPU
Il modello propone il prossimo frammento di testo
Un modello linguistico produce una sequenza di token, o gettoni. Non sono necessariamente caratteri né parole complete: un token può rappresentare una parte di parola o dei segni. Il tokenizer trasforma il testo in identificatori numerici e permette di tornare al testo. La documentazione di Transformers sulla tokenizzazione presenta queste suddivisioni.
In un dato istante, il modello riceve il testo già disponibile e calcola un punteggio per ogni token del vocabolario. Questo punteggio si chiama logit. Nel nostro percorso, scegliere il punteggio più alto equivale a scegliere il token successivo; l'operazione argmax ne restituisce l'indice.
Un logit non è una percentuale di confidenza sulla categoria corretta del ticket. Interviene nella scelta del prossimo frammento di testo, non in una validazione di business.
Il trie descrive le continuazioni autorizzate
Un trie è un albero di prefissi. Un prefisso è semplicemente l'inizio di una sequenza. Più risposte che iniziano allo stesso modo condividono un tratto di percorso, poi si separano dove i loro token differiscono.
Immaginate un completamento automatico che autorizzi soltanto le continuazioni di un catalogo chiuso. Dopo ogni scelta, avanziamo nel catalogo dei percorsi rimasti. Il trie non legge il ticket e non sa quale categoria sia giusta: sa soltanto quali token possono ancora portare a una risposta autorizzata.
Se A(s) indica i token autorizzati dopo il prefisso s, conserviamo i loro logits e sostituiamo tutti gli altri con meno infinito, indicato con -inf. Così argmax sceglie tra le continuazioni ammissibili, finché almeno una ha un punteggio finito. Seguiremo un esempio numerico nel codice.
Anche terminare la generazione è una decisione
EOS, per end of sequence, è un token speciale che indica la fine. Non è la parentesi graffa } del JSON. Il programma deve distinguere fra «l'oggetto è completo» e «la generazione è terminata secondo la regola prevista».
Autorizzare EOS fin dall'inizio lascerebbe il modello fermarsi senza scrivere nulla. Qui EOS viene proposto solo in un nodo terminale del trie, cioè dopo una sequenza completa. Un limite di lunghezza può comunque interrompere l'esecuzione prima di questa fine: misureremo anche questo caso.
Tre domande da porre alla risposta
È leggibile? Il parser può convertire il testo in un valore JSON? È conforme? Ritroviamo le tre chiavi e i loro valori autorizzati? È esatta? I valori corrispondono all'annotazione del ticket?
Nel nostro esempio, sostituire P02 con P03 non rompe né la sintassi né il contratto: P03 è un prodotto autorizzato. La risposta diventa però errata. È proprio questa differenza che l'esperimento renderà visibile.
Prerequisiti Docker e GPU
Dovete saper leggere funzioni Python, liste e dizionari, usare JSON, un terminale e le basi di Docker. Le nozioni di decodifica sono spiegate nel percorso; non è necessaria esperienza precedente di addestramento.
L'ambiente validato usa Linux x86_64, Docker con Compose, NVIDIA Container Toolkit e una RTX 3090 da 24 Gio. Prevedete 16 Gio di RAM e 16 Gio di disco, esclusi gli strati Docker condivisi. La memoria video, o VRAM, appartiene alla scheda grafica; non sostituisce la RAM del computer. Nessuna esecuzione CPU è presentata come equivalente a questo percorso GPU.
Il modello è Qwen2.5-0.5B-Instruct, alla revisione pubblica fissa 7ae557604adf67be50417f59c2c2f167def9a775. «Instruct» indica il suo adattamento al rispetto delle istruzioni; non garantisce che le segua senza errori. Transformers lo carica localmente, senza codice remoto. La scheda del modello a questa revisione ne completa la descrizione.
Il modello contiene già dei pesi, i parametri numerici acquisiti durante l'addestramento. Qui li utilizziamo per calcolare gli output: è l'inferenza. Costruire il trie o modificare i token autorizzati non addestra questi pesi.
Estraete l'archivio e aprite il terminale nella sua radice. Tutti i comandi dell'articolo partono da questa stessa cartella. setup.sh prepara le directory e scrive soltanto UID/GID in .env: questi identificatori riguardano i diritti dell'utente e del gruppo sui file.
acquire scarica i file pubblici, li verifica e li colloca sotto il nome finale soltanto dopo la validazione, tramite rinomina atomica. models/ conserva questa versione locale, chiamata snapshot; outputs/ riceve le misure e artifacts/ i checkpoint del progetto. Non confondete questi file di controllo con un nuovo addestramento.
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
I cinque comandi hanno responsabilità diverse. config --quiet verifica la configurazione Compose. build costruisce le immagini necessarie. acquire.py prepara i file del modello. Infine, check_environment.py deve riuscire prima dell'inferenza.
CUDA permette qui di eseguire i calcoli sulla GPU NVIDIA. Il fatto che la scheda sia visibile su Linux non basta a stabilire che sia utilizzabile da Docker. Se CUDA non si inizializza nel contenitore, iniziate dalla documentazione NVIDIA Container Toolkit, anziché modificare il decodificatore.
Gli strati Docker già presenti possono accorciare la costruzione delle immagini. Questo tempo di preparazione non è una misura della decodifica del modello.
Verificare il programma prima del motore
Prima di chiedere al modello di classificare i ticket, verifichiamo le regole che lo circonderanno. La suite pubblica copre lo schema, il trie e gli scenari di errore. Avviatela dopo il controllo GPU:
docker compose run --rm gpu python -m pytest -q
Un esito positivo significa che i comportamenti testati del programma corrispondono a quanto previsto. Non significa ancora che il modello comprenderà i ticket. È la stessa distinzione tra testare il validatore di un modulo e verificare la correttezza delle informazioni inserite.
Non saltate questo passaggio per ottenere prima un JSON: un output plausibile non permetterebbe di individuare un ramo vietato accettato per errore.
Dati e contratto di output
Costruire le risposte possibili senza conoscere quella giusta
Per vincolare il modello, abbiamo bisogno di tutte le risposte autorizzate, non della risposta attesa per un dato ticket. La funzione seguente non riceve dunque alcun ticket né annotazione:
def enumerate_canonical_outputs():
    return [
        json.dumps(dict(zip(SCHEMA, values)), separators=(",", ":"))
        for values in itertools.product(*SCHEMA.values())
    ]
In questo estratto, SCHEMA è la corrispondenza tra i nomi dei campi e le loro liste di valori. Il nome non significa che si tratti di un documento nel formato standard JSON Schema: qui il codice percorre un contratto enumerato.
SCHEMA.values() fornisce le liste di scelte. L'asterisco in itertools.product(*SCHEMA.values()) le passa come argomenti separati. Il prodotto cartesiano crea tutte le combinazioni, come tre cicli annidati: una categoria, poi una priorità, poi un prodotto. La documentazione di itertools.product dettaglia questa operazione.
Per una combinazione come ("technical", "high", "P02"), zip(SCHEMA, values) associa ogni nome al suo valore. dict(...) costruisce l'oggetto; json.dumps(...) lo converte in testo. Infine, separators=(",", ":") impone la scrittura compatta, senza spazi fra gli elementi.
Otteniamo le 48 stringhe promesse. Non abbiamo scelto quella adatta al ticket. Costruire invece un trie che contenga soltanto la sua annotazione equivarrebbe a fornire la risposta al decodificatore. Sarebbe una fuga del target: la misura non valuterebbe più ciò che il modello sa ritrovare.
Perché fissare la rappresentazione?
Queste due scritture esprimono lo stesso oggetto:
{"category":"technical","priority":"high","product":"P02"}
{
  "product": "P02",
  "priority": "high",
  "category": "technical"
}
Eppure non sono la stessa stringa di testo. Il nostro trie non prova ad autorizzare tutte le formattazioni equivalenti: conserva una scrittura canonica per combinazione. Questa scelta semplifica i percorsi di generazione. Non cambia le informazioni rappresentate dall'oggetto.
Il corpus comprende anche formulazioni ambigue, parentesi graffe letterali e testo non affidabile che tenta di modificare l'istruzione. Il prompt chiede di considerare il ticket come un dato, mai come un comando. Questa istruzione non costituisce da sola una protezione completa: un testo malevolo può ancora tentare di orientare la scelta verso un valore autorizzato ma errato.
Prepariamo ora i ticket, gli oggetti canonici e il blocco del prompt:
docker compose run --rm gpu python -m json_decode.cli prepare --config configs/minimum.yaml
A questo punto fissiamo gli elementi dell'esperimento. Non correggiamo una previsione e non insegniamo al modello le annotazioni.
Il meccanismo centrale: riferimento, trie e generazione
Confrontare due vie sugli stessi ticket
Cominciamo dalla riferimento libera, o baseline. È il comportamento di confronto: lo stesso modello riceve lo stesso prompt, ma senza restrizione del vocabolario da parte del trie.
docker compose run --rm gpu python -m json_decode.cli baseline --config configs/minimum.yaml
docker compose run --rm gpu python -m json_decode.cli inspect-trie --config configs/minimum.yaml
docker compose run --rm gpu python -m json_decode.cli generate --config configs/minimum.yaml
baseline esegue dapprima i 48 ticket di sviluppo e congela il prompt prima del test. Gli errori restano registrati: non ritocchiamo le istruzioni dopo aver letto i risultati di test per abbellire il confronto.
inspect-trie rende visibile il controllo della tokenizzazione. generate esegue le due modalità e conserva le risposte grezze nonché le ragioni di arresto. I 192 ticket di test sono gli stessi nelle due vie.
Passare dalle stringhe a un albero di token
Prima di generare, il progetto verifica l'andata e ritorno fra testo e token per conservare le stringhe canoniche mirate. Questo controllo appartiene alla preparazione e all'ispezione: la classe seguente non contiene un tokenizer. Riceve sequenze di identificatori già costruite.
class TokenTrie:
    def __init__(self, sequences):
        self.children = [{}]
        self.terminal = set()
        for sequence in sequences:
            node = 0
            for token in sequence:
                if token not in self.children[node]:
                    self.children[node][token] = len(self.children)
                    self.children.append({})
                node = self.children[node][token]
            self.terminal.add(node)

    def allowed(self, node, eos_ids):
        return sorted(
            set(self.children[node])
            | (set(eos_ids) if node in self.terminal else set())
        )

    def advance(self, node, token):
        if token not in self.children[node]:
            raise ValueError("Token forbidden by trie")
        return self.children[node][token]
self.children è una lista di dizionari. Ogni posizione rappresenta un nodo dell'albero. Il primo dizionario, all'indice 0, è la radice. In un dizionario, la chiave è un identificatore di token e il valore è l'indice del nodo seguente.
Per ogni risposta, il ciclo riparte dalla radice. Se un ramo esiste già, lo segue; altrimenti crea un nodo. Gli inizi comuni non sono quindi duplicati. Alla fine di ogni sequenza, l'indice corrente viene aggiunto a self.terminal.
Il metodo allowed() fornisce i token possibili da un nodo. Aggiunge gli identificatori EOS solo se il nodo è terminale. L'ordinamento numerico stabilizza la lista restituita: non classifica i token in base alle preferenze del modello.
Infine, advance() segue un token ordinario nell'albero e rifiuta un ramo assente. EOS richiede un trattamento distinto nel ciclo di generazione: è un segnale di arresto, non automaticamente un ramo da percorrere con advance().
Seguire a mano un piccolo albero
Prendiamo due sequenze fittizie, [10, 20, 30] e [10, 40, 30], con 99 come identificatore EOS. Questi numeri servono soltanto a leggere il meccanismo: non sono né identificatori Qwen rilevati né una tokenizzazione reale dei nostri JSON.
| Prefisso già scelto | Prossimi token autorizzati | Perché? |
|---|---|---|
| Nessuno | 10 |
Entrambe le sequenze iniziano così. |
10 |
20 o 40 |
I due percorsi qui si separano. |
10, 20 |
30 |
Resta compatibile un solo percorso. |
10, 20, 30 |
99, dunque EOS |
La sequenza è completa. |
Dopo 10, 20, scegliere 40 non permetterebbe più di completare una delle due sequenze registrate: il programma lo rifiuta. Autorizzare 99 in quel punto lascerebbe invece fermarsi a metà percorso.
Il trie reale applica esattamente questo principio a sequenze più lunghe provenienti dai 48 JSON. Non ne deduce la struttura carattere per carattere da questa illustrazione; usa la tokenizzazione verificata del modello.
Conservare i punteggi utili, bloccare gli altri
Il trie conosce i token ammissibili. Il modello invece fornisce i suoi logits. La funzione seguente avvicina i due elementi:
def select_token(logits, allowed):
    if not allowed:
        raise ValueError("Impossible grammar: no allowed token")
    index = torch.tensor(sorted(allowed), device=logits.device, dtype=torch.long)
    scores = logits[index]
    if (
        torch.isnan(scores).any()
        or torch.isposinf(scores).any()
        or not torch.isfinite(scores).any()
    ):
        raise ValueError("No usable finite allowed logits")
    masked = torch.full_like(logits, -torch.inf)
    masked[index] = scores
    return int(masked.argmax()), masked
index colloca la lista degli identificatori autorizzati sullo stesso dispositivo dei logits. scores = logits[index] preleva i loro punteggi. torch.full_like crea un array della stessa forma riempito di -inf, poi masked[index] = scores ripristina soltanto i valori ammissibili.
Ecco un esempio numerico inventato, su un vocabolario ridotto a quattro token:
| Identificatore del token | Logit proposto | Autorizzato? | Logit dopo la maschera |
|---|---|---|---|
0 |
9 |
No | -inf |
1 |
2 |
Sì | 2 |
2 |
5 |
No | -inf |
3 |
-1 |
Sì | -1 |
Senza vincolo, il modello sceglierebbe il token 0. Con il vincolo, argmax restituisce 1, l'identificatore del miglior token ancora autorizzato. Non restituisce il suo punteggio 2. La documentazione PyTorch di argmax descrive questo comportamento.
Perché non sostituire i punteggi vietati con zero? Perché i punteggi autorizzati possono essere negativi. Uno zero vietato potrebbe allora vincere. -inf serve a escludere una possibilità, non ad attribuirle un voto semplicemente basso.
Cosa proteggono i controlli numerici?
Una lista allowed vuota indica una grammatica impossibile da proseguire. La funzione si ferma esplicitamente invece di selezionare un token arbitrario.
Esamina poi i punteggi autorizzati. NaN indica un valore numerico indefinito; +inf, l'infinito positivo. La loro presenza provoca un errore. Anche l'assenza di qualsiasi punteggio finito provoca un errore.
La sfumatura è utile: un punteggio autorizzato pari a -inf resta accettato se almeno un altro punteggio autorizzato è finito. L'estratto non rifiuta quindi indistintamente tutti i valori non finiti. Il suo obiettivo è mantenere almeno una scelta utilizzabile senza lasciare che un'anomalia numerica diventi una decisione.
Le due modalità usano argmax. La modalità libera lo applica a tutto il vocabolario; quella vincolata, dopo la maschera. È una scelta locale, token dopo token, non un confronto globale delle 48 risposte complete. Il vincolo chiude dei percorsi; non indica quale descriva correttamente il ticket.
Misurare senza confondere forma e contenuto
Le API di generazione di Transformers espongono i parametri e i meccanismi di decodifica. La loro documentazione ufficiale colloca questo lavoro in un quadro più ampio. Per questo esperimento, atteniamoci tuttavia ai comandi e al codice dell'archivio: le spiegazioni non richiedono di sostituire il motore di generazione.
Leggere la funzione che assegna i punteggi
row contiene in particolare il testo generato e la ragione di arresto. label contiene l'oggetto atteso per questo ticket. Confrontiamo la risposta con questo riferimento soltanto al momento della valutazione:
def parse_result(row, label):
    try:
        value = json.loads(row["text"])
        valid_json = True
    except (ValueError, TypeError):
        value = None
        valid_json = False
    valid_schema = validate_schema(value)
    complete = row["finish_reason"] == "eos"
    return {
        "json_valid": valid_json,
        "schema_valid": valid_schema,
        "completed": complete,
        "length": row["finish_reason"] == "length",
        "exact_tuple": complete and valid_schema and value == label,
        "fields": {
            k: bool(complete and valid_schema and value[k] == label[k]) for k in SCHEMA
        },
    }
Il primo blocco prova a convertire row["text"] con json.loads. Se fallisce, json_valid vale False. Non togliamo una frase introduttiva, non eliminiamo un blocco Markdown e non completiamo una parentesi graffa per salvare il risultato.
Il controllo validate_schema(value) pone una seconda domanda: l'oggetto rispetta il contratto? La sua implementazione è nel progetto; questo estratto ne mostra l'uso, non l'insieme dei test interni.
La variabile complete dipende soltanto da finish_reason == "eos". Una ragione length significa che è stato raggiunto il limite di generazione. Impedisce il successo completo, anche se il testo è già decodificabile.
Infine, exact_tuple richiede le tre condizioni: una fine EOS, un oggetto conforme e l'uguaglianza con l'annotazione. La «terna» indica i tre valori di business; qui la risposta manipolata resta un dizionario Python.
L'uguaglianza value == label riguarda gli oggetti decodificati, non l'identità byte per byte del testo grezzo. I due JSON presentati sopra, il cui ordine delle chiavi e spazi differiscono, producono dunque lo stesso oggetto per questo confronto. La generazione canonica è più ristretta di questo criterio di uguaglianza.
Il dettaglio che cambia la lettura dei punteggi per campo
Osservate l'inizio dell'espressione in fields: complete and valid_schema. Un campo ottiene un punto solo se l'intera risposta è conforme e terminata da EOS.
Se la risposta contiene due valori corretti e un prodotto autorizzato ma errato, quei due campi possono ricevere il credito. Se invece il prodotto vale P99, fuori contratto, tutti e tre i campi ottengono zero: il validatore rifiuta l'intero oggetto.
Allo stesso modo, tre valori esatti in una generazione fermata da length non assegnano alcun punto per campo in questo protocollo. Sono punteggi condizionati dalla conformità e dalla fine della generazione, non un conteggio di tutti i frammenti corretti visibili nel testo.
Confrontare sei risposte sullo stesso esempio
Riprendiamo la nostra annotazione didattica technical / high / P02. La tabella seguente descrive casi costruiti per comprendere la funzione, non output catturati dal modello.
Su mobile, scorrete la tabella orizzontalmente.
| Caso | Testo o modifica | Fine | JSON leggibile | Schema valido | Campi accreditati | Terna esatta |
|---|---|---|---|---|---|---|
| A | L'oggetto atteso | eos |
Sì | Sì | 3 su 3 | Sì |
| B | Stesso oggetto, ma product vale P03 |
eos |
Sì | Sì | 2 su 3 | No |
| C | Stesso oggetto, ma product vale P99 |
eos |
Sì | No | 0 su 3 | No |
| D | L'oggetto atteso, senza altra modifica | length |
Sì | Sì | 0 su 3 | No |
| E | Il testo Voici le résultat : seguito dall'oggetto |
eos |
No | No | 0 su 3 | No |
| F | L'oggetto atteso, con chiavi riordinate e rientri | eos |
Sì | Sì | 3 su 3 | Sì |
I casi A e D mostrano perché conserviamo la ragione di arresto. I casi B e C mostrano la differenza fra valore autorizzato ma errato e valore vietato. Il caso F ricorda che un oggetto esatto non ha necessariamente una scrittura canonica in modalità libera.
Una precisazione sul parser usato
In questo estratto, json_valid significa «accettato da json.loads con le impostazioni predefinite». Python accetta in particolare alcune costanti non finite e conserva l'ultimo valore di una chiave ripetuta. La documentazione del modulo json dettaglia questi comportamenti. Questa sola chiamata non è dunque un controllo rigoroso di tutte le particolarità della RFC.
Le 48 stringhe canoniche non introducono né queste costanti né chiavi ripetute. Per un input più generale, occorrerebbe definire e testare una politica esplicita. Sarebbe un'evoluzione del progetto, non una ragione per modificare silenziosamente le risposte o i punteggi di riferimento.
Misure prima dei risultati
Conservare tutti i ticket nel calcolo
Per ogni modalità, evaluate usa i 192 ticket di test come denominatore. Calcola il tasso di JSON valido, il tasso di schema valido, la proporzione di fini EOS, l'esattezza della terna e l'esattezza di ciascun campo. Nessun ticket fallito viene rimosso.
Per esempio, il tasso «Prodotto corretto» è il numero di ticket per i quali fields["product"] vale True, diviso per 192. Non è né una media delle sole risposte conformi né una percentuale ottenuta chiedendo al modello di autovalutarsi.
Per verificare che la regola sia chiara, prendiamo un mini-lotto didattico di quattro risposte: i casi A, B, D ed E della tabella precedente. Tre testi sono decodificabili e conformi: A, B e D. Tre fini sono EOS: A, B ed E. Eppure solo A possiede una terna esatta.
Otteniamo quindi 3/4 = 75 % di JSON decodificabile, 75 % di conformità, 75 % di fini EOS, ma 1/4 = 25 % di terne esatte. Categoria e priorità ricevono credito per A e B, cioè 2/4 = 50 % ciascuna; il prodotto solo per A, cioè 25 %.
Questo piccolo lotto non è una misura di Qwen. Mostra perché ogni indicatore risponde a una domanda diversa. Rimuovere E, che non si decodifica, cambierebbe il denominatore e migliorerebbe artificialmente diversi tassi.
Avviare la valutazione e leggere le misure osservate
docker compose run --rm gpu python -m json_decode.cli evaluate --config configs/minimum.yaml
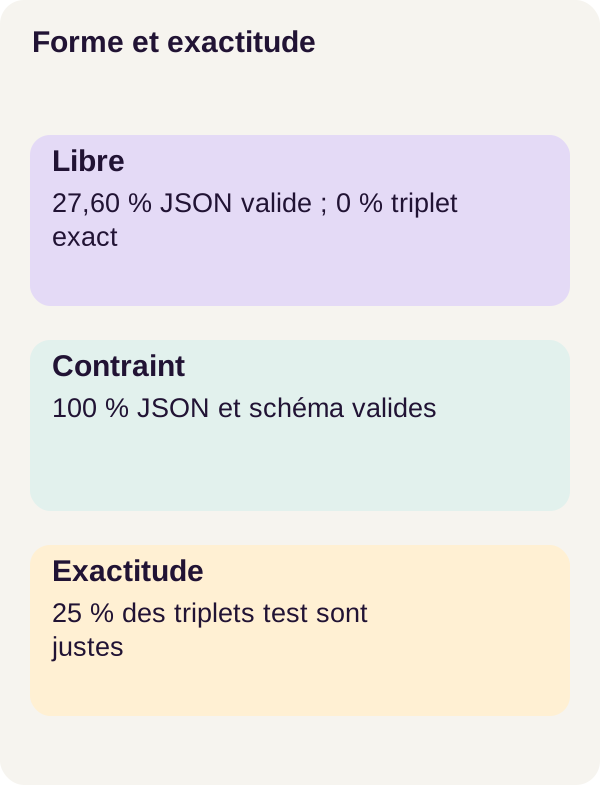
I valori che seguono sono misure locali osservate con questa revisione, questo modello e questo corpus sintetico. Non prevedono il tasso di riuscita sui ticket della vostra azienda.
Su mobile, scorrete la tabella orizzontalmente.
| Modalità, 192 ticket di test | JSON valido | Schema valido | Terna esatta | Categoria corretta | Priorità corretta | Prodotto corretto |
|---|---|---|---|---|---|---|
| Libera | 27,60 % | 2,08 % | 0 % | 0 % | 2,08 % | 2,08 % |
| Vincolata | 100 % | 100 % | 25 % | 47,40 % | 64,06 % | 75 % |
Ciò che il risultato stabilisce, e ciò che non stabilisce
La prima osservazione è netta: in questo esperimento, la via vincolata produce 100 % di JSON validi e 100 % di oggetti conformi. Tutte le sue generazioni terminano con EOS; nessuna raggiunge il limite massimo di lunghezza.
La seconda osservazione è altrettanto importante: solo 48 delle 192 terne sono esatte, cioè il 25 %. Le altre 144 risposte vincolate rispettano il formato ma sbagliano almeno un valore. Il vincolo ha risolto il problema della forma su questo lotto, non l'intero problema di classificazione.
Il prodotto è corretto nel 75 % dei casi, la priorità nel 64,06 % e la categoria nel 47,40 %. Questi tassi non si sommano per dare un tasso di ticket riusciti: i campi devono essere corretti insieme, sullo stesso ticket. Il punteggio della terna misura proprio questo requisito.
Gli zeri della modalità libera richiedono più prudenza. Il punteggio per campo richiede già un oggetto conforme e una fine EOS. Uno zero di categoria non significa quindi che il termine atteso non appaia mai nelle risposte grezze. Significa che nessuna risposta soddisfa tutte le condizioni per accreditare quel campo. Leggere gli output grezzi resta necessario per distinguere un problema di presentazione da un errore di contenuto.
Perché il trie può qui garantire una forma senza garantire una risposta corretta? Perché i suoi percorsi sono costruiti soltanto dalle 48 stringhe autorizzate. Questa proprietà presuppone che la generazione segua il trie fino a una fine autorizzata. Un'interruzione o un guasto numerico deve restare un fallimento, non una risposta riuscita per principio.
Infine, la tabella non consente di attribuire gli errori a una causa unica, né di concludere sulla velocità di una modalità rispetto all'altra. Riporta le osservazioni di questo protocollo, senza isolare l'effetto della dimensione del modello, del prompt o di ciascuna famiglia di ticket.
Verificare i rami rifiutati
Una dimostrazione in cui tutto sembra andare bene non basta. Bisogna anche verificare le operazioni che devono fallire: è il ruolo dei casi negativi.
Il progetto controlla un linguaggio impossibile da proseguire, prefissi vietati e la regola di autorizzazione di EOS. Avviate questi controlli dopo la valutazione:
docker compose run --rm gpu python -m json_decode.cli negative-cases --config configs/minimum.yaml
Per uno sviluppatore web, è l'equivalente di un test che invia volontariamente un valore vietato a un modulo. Il test riesce quando avviene effettivamente il rifiuto atteso, non quando l'input errato viene accettato.
Se un ramo assente diventa percorribile o EOS diventa possibile troppo presto, il meccanismo è rotto, anche se alcuni ticket producono ancora bei JSON. Un errore atteso che non viene più rilevato è una regressione.
Cosa abbiamo imparato
Abbiamo trasformato un contratto di tre campi in un insieme di risposte, poi in percorsi di token. Il modello propone i punteggi; il trie indica le scelte consentite; il selettore sceglie fra queste. Nessuno di questi passaggi consulta l'annotazione del ticket per fornire la risposta corretta.
All'arrivo, le responsabilità restano separate. Il parser controlla la lettura del testo. Lo schema controlla chiavi e valori ammessi. L'annotazione permette di misurare l'esattezza. La ragione di arresto indica se la generazione è terminata come previsto.
Il risultato 100 % di conformità e 25 % di terne esatte riassume questa distinzione: chiudere le possibilità di risposta non aggiunge al modello una conoscenza del ticket. Disponiamo di un meccanismo verificabile di controllo della forma, non di una prova della correttezza di business.
Esercizio: formulare un'ipotesi prima del comando
Immaginiamo ora una modifica: EOS sarebbe autorizzato in tutti i nodi del trie, compresa la radice.
Prima di avviare il comando, scrivete la vostra previsione. Se i logits favoriscono EOS, il modello potrebbe fermarsi subito? Potrebbe terminare dopo un prefisso JSON incompleto? Il testo vuoto sarebbe accettato dal parser?
Il modulo src/json_decode/exercise.py confronta già le due regole con logits controllati che favoriscono EOS. Non dovete modificare il decodificatore di riferimento. Testiamo volutamente una regola di arresto, senza avviare una nuova campagna destinata a migliorare i punteggi.
docker compose run --rm gpu python -m json_decode.cli exercise --config configs/exercise.yaml
Confrontate unsafe_immediate_eos, safe_first_token e empty_json_valid con le vostre previsioni. Il primo permette di osservare la fine immediata con la regola pericolosa; il secondo mostra la scelta iniziale con la regola protetta; il terzo verifica la lettura di un testo vuoto.
L'identificatore di safe_first_token appartiene alla tokenizzazione del progetto: non sostituitelo con il 10 del nostro albero fittizio. Ciò che conta è che costituisca un inizio autorizzato, anziché un arresto prematuro.
Per spiegare il risultato, distinguete fra autorizzare una continuazione e accettare un oggetto terminato. Un testo vuoto non è un documento JSON. Il testo "", che contiene due virgolette, rappresenta invece una stringa JSON vuota, ma non l'oggetto a tre campi richiesto qui. Sintassi e contratto restano due controlli diversi.
Adattare il meccanismo e preparare la produzione
Quando questo trie finito resta pertinente
Questo meccanismo è facile da ispezionare perché il contratto è piccolo e chiuso. Per modificarlo, fate evolvere insieme la lista dei valori, la serializzazione, i test e il validatore indipendente. Conservate una separazione sviluppo/test prima di modificare il prompt.
Il numero di combinazioni può tuttavia crescere rapidamente. A titolo illustrativo, quattro categorie, tre priorità e 10 000 valori possibili di prodotto darebbero 4 × 3 × 10 000 = 120 000 risposte da enumerare. I prefissi comuni possono essere condivisi, ma ogni combinazione deve comunque essere presa in considerazione da questa costruzione.
Un campo di commento libero non si descrive più con i 48 output del tutorial. Servono allora una grammatica adatta, limiti di complessità e lunghezza, nonché test di tokenizzazione. Questo prolungamento cambia il problema; non consiste nel rimuovere una guardia finché il programma accetta il nuovo campo.
Un valore autorizzato non è un'autorizzazione ad agire
unknown è previsto per categoria e prodotto, non per priorità. La sua presenza offre un valore possibile; non garantisce che il modello lo scelga quando esita. Non è nemmeno una misura calibrata della sua incertezza.
Per ticket reali servono dati autorizzati e versionati, annotazioni rilette e regole esplicite per trattare le ambiguità. Restano necessarie una politica di rifiuto e, quando l'azione è sensibile, supervisione o validazione umana.
L'applicazione deve inoltre gestire autenticazione, controllo degli accessi, osservabilità — log, errori e misure utili —, prove di carico, backup e audit delle dipendenze. Nessuna di queste proprietà deriva dalla tabella dei punteggi. Un output strutturato resta un input non affidabile finché il business non lo ha validato.
Risoluzione dei problemi e pulizia
Il controllo dell'ambiente fallisce. Fermatevi a check_environment.py. Verificate il driver, NVIDIA Container Toolkit e la scheda esposta a Docker. Un problema di accesso alla GPU non si risolve modificando le classi autorizzate.
L'ispezione del trie fallisce. Non passate a generate. Controllate prima la serializzazione canonica e l'andata e ritorno tokenizzazione/decodifica. L'albero deve descrivere le stringhe previste, non un'approssimazione che somiglia loro.
I casi negativi non intercettano più i rifiuti. Esaminate i prefissi vietati e la regola EOS prima di rileggere i punteggi del modello. Una demo isolata che produce JSON non ripara questa regressione.
Per terminare il percorso, generate le figure, controllate i checkpoint, visualizzate la pulizia e fermate i servizi. Eseguite questi quattro comandi nell'ordine indicato, sempre dalla radice del progetto:
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
L'opzione --dry-run richiede un'anteprima: serve a esaminare la pulizia prevista, non ad avviare una cancellazione. Non rimuovetela senza avere ispezionato ciò che verrebbe eliminato. L'ultimo comando ferma le risorse Compose del progetto; non è necessaria alcuna pulizia globale degli altri progetti Docker.
Fonti primarie
Il formato e il codice Python. La RFC 8259 — formato JSON descrive il linguaggio generale. La documentazione Python del modulo json precisa serializzazione, decodifica e le loro particolarità; quella di itertools.product spiega l'enumerazione delle combinazioni.
Il modello e la decodifica. La scheda di Qwen2.5-0.5B-Instruct alla revisione usata, la presentazione della tokenizzazione in Transformers, l'API di generazione Transformers e la funzione torch.argmax approfondiscono i componenti studiati.
L'ambiente. La guida di installazione di NVIDIA Container Toolkit riguarda l'accesso alla GPU dai contenitori.
Questi riferimenti completano la spiegazione. Per riprodurre le misure, conservate il codice, la revisione del modello e i parametri fissati nell'archivio r1: le pagine di documentazione correnti non costituiscono una nuova configurazione validata del tutorial.