


Une page de suivi de commande met longtemps à répondre. Votre application ne signale pas d’erreur, mais l’utilisateur attend toujours. Le délai vient-il du serveur, d’une décision de cache ou d’un passage intermédiaire ? Cloudflare Traces, annoncé en bêta le 2 octobre 2026, permet d’examiner davantage d’étapes. Pour en tirer un diagnostic, vous devez encore relier les observations au bon trajet.
Commencer par une requête que vous pouvez reconnaître
Prenons une application fictive derrière Cloudflare. Un navigateur demande une page, la requête traverse la plateforme puis rejoint le serveur de l’application, appelé l’origine. Ce serveur peut consulter une base de données ou un service externe avant de répondre. Chaque couche ne voit qu’une partie du travail.
Un journal applicatif peut indiquer qu’une page a été servie sans expliquer une attente survenue avant son arrivée. À l’inverse, un indicateur réseau ne montre pas forcément quelle opération de l’application a pris du temps. Une trace rassemble des étapes liées à une même requête. Chaque étape observée, souvent appelée un span, précise une opération et sa place dans le trajet.
Pour raisonner, commencez avec une demande synthétique dont vous maîtrisez le contenu. Notez la route utilisée, l’heure d’émission et les éléments qui permettent de la retrouver. Séparez les observations des hypothèses : « l’origine a reçu la requête » est une observation ; « la base ralentit la page » reste une hypothèse tant que rien ne montre ce travail.
Votre fiche de diagnostic doit pouvoir contenir des cases vides. Une couche absente peut correspondre à une partie non instrumentée ou non conservée. Elle ne prouve pas qu’aucune opération n’y a eu lieu. Ce principe est utile même avec un outil de supervision déjà installé : le nom d’une vue ne garantit jamais l’étendue de la preuve.
Les annonces du 2 octobre, avec leurs statuts
Cloudflare Traces a été annoncé en bêta ouverte le 2 octobre. L’éditeur décrit un parcours couvrant les opérations prises en charge de sécurité, de transformation, de cache, de routage, de Workers et de traitement de l’origine. Il annonce la propagation du contexte W3C traceparent, l’échantillonnage et un export compatible OTLP, le protocole de transmission d’OpenTelemetry. La couverture ne doit pas être étendue à tous les produits par déduction. Annonce Cloudflare Traces.
Le même jour, Cloudflare a présenté huit évolutions d’Observability, notamment un espace commun pour les journaux, une API SQL unifiée et des alertes en bêta. Les requêtes croisées entre plusieurs jeux de données sont encore annoncées pour plus tard. Le nouveau modèle tarifaire est prévu à partir du 1er décembre 2026, avec application au renouvellement pour Enterprise. Annonce Observability.
| Élément annoncé | Ce qu’il faut retenir au 6 octobre |
|---|---|
| Cloudflare Traces | Bêta ouverte ; vérifier les opérations réellement visibles |
| SQL et nouvelles alertes | Bêtas à qualifier selon votre compte et votre usage |
| Croisement entre jeux de données | Capacité future, à ne pas supposer disponible |
| Tarification unifiée | Échéance annoncée en décembre, avec modalités Enterprise |
Ce tableau résume les statuts annoncés, pas un inventaire testé sur un compte Partitech. Il sert à choisir ce que votre pilote devra confirmer. Évitez de construire une procédure d’incident autour d’une fonctionnalité encore future.
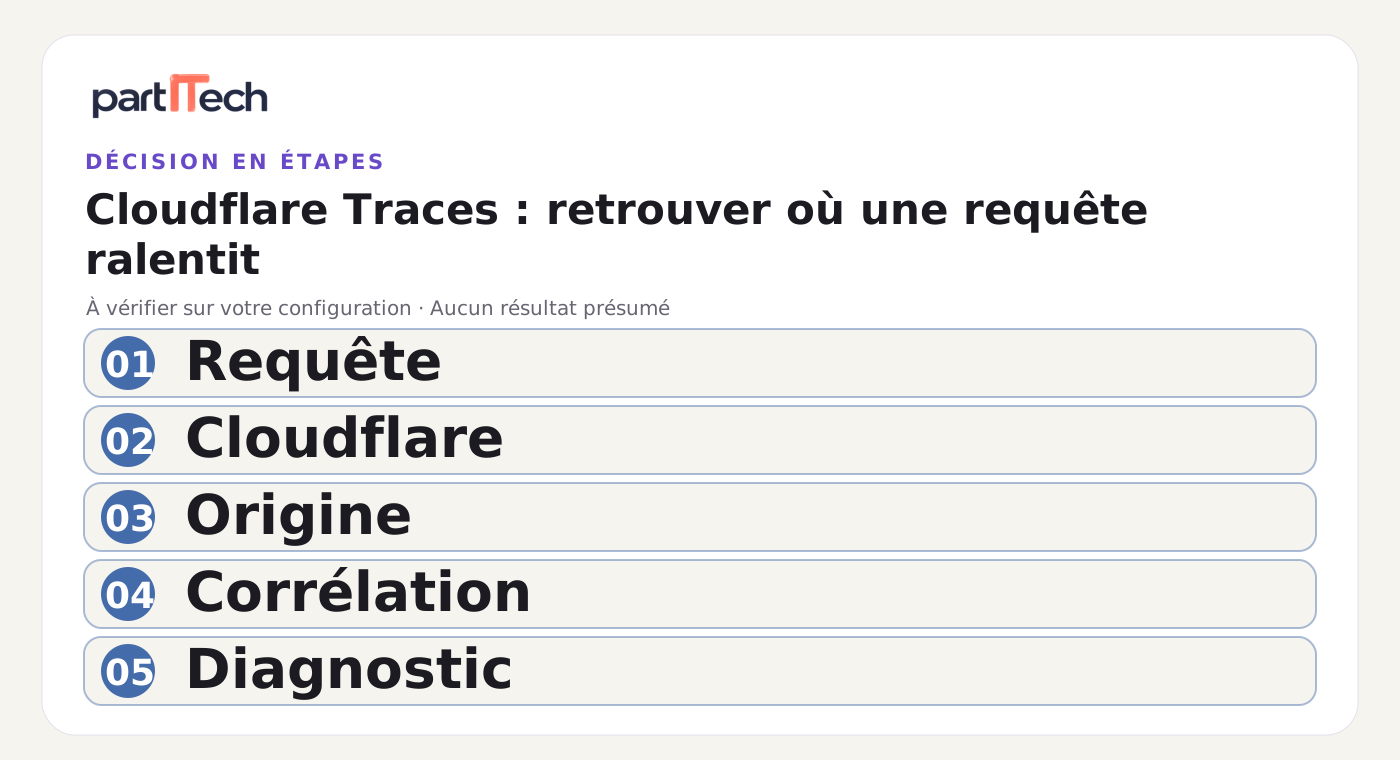
Relier les couches sans inventer ce qu’elles ne montrent pas
Le contexte de trace est une information transmise entre services pour reconnaître un trajet commun. OpenTelemetry fournit un ensemble de conventions et d’outils pour instrumenter une application, c’est-à-dire lui faire décrire ses opérations. Un format commun facilite le rapprochement ; il ne crée pas automatiquement les observations qui manquent à l’intérieur de votre code.
Pour une application Symfony ou Laravel, cherchez d’abord ce qui est déjà instrumenté : entrée de requête, accès à la base, appel externe, file asynchrone. Faites une carte simple des frontières : navigateur vers plateforme, plateforme vers application, application vers dépendances. Pour chaque passage, identifiez qui accepte, transmet ou renouvelle le contexte. N’ajoutez pas un second collecteur avant d’avoir compris le chemin existant.
Un identifiant fourni par un appelant n’est pas une identité authentifiée. Dans notre protocole, il ne sert jamais à autoriser une action ni à sélectionner le dossier d’un client. Définissez les frontières où un contexte externe peut être repris, les formats admis et les conditions où vous repartez avec un contexte interne. Cette recommandation d’architecture doit être adaptée à votre instrumentation réelle.
Examinez aussi les branches asynchrones. Si la page déclenche un travail après avoir répondu, sa durée ne doit pas être confondue avec celle de l’attente dans le navigateur. Le lien entre les deux opérations peut rester utile, mais il faut expliquer ce que vous mesurez. Sans cette distinction, une longue tâche secondaire risque de devenir une fausse explication de la lenteur de la page.
Choisir les données avant de choisir le volume
Une trace riche peut contenir des informations dont le diagnostic n’a pas besoin. Pour notre page fictive, conserver une route normalisée comme « suivi de commande » est souvent plus utile que conserver une URL complète avec identifiant personnel et paramètres. Le nom de l’opération peut suffire sans son contenu métier.
Écrivez une liste de champs autorisés et une liste d’exclusions : secrets, cookies, en-têtes d’authentification, contenu de formulaires et corps de réponses. Vérifiez ce qui est collecté automatiquement, ce qui est ajouté par votre code et ce qui part vers la destination d’export. Le nettoyage à l’écran ne garantit pas que l’export soit également nettoyé.
L’échantillonnage consiste à retenir une partie des requêtes. Vous recherchez un compromis entre observations utiles, volumes et coût. En régime normal, fixez une règle compréhensible. Pendant une investigation, vous pouvez proposer une collecte plus ciblée sur une route synthétique ou un trafic de test. Cloudflare annonce précisément des règles permettant de modifier la sélection des requêtes tracées. Échantillonnage et Trace Rules.
Une règle temporaire doit avoir un propriétaire, une date de retrait et une justification. Sinon l’incident finit, mais la collecte élargie continue. Définissez également qui peut lire les traces, combien de temps elles restent accessibles et qui peut activer un export. Ce sont des choix d’exploitation ; aucun niveau de conformité n’est déduit ici de l’adoption d’un format technique.
Trois parcours synthétiques à comparer
Notre proposition de qualification commence par trois requêtes sur une application de démonstration. La première utilise une réponse que vous avez conçue pour venir du cache. La deuxième rejoint l’origine. La troisième déclenche une opération interne volontairement distincte, par exemple un appel vers un service factice. Aucun compte client, aucune commande réelle et aucune latence mesurée ne sont fournis dans cet article.
Pour chaque parcours, vérifiez que le comportement attendu a réellement eu lieu : ne nommez pas une requête « cache » uniquement parce que vous l’avez souhaité. Retrouvez ensuite sa trace, les étapes visibles et les observations applicatives associées. Un parcours non retrouvé doit être expliqué par les réglages, la couverture ou une investigation supplémentaire ; ne le comptez pas automatiquement comme une réussite.
| Champ de la fiche | Observation à renseigner pendant l’essai |
|---|---|
| Requête synthétique | Route, heure et variante de test |
| Corrélation | Identifiant ou preuve reliant les couches |
| Étapes visibles | Opérations retrouvées dans chaque outil |
| Étapes absentes | Instrumentation ou sélection à vérifier |
| Hypothèse | Explication envisagée de l’attente |
| Preuve | Observation qui confirme ou réfute l’hypothèse |
Répétez les parcours avec la règle normale puis avec la règle ciblée. Relevez les volumes générés et la proportion de parcours retrouvés dans les conditions du test. Inspectez quelques exports pour confirmer l’absence des champs exclus. Ces mesures permettront de décider ; le simple affichage d’une trace ne suffira pas à qualifier le diagnostic.
Passer du schéma à une procédure d’exploitation
La prochaine étape est une fiche utilisable pendant un incident : où chercher la requête, quelles couches comparer et qui peut élargir temporairement la collecte. Faites-la relire par une personne qui n’a pas préparé le pilote. Si elle ne peut pas retrouver une requête de test avec ces instructions, améliorez la procédure avant d’étendre le périmètre.
Préparez également la réversibilité. Sachez retirer une règle, désactiver un export et conserver les seules preuves nécessaires à l’analyse. Estimez la conservation et les volumes à partir de l’usage observé, puis réexaminez cette estimation à l’approche de l’échéance tarifaire annoncée. Les conditions de l’offre peuvent évoluer pendant la bêta.
Le choix favorable à Cloudflare Traces repose sur une corrélation démontrée entre les couches utiles à votre application, une collecte maîtrisée et une procédure compréhensible. Si les opérations décisives restent absentes, améliorez l’instrumentation avant d’espérer un meilleur diagnostic. L’outil apporte un nouveau périmètre d’observation ; votre équipe transforme ces observations en preuves exploitables.
Sources et date de vérification
Sources primaires ouvertes le 6 octobre 2026 : Cloudflare Observability et Cloudflare Traces, publiées le 2 octobre. Le parcours fictif, la fiche et les règles proposées constituent une méthode originale, sans essai exécuté ni gain de résolution mesuré.