

Vous envisagez d’utiliser un modèle pour relire une migration PHP. Un tarif d’entrée bas semble décisif, jusqu’à ce que la réponse demande deux corrections et une vérification longue. Pour comparer GPT-6 Sol, Luna, Sol 6.1 et Claude 5.5, comptez donc le prix d’une tâche acceptée, pas seulement celui des tokens annoncés.
Ce qui a changé du 22 au 29 septembre
Quatre annonces rapprochées ont élargi le choix : GPT-6 Sol et GPT-6 Luna sont apparus le 22 septembre, Claude Opus 5.5 le même jour, Claude Sonnet 5.5 le 28, puis GPT-6.1 Sol le 29. Les pages développeur d’OpenAI indiquent que Sol et Luna sont accessibles par les API Responses et Chat Completions; Anthropic décrit Opus comme un modèle pour les travaux complexes et Sonnet comme un complément plus rapide pour les tâches courantes. Ces descriptions viennent des éditeurs : elles ne disent pas lequel réussira mieux votre propre travail. (OpenAI, journal des changements API, Anthropic, Opus 5.5, Anthropic, Sonnet 5.5)
Les tarifs standards annoncés, en dollars américains par million de tokens, donnent un premier repère :
| Modèle | Entrée | Entrée relue depuis le cache | Écriture du cache | Sortie |
|---|---|---|---|---|
| GPT-6 Sol | 2 $ | 0,20 $ | non indiqué dans le journal de lancement | 10 $ |
| GPT-6.1 Sol | 2 $ | 0,10 $ | 2,50 $ | 10 $ |
| GPT-6 Luna | 0,10 $ | 0,01 $ | à vérifier selon le tarif courant | 0,50 $ |
| Claude Opus 5.5 | 4 $ | 0,20 $ | 5 $ | 20 $ |
| Claude Sonnet 5.5 | 2 $ | 0,20 $ | 2,50 $ | 10 $ |
Ces montants ne sont comparables qu’à conditions égales : tarifs standards, longueur de contexte et options de traitement identiques. Les grilles changent; certaines facturations distinguent aussi le cache écrit, le traitement par lots ou les requêtes longues. Vérifiez les lignes applicables avant de chiffrer. Les pages d’OpenAI indiquent les tarifs de ses modèles dans le journal des changements et sa grille de prix; Anthropic publie le détail du cache sur les pages Opus et Sonnet.
Un tarif par token ne donne pas le coût d’une tâche
Un token est une unité de texte traitée par le modèle; la facture sépare généralement ce qui entre et ce qui ressort. Un cache peut réduire le prix de la partie d’une consigne réutilisée, mais il ne rend pas gratuits les nouveaux éléments, la réponse, les outils ou les reprises. Les éditeurs annoncent aussi des coûts par tâche inférieurs dans leurs propres évaluations. Ces résultats dépendent de leurs tâches, réglages et critères; ils ne sont pas un classement commun ni une économie démontrée pour Partitech.
Pour une décision d’équipe, utilisez une mesure que vous pouvez refaire :
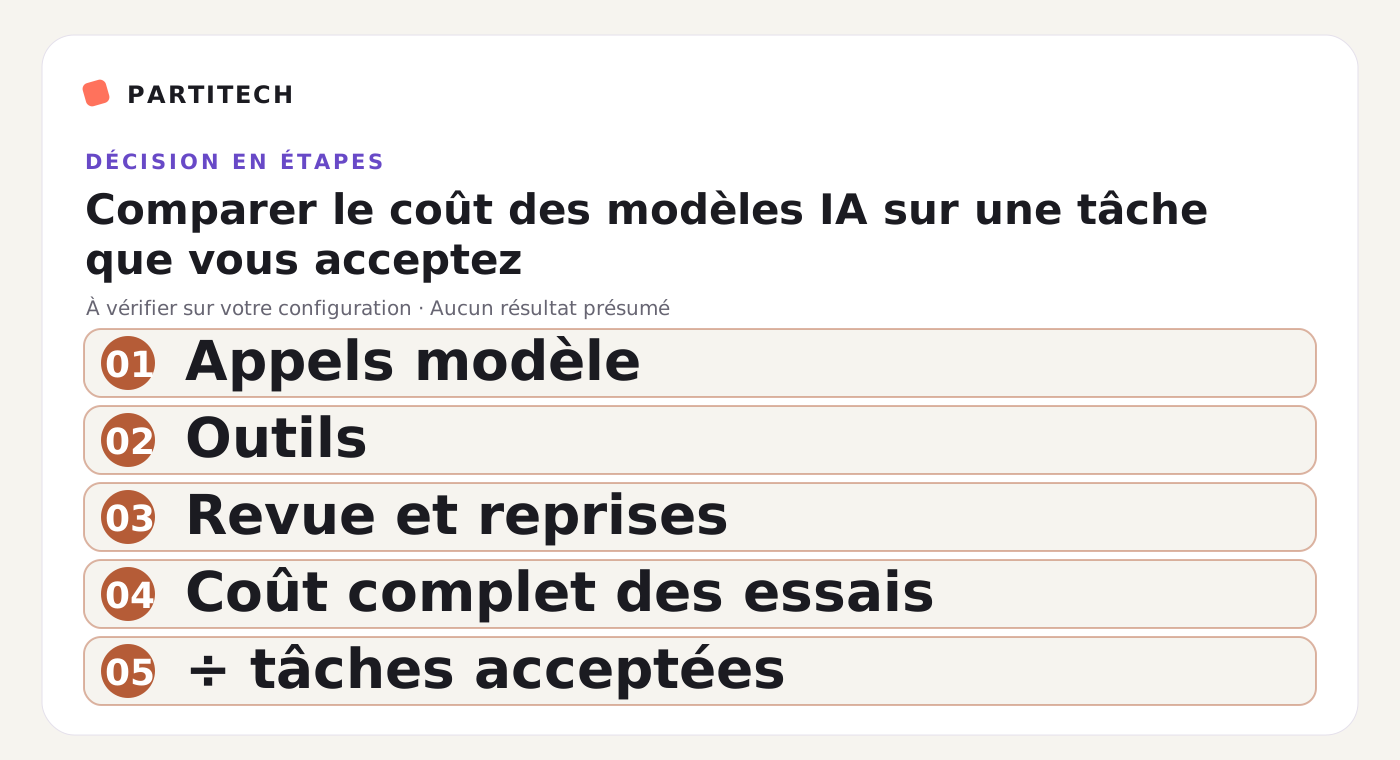
Coût par tâche acceptée = (appels modèle + outils + infrastructure + temps de revue et de correction) ÷ tâches acceptées
Définissez « acceptée » avant de lancer l’essai. Pour une migration, cela peut signifier : tous les tests passent, aucun changement hors périmètre n’est présent et une personne responsable valide le diff. Le temps de revue peut être converti en coût avec une hypothèse de taux horaire; notez-la à part afin de pouvoir refaire le calcul. Une réponse rejetée n’est pas une tâche achevée, même si son appel était peu cher.
Comparer des tâches que vous reconnaissez
Un test utile peut réunir quatre travaux contrôlables : corriger une erreur dans un petit service PHP, écrire une requête SQL à partir d’un schéma, proposer un refactoring sans changer le comportement et résumer un document technique avec ses références. Préparez plusieurs exemples du même type, sans données de clients. Pour chaque tâche, écrivez les conditions de réussite et les cas d’échec acceptables avant de révéler le nom du modèle aux personnes qui évaluent les réponses.
Gardez la même consigne, le même dépôt ou extrait, les mêmes outils et les mêmes limites d’exécution. Fixez les versions exactes, les paramètres de raisonnement, les permissions réseau, le plafond d’appels et le budget. Répétez chaque cas : un seul essai peut être influencé par une sortie atypique. Conservez les réponses rejetées, les erreurs d’outil et les relances au lieu de ne garder que les meilleurs résultats.
Un CSV minimal suffit pour démarrer :
task_id,modele,version,tokens_entree,tokens_cache_lus,tokens_cache_ecrits,tokens_sortie,cout_appels,cout_outils,minutes_revue,acceptee
php-01,,,,,,,,,,
sql-01,,,,,,,,,,
refactor-01,,,,,,,,,,
doc-01,,,,,,,,,,
Les colonnes sont vides volontairement : aucun benchmark Partitech n’a été exécuté pour cet article. Si vous illustrez la formule, présentez des valeurs fictives en toutes lettres comme telles, sans les associer à un fournisseur.
Observer le cache sans fausser la comparaison
Faites au moins deux passages distincts. Le passage « à froid » mesure une consigne non encore mise en cache; le passage « réutilisé » mesure ce qui se passe quand une partie identique peut être relue. Notez les règles d’expiration et le comportement lorsque la consigne change. L’écriture initiale et les lectures ultérieures n’ont pas le même tarif. Ne multipliez pas un tarif de cache par le nombre total de tokens, et ne comparez pas un passage chaud d’un modèle avec un passage froid d’un autre.
Ajoutez les appels d’outils, le temps d’attente et la vérification humaine. Pour un agent qui modifie du code, un coût de modèle inférieur peut être annulé par une correction manuelle; dans un résumé documentaire, une réponse plus courte peut au contraire demander davantage de contrôle si ses références sont faibles. Le protocole doit faire apparaître ces différences au lieu de les masquer dans une moyenne unique.
Choisir par famille de travail, puis réévaluer
Votre tableau final devrait rapprocher au minimum le taux d’acceptation, les erreurs graves, le temps de revue, le coût complet et la latence. Ajoutez une ligne par famille de tâches. Un modèle peut être le choix par défaut pour les requêtes répétitives et un autre rester réservé aux cas ambigus; définissez le seuil d’escalade à partir des essais. Gardez un échantillon de référence et relancez-le quand le fournisseur change le modèle ou sa facturation.
Commencez par vérifier les tarifs et la disponibilité qui concernent votre compte, puis construisez ce petit corpus et faites relire les résultats à l’aveugle. Vous saurez alors si le prix par token se traduit, dans vos conditions, par moins de dépenses pour un résultat réellement accepté. Les annonces de septembre fournissent des candidats et des hypothèses; seule une évaluation reproductible sur vos tâches peut guider le choix.
Pour le cadre plus large du choix d’hébergement et du coût complet, voir aussi notre guide sur l’IA générative via API, cloud privé ou installation locale.