

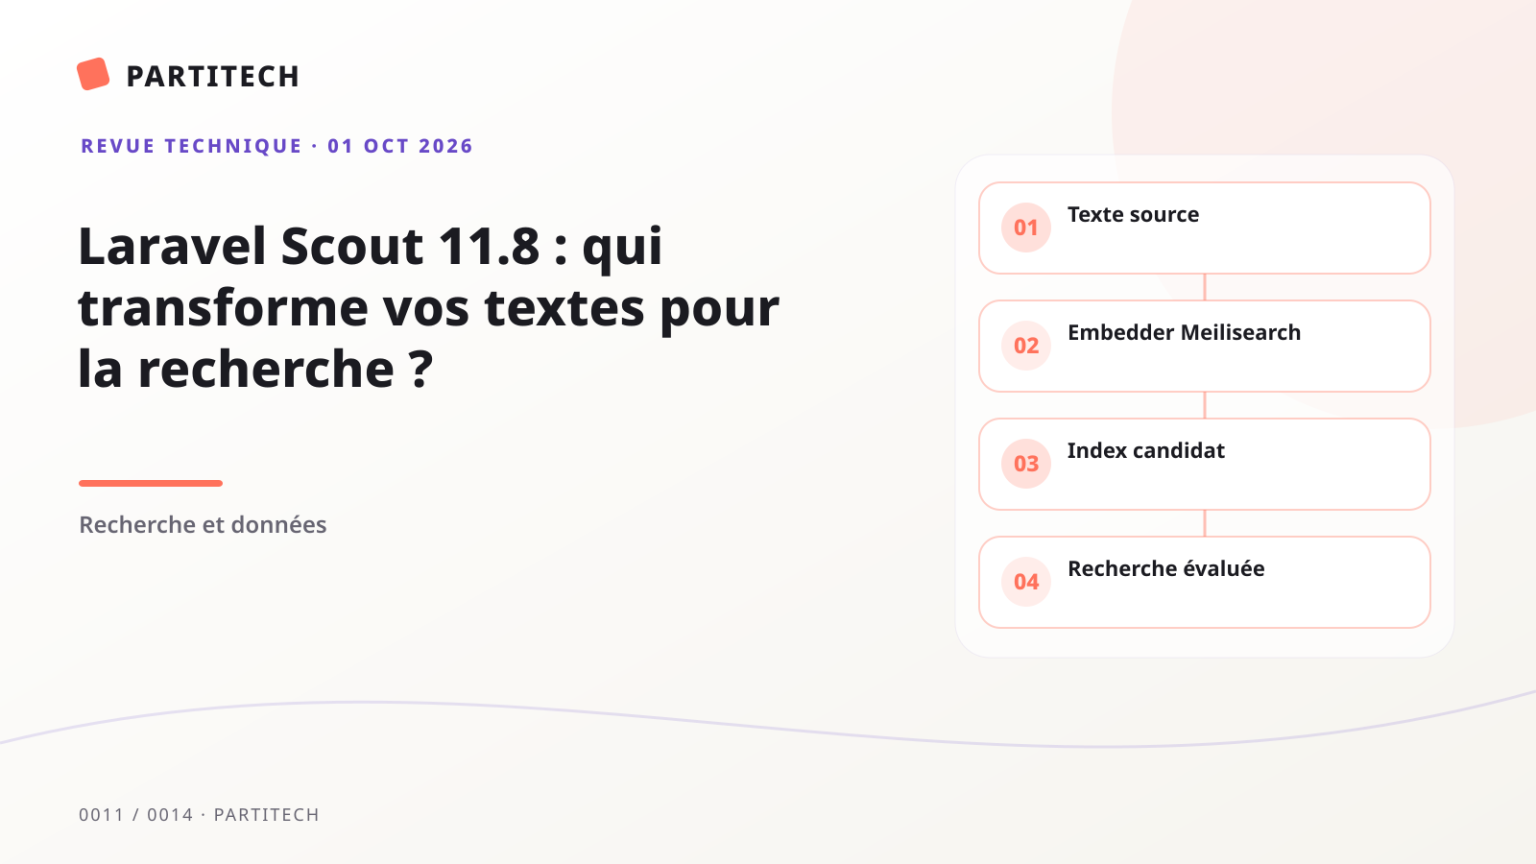
Vous gérez un catalogue où les visiteurs cherchent tantôt le nom exact d’un produit, tantôt une description comme « veste pour marcher sous la pluie ». La recherche par mots-clés peut manquer cette seconde demande lorsque les mots de la fiche et ceux de la question diffèrent. Un vecteur d’embedding représente un texte sous forme de nombres afin qu’un moteur compare des proximités de sens. Cette représentation doit toujours être évaluée sur des exemples utiles à votre activité.
Le 22 septembre 2026, Laravel Scout 11.8.0 a ajouté un pilote pour les embeddings natifs de Meilisearch (note de version). Le code correspondant a été fusionné quelques jours plus tôt. La nouveauté concerne l’endroit où les vecteurs des documents et des requêtes sont calculés : Scout peut demander à Meilisearch d’utiliser un embedder défini sur l’index. Elle ne garantit ni une meilleure pertinence, ni un calcul local, ni une économie. Elle déplace des responsabilités qu’il faut rendre explicites.
Ce qui change dans Scout 11.8
Scout est la couche de Laravel qui synchronise des modèles applicatifs avec des moteurs de recherche. La demande de fusion #1012, fusionnée le 17 septembre, et la release 11.8 décrivent une option embedding.driver avec deux chemins : laravel-ai et meilisearch. L’absence de cette option conserve le comportement Laravel AI par défaut. Avec le pilote Meilisearch, Scout ne produit pas directement le vecteur du document : le moteur s’appuie sur la configuration d’embedder de l’index et sur un modèle de document (documentTemplate). Lors d’une recherche hybride, Scout passe l’identifiant de l’embedder au moteur, qui peut calculer le vecteur de la requête. La documentation de la demande précise que le mode natif n’injecte pas _vectors et qu’il n’utilise pas toSearchableEmbedding() dans ce chemin.
Cette répartition est importante pour diagnostiquer un résultat. Si un document n’est pas retrouvé, la cause peut se situer dans la sélection des champs, le modèle d’embedding, le texte produit par le template, la synchronisation des réglages ou la recherche elle-même. Il ne suffit plus de chercher une fonction Laravel qui aurait construit le vecteur : dans le chemin natif, cette opération relève du moteur et de la source configurée par l’embedder.
Le mot « natif » désigne ici une intégration prise en charge par le moteur, pas nécessairement un calcul sur votre serveur. La demande de fusion montre par exemple un embedder qui utilise une source openAi, un modèle nommé et une clé d’API. C’est un exemple de configuration dans la PR, pas une prescription ni une garantie que toutes les sources ont le même traitement des données. Avant l’activation, identifiez le fournisseur réellement appelé, les textes transmis, la région, la rétention et le coût éventuel selon son offre actuelle.
Attribuer chaque décision à un propriétaire
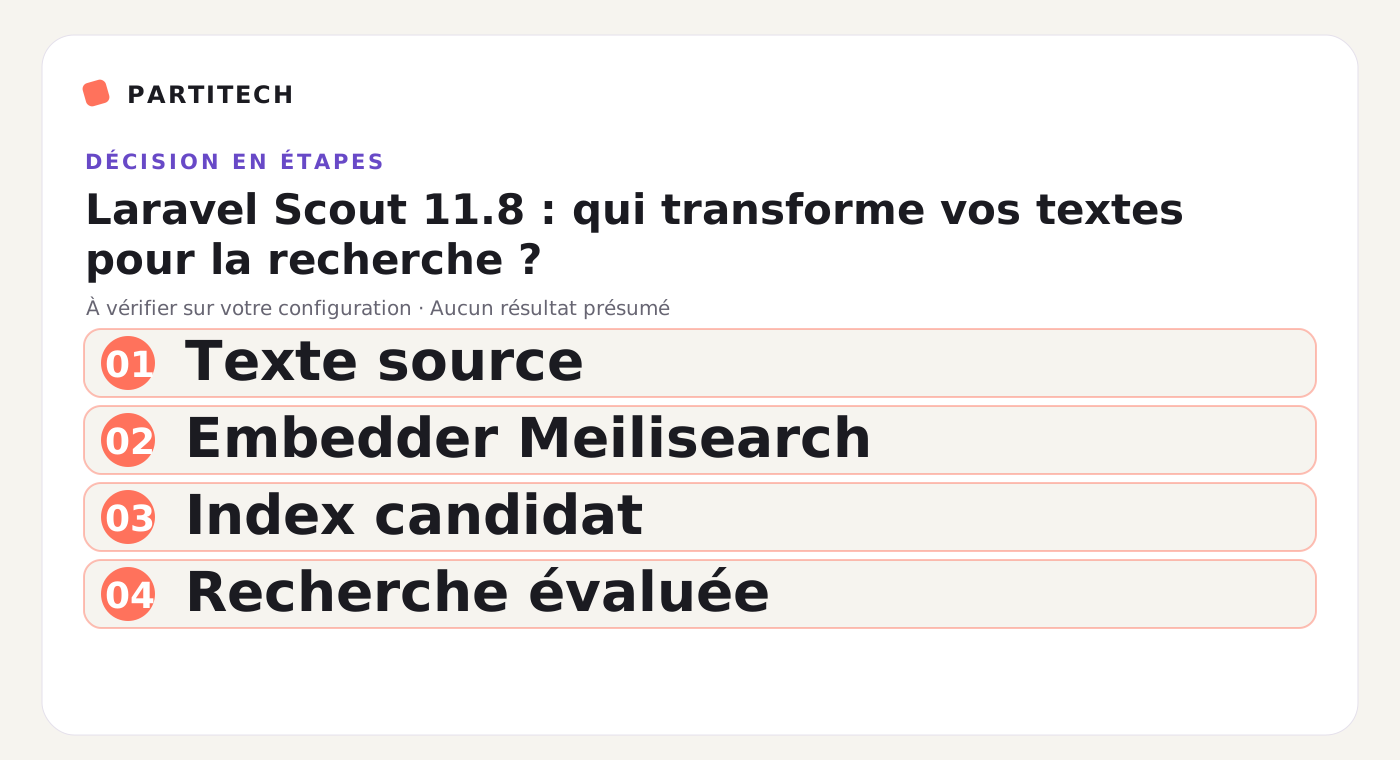
Pour chaque index, consignez au minimum : les champs envoyés, le template qui les assemble, le nom de l’embedder, sa source, le modèle choisi, les dimensions prises en charge, la version du schéma d’index et les secrets nécessaires. La PR indique que la validation native exige un embedder, mais pas un champ dimensions, car les réglages d’embedder de Meilisearch portent cette information. Ne copiez donc pas une dimension tirée d’un autre modèle ou d’une autre version sans vérifier la configuration cible.
Un template qui assemble titre et corps influence directement ce que l’embedder reçoit. Décidez si les descriptions, catégories ou attributs structurés doivent être présents, et excluez les éléments personnels ou confidentiels qui n’ont pas besoin d’être indexés. Vérifiez aussi que l’index ne mélange pas des vecteurs produits par des modèles incompatibles. Un changement de modèle peut demander une reconstruction contrôlée de l’index ; ce n’est pas une simple modification cosmétique de configuration.
Scout fournit la commande de synchronisation des réglages d’index. La PR rappelle que cette synchronisation déclenche la génération des embeddings de documents. Ne la lancez pas sur un index de production pour « voir ce qui se passe » : elle peut provoquer des traitements et des appels externes. La commande citée ici est une information documentaire, pas un essai exécuté par Partitech.
Préparer une migration réversible
Utilisez un projet de test, des textes synthétiques et un index séparé. Copiez un petit catalogue fictif : une « veste imperméable légère », une « veste de pluie pour randonnée » et des articles sans rapport. Préparez avant l’essai quelques requêtes exactes, des formulations différentes, un terme absent, et un cas qui doit être exclu selon les droits de visibilité.
Conservez d’abord la configuration et l’index actuels, puis créez un index candidat versionné. Synchronisez les paramètres uniquement dans cet environnement isolé. Contrôlez qu’un document est transformé comme prévu et que les filtres d’autorisation s’appliquent avant que les résultats ne soient montrés. Les mêmes textes, filtres et requêtes doivent servir à comparer recherche lexicale, sémantique et hybride. Notez le rang des résultats attendus, les absences de réponse pertinentes et les faux positifs. Ne transformez pas un score de test inventé en résultat.
Prévoyez la sortie avant d’entrer. Si l’index candidat échoue, l’application doit pouvoir revenir à l’index et au mécanisme précédents. Pour une bascule, documentez quel service lit quel index, comment les écritures restent synchronisées pendant la transition et à quel moment l’ancien index peut être supprimé. La suppression intervient après contrôle et sauvegarde, jamais comme étape implicite de la synchronisation.
Mesurer le travail utile, pas seulement la proximité
Une distance vectorielle ne dit pas à elle seule si la réponse aide l’utilisateur. Pour le catalogue fictif, demandez si les articles attendus sont présents, si les filtres de stock et d’accès sont respectés, et si un résultat hors sujet se glisse en tête. Un protocole de qualité peut distinguer précision des premiers résultats, couverture des réponses pertinentes et latence, tout en conservant des critères de jugement documentés. L’équipe doit décider ce qui constitue une réponse acceptable avant de lancer la comparaison.
Mesurez également le temps de réindexation, le volume envoyé à l’embedder et les coûts associés, si la source choisie est facturée. Comparez les chemins avec le même corpus et les mêmes paramètres. La recherche hybride combine des signaux lexicaux et sémantiques ; elle peut aider certains cas, mais son intérêt doit être établi sur vos requêtes. Scout 11.8 ne rend pas cette méthode nouvelle et ne fournit pas les résultats propres à votre catalogue.
La release retenue est la 11.8.0 du 22 septembre, et la fonctionnalité est décrite dans la PR fusionnée le 17 septembre. Avant d’adopter ce pilote, vérifiez les versions Scout et Meilisearch réellement installées ainsi que les réglages compatibles. La décision centrale est simple : qui possède le texte transformé, le modèle, le vecteur et son cycle de vie ? Déléguer ces opérations au moteur peut simplifier l’intégration, mais leur gouvernance change d’endroit ; elle doit rester visible, mesurable et réversible.
Sources vérifiées le 1er octobre 2026
- Laravel Scout, release v11.8.0, publiée le 22 septembre 2026 : pilote d’embeddings natifs Meilisearch.
- Laravel Scout, PR #1012 « feat(meilisearch): add native embeddings driver », fusionnée le 17 septembre 2026 : options de pilote, indexation, recherche, exigences de configuration et exemple de réglages.
- Laravel Scout, liste des releases, consultée le 1er octobre 2026 : permet de distinguer la 11.8 de la release 11.7 antérieure sur Typesense.
Le catalogue et les requêtes d’exemple sont fictifs. Aucun index, appel d’embedding ou score de pertinence n’a été exécuté pour cet article.