


Votre boîte de support reçoit trois messages : « Je ne retrouve pas ma facture », « Le téléchargement échoue » et « Pouvez-vous me présenter votre offre ? ». Avant de rédiger une réponse, il faut décider à quelle équipe les transmettre. Cette première étape est une classification : choisir une catégorie dans une liste définie. Clef, annoncé par Cloudflare le 1er octobre, invite à traiter ce choix comme une tâche à part entière. Voici comment préparer son évaluation sur un support fictif, avec des erreurs visibles et une reprise humaine.
Commencer par la décision attendue
Dans notre exemple de démonstration, les catégories sont facturation, technique et commercial. Une quatrième catégorie, hors périmètre, accueille les demandes auxquelles cette organisation ne sait pas répondre. À côté de ces catégories, l’application possède un état de traitement : accepté ou à revoir. La catégorie décrit la demande ; l’état décrit ce que vous autorisez à en faire.
Cette séparation aide à comprendre une demande ambiguë : « Mon abonnement est payé, mais je n’accède plus à mes fichiers. » Le modèle peut proposer technique, tandis que votre politique impose une vérification parce que le message concerne aussi un paiement. Vous n’avez pas besoin de forcer une seule étiquette à porter toute la complexité de l’intervention.
Définissez ce qui reste hors du premier pilote : remboursement, fermeture de compte, modification de droits ou réponse envoyée au client. Le classifieur proposé ici suggère une orientation. Il ne déclenche aucune de ces actions. Pour un premier essai, les personnes continuent à travailler normalement pendant que vous comparez les suggestions aux décisions retenues.
Ce que Cloudflare met à disposition
Dans l’annonce du 1er octobre 2026, Cloudflare présente Clef et Clef-flash comme des modèles de décision à sorties structurées, disponibles dans Workers AI. L’adaptation aux tâches clientes démarre avec un accompagnement humain ; une plateforme de fine-tuning en libre-service est annoncée pour plus tard. Le fine-tuning consiste à adapter un modèle à partir d’exemples d’une tâche particulière.
La fiche officielle Clef sur Hugging Face, consultée le 6 octobre, affiche une licence Apache-2.0 et décrit les artefacts du modèle. Cela ne démontre pas son fonctionnement sur votre matériel. La fiche contient aussi un type inhabituel dans un exemple : nous ne reprenons pas cet exemple comme un contrat d’intégration validé.
Ces informations ouvrent deux pistes d’essai à qualifier : un service hébergé ou une exécution des poids disponibles. Le choix dépend de vos contraintes de données, de votre matériel et du temps d’exploitation. Avant de promettre un essai local reproductible, il faudrait fixer la révision des artefacts, les dépendances et la configuration matérielle, puis exécuter un test. Cet article ne présente ni installation exécutée ni appel facturé.
Les comparaisons publiées dans l’annonce sont celles du fournisseur. Notre décision d’essai ne repose pas sur leur classement : le résultat intéressant serait une meilleure orientation de vos demandes, avec un coût d’erreur acceptable. Plusieurs pages du même éditeur ne constituent pas une confirmation indépendante de la qualité sur un support français.
Écrire un contrat simple pour l’application
Le contrat ci-dessous est une proposition interne Partitech, indépendante du schéma officiel de Clef. Il décrit ce que votre application doit recevoir et vérifier. Aucun nom de champ n’est présenté comme un paramètre de l’API du fournisseur.
| Élément conceptuel | Rôle dans le pilote | Vérification à prévoir |
|---|---|---|
| Identifiant de démonstration | Relier entrée et décision | Présence, unicité dans le lot |
| Texte autorisé | Contenu à classer | Non vide, taille bornée, absence de secret |
| Version des catégories | Définir les choix possibles | Version reconnue par l’application |
| Catégorie proposée | Orientation suggérée | Valeur présente dans la liste autorisée |
| Score éventuel | Aider à évaluer l’acceptation | Format attendu et interprétation documentée |
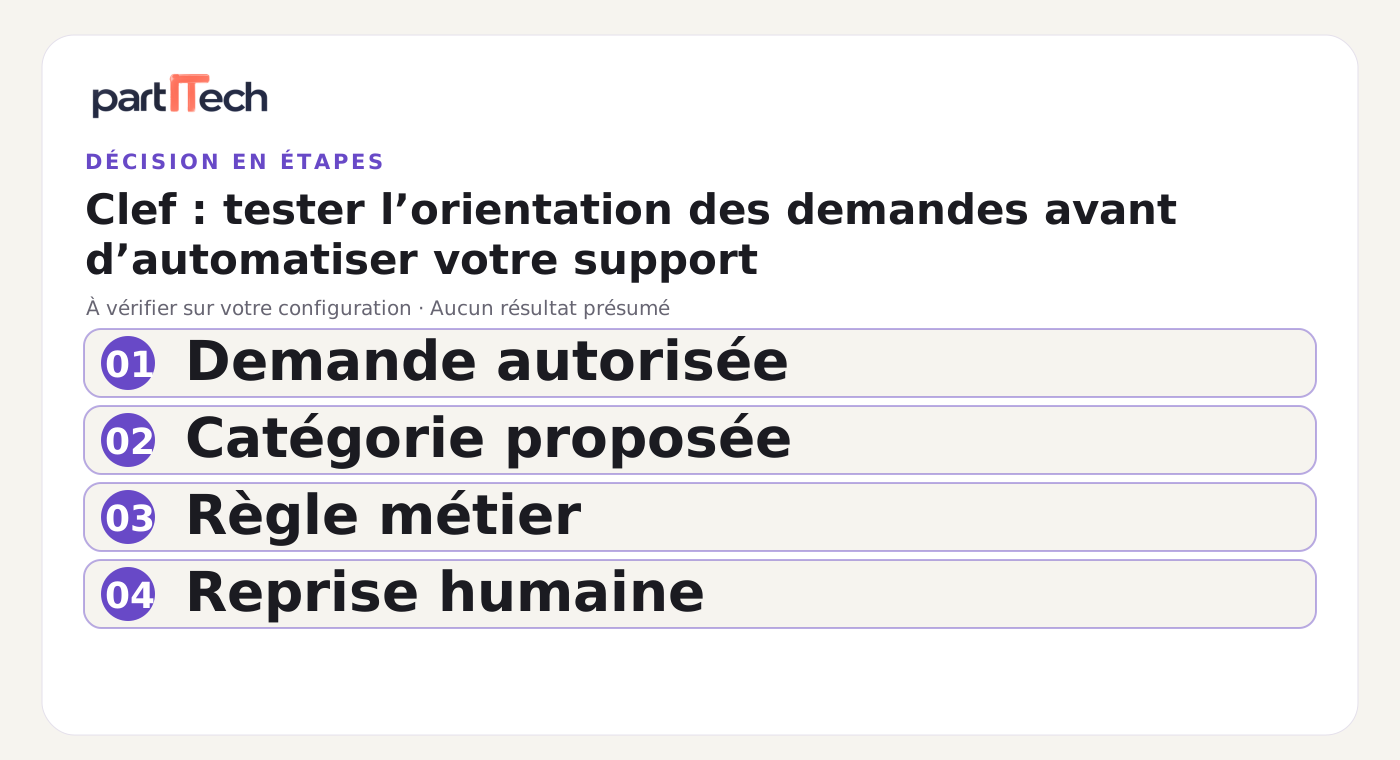
| État de traitement | Accepter ou demander une revue | Règle métier distincte du modèle |
Vous pouvez vérifier le contrat avec quelques messages synthétiques. Pour « La facture de démonstration est introuvable », l’étiquette de référence choisie pour l’exercice serait facturation. Pour « Le téléchargement de mon document de démonstration s’interrompt », elle serait technique. Un message publicitaire sans demande recevrait hors périmètre. Ces exemples servent à vérifier le câblage et les catégories ; ils ne mesurent pas la qualité sur de vrais clients.
Prévoyez des cas de rejet : texte absent, catégorie inconnue, score illisible, réponse incomplète et délai dépassé. Le comportement attendu est une reprise humaine ou un échec explicite, jamais une orientation silencieuse vers une catégorie par défaut. Une réponse bien formée peut encore contenir une mauvaise décision ; les contrôles de format et de qualité restent séparés.
Constituer un jeu de test qui révèle les erreurs
Le protocole suivant est proposé par Partitech et n’a pas été exécuté. Commencez par une consigne d’annotation : que signifie chaque classe, comment traiter les messages à plusieurs sujets et quand retenir hors périmètre ? Faites relire les cas ambigus par une seconde personne. Si les annotateurs ne s’accordent pas, le modèle ne peut pas résoudre à lui seul l’imprécision de votre organisation.
Séparez ensuite trois usages des données. Un lot sert éventuellement à adapter le modèle. Un autre sert à choisir les réglages et seuils. Le jeu de test final reste gelé jusqu’à la comparaison. Si vous ajustez une consigne après avoir vu ses erreurs sur ce dernier jeu, il devient un jeu de développement ; préparez alors une nouvelle évaluation indépendante.
Évitez aussi les copies entre lots : deux messages d’un même fil, un modèle d’e-mail reproduit ou des variantes quasi identiques peuvent donner une impression de généralisation. Pour notre support fictif, une séparation par conversation et une revue des doublons seraient des contrôles pertinents. Gardez les messages autorisés, minimisez les informations identifiantes et n’envoyez aucune donnée cliente sans cadre déjà établi.
Incluez les difficultés réelles : phrases très courtes, français approximatif, demandes mêlant deux sujets et vocabulaire nouveau. Conservez leur fréquence et leur nature. Vous pourrez ainsi expliquer si une méthode réussit surtout les demandes évidentes et reporte toutes les autres vers une personne.
Compter les erreurs selon leurs conséquences
Une matrice de confusion est un tableau qui croise la catégorie attendue avec celle proposée. Elle permet de voir où le système se trompe. Dans notre exemple, classer une demande commerciale en technique fait perdre du temps ; classer un problème d’accès en commercial peut retarder davantage sa résolution. Le même nombre d’erreurs ne produit donc pas le même coût métier.
Définissez ce coût avec les personnes qui traitent les demandes. Pour le pilote, vous pourriez compter le nombre de réaffectations, le temps de revue et les cas urgents mal orientés. Si vous utilisez un barème chiffré, indiquez qu’il s’agit d’un choix de votre équipe et conservez ses raisons. Une pondération décidée après avoir vu les résultats favorables rendrait la comparaison difficile à défendre.
Un score élevé ne signifie pas automatiquement « décision fiable ». La calibration décrit l’accord entre un niveau de confiance annoncé et la fréquence des décisions correctes dans des cas comparables. Pour la vérifier, regroupez les décisions par intervalles de score, comptez les cas et comparez confiance et correction observée. Un intervalle avec très peu d’exemples apporte peu d’information : affichez son effectif plutôt que lui donner un verdict net.
L’abstention mérite également une mesure. Si vous exigez une revue pour tous les messages difficiles, les orientations acceptées peuvent sembler excellentes alors que l’équipe humaine conserve l’essentiel du travail. Comptez la part des demandes acceptées, la part à revoir et le temps de reprise. Examinez les résultats par catégorie et par type de difficulté.
Comparer avant d’adapter
Votre point de départ, appelé baseline, peut être une règle simple : quelques termes de facturation, une liste d’erreurs techniques et une reprise en cas de conflit. Ajoutez si utile un modèle généraliste avec une sortie bornée. Comparez ces solutions à Clef sur les mêmes entrées, avec les mêmes catégories et les mêmes règles de validation. Une adaptation spécialisée ne se justifie qu’après cette comparaison.
| Mesure proposée | Règles simples | Modèle généraliste | Clef | Clef-flash |
|---|---|---|---|---|
| Erreurs par catégorie | À mesurer | À mesurer | À mesurer | À mesurer |
| Coût métier des erreurs | À mesurer | À mesurer | À mesurer | À mesurer |
| Part à revoir | À mesurer | À mesurer | À mesurer | À mesurer |
| Délai de réponse | À mesurer | À mesurer | À mesurer | À mesurer |
| Coût et temps de reprise | À mesurer | À mesurer | À mesurer | À mesurer |
Mesurez le délai du parcours complet, y compris validation et reprise éventuelle. Notez la configuration, la version du modèle et la date. Ne remplacez pas une case vide par un résultat de l’annonce : ce tableau doit décrire votre essai. Une solution plus rapide à prédire peut rester moins utile si elle demande davantage de corrections.
Autoriser un pilote que l’on peut arrêter
Commencez en observation, sans modifier automatiquement les files de support. Comparez suggestion et orientation humaine, puis examinez les désaccords. Ils peuvent révéler une erreur du modèle, une mauvaise référence ou une catégorie à préciser. Réglez ces causes avant de recommencer un test avec un protocole explicite.
Décidez à l’avance les critères d’acceptation : erreurs critiques tolérées, charge de revue maximale et catégories couvertes. Prévoyez un retour immédiat au traitement humain si les sorties deviennent invalides, si les erreurs critiques augmentent ou si le vocabulaire change fortement. Pour cet exemple, la prochaine étape utile est donc de stabiliser les catégories et le jeu de test. Le choix du modèle vient après ce contrat métier.
Sources et date de vérification
Pages primaires rouvertes et lues le 6 octobre 2026 : Cloudflare, lancement de Clef, 1er octobre ; Cloudflare, fiche officielle Clef sur Hugging Face. Le corpus synthétique, les contrats et les tableaux sont des propositions Partitech. Aucun benchmark propre, entraînement ou appel hébergé n’a été réalisé pour cet article.