La page de catalogue ralentit après une livraison. Une alerte remonte, vingt minutes après le premier écart. Vous avez les courbes de temps de réponse et l’heure du déploiement. Il vous manque encore la preuve que le code livré explique le ralentissement.
Ce qu’OpenAI a décrit le 19 novembre
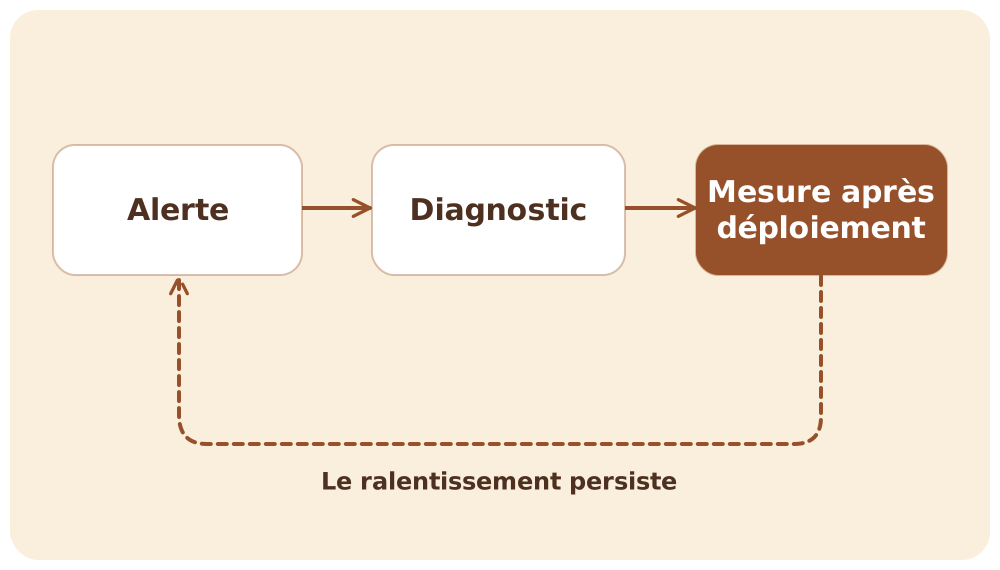
Dans son retour d’expérience, OpenAI présente Performance Factory, un système interne qui crée une tâche à partir d’une alerte, la confie à Codex et garde les résultats dans un service de tâches. Les agents peuvent relever les indices, contester un diagnostic et ouvrir une proposition de correctif. Un ingénieur décide de la fusion et du déploiement. Le système vérifie ensuite le rétablissement et reprend l’enquête si le ralentissement persiste.
Lors d’une revue manuelle de 100 propositions de cause, OpenAI en a jugé 70 % exactes. Les autres demandaient un approfondissement ou une preuve de causalité. Ce chiffre décrit les propositions examinées par l’équipe et motive une vérification dédiée du diagnostic.
Rejouer deux alertes de catalogue
- Montez un service de test et enregistrez un jeu de traces synthétiques comprenant l’instant de référence, la durée et une catégorie de requêtes. Ajoutez une première alerte causée par un appel répétitif introduit volontairement, puis une seconde où seule la composition du trafic change.
- Donnez les mêmes données à l’agent d’analyse et à votre méthode habituelle. Demandez la première fenêtre où le changement est mesurable, un groupe de requêtes comparable avant et après et une explication alternative. Le 95e percentile indique une durée sous laquelle se trouvent environ 95 % des réponses.
- Faites relire les traces, puis déployez le correctif approuvé en préproduction. Rejouez le premier trafic sans changer sa composition. Contrôlez les erreurs et le temps de réponse sur la même fenêtre. La deuxième alerte doit conduire à un diagnostic sur le trafic, sans changement de code injustifié.
L’agent peut préparer les preuves et la proposition avec des droits de lecture. La fusion et la mise en service restent des étapes sous contrôle de l’équipe. Un journal de tâche suffit pour commencer, avec trois champs obligatoires : les éléments à l’appui de la cause, la décision de revue et la mesure après essai.